2.5. 使用KNN与MeanShift实战
本文接续 2.3. K均值聚类(KMeans Analysis)实战(基础) 和 2.4. K均值聚类(KMeans Analysis)实战(进阶), 没看过的建议先看。
重要区分: KNN(KNeighborsClassifier)是有监督分类算法——训练时需要标签 y。MeanShift 是无监督聚类——不使用标签。把两者放在同一篇文章里是为了对照(另见 2.2),并不是因为 KNN 属于聚类方法。
2.5.1. 一些准备工作
接下来,请你确保你的Python环境中有pandas、matplotlib、scikit-learn和numpy这几个包,如果没有,请在终端输入指令以下载和安装:
pip install pandas matplotlib scikit-learn numpy
我把.csv数据文件放在GitCode上了,点击链接即可下载。
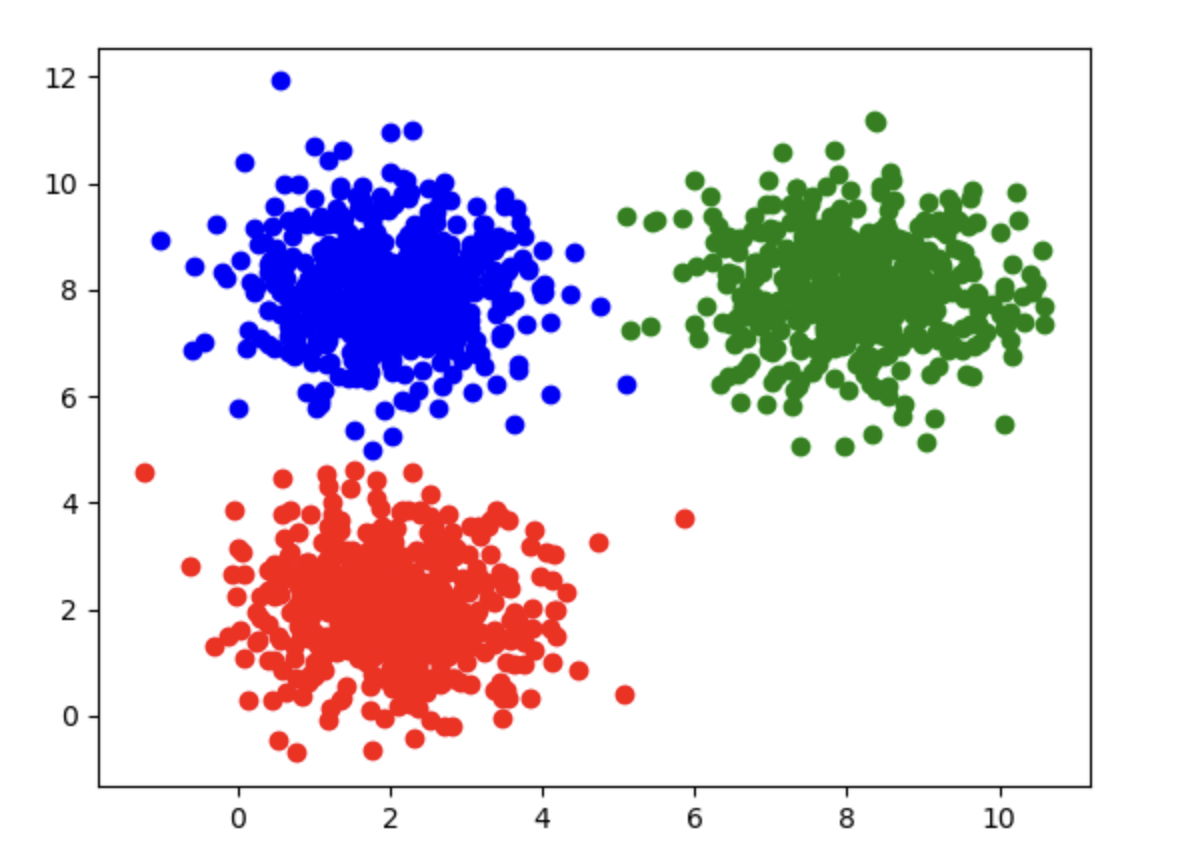
训练数据有3栏:x1、x2和label,x1和x2是两个输入变量,label是标签(0,1,2其中一个)。KNN 会同时使用特征和标签;MeanShift 只使用特征。这些数据在特征空间中形成三个自然分组。
下载好后把它移到你的Python项目文件夹里即可。
2.5.2. 用KNN做分类(有监督;不是聚类)
Step 1: 读取数据
一样的使用pandas库来读取csv文件,顺便使用head方法来查看一下数据的前几项:
# 读取数据
import pandas as pd
data = pd.read_csv('KMeans_Data.csv')

print(data.head())
输出:
         x1        x2  label
0  2.496714  2.926178      0
1  1.861736  3.909417      0
2  2.647689  0.601432      0
3  3.523030  2.562969      0
4  1.765847  1.349357      0
其散点分布如图所示:
Step 2: 给x和y赋值
# 给x和y赋值
x = data.drop(['label'], axis=1)
y = data.loc[:,'label']
Step 3: 训练模型
把特征和标签喂给scikit-learn下的KNN分类器进行训练:
# 训练模型
from sklearn.neighbors import KNeighborsClassifier
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(x, y)
n_neighbors是KNN中指定的K值(详见 2.2. 聚类分析算法理论)- 与 KMeans/MeanShift 不同,KNN 训练时使用标签:
fit(x, y)
Step 4: 获取预测值
训练完成后,可以随便找一个点看KNN模型会给它分到哪一类:
# 一个小测
y_predict = knn.predict([[10, 10]])
print(y_predict)
输出:
[1]
Step 5: 计算准确率
# 计算准确率
from sklearn.metrics import accuracy_score
y_predict = knn.predict(x)
print(accuracy_score(y, y_predict))
输出:
1.0
因为 KNN 是有监督的,并且用 label 进行了训练,其预测类别 ID 在设计上就与 label 对齐(这里训练集准确率为 1.0)。这与 KMeans/MeanShift 不同:后者的簇编号是任意的,与 label 比较前可能需要重映射(见 2.4)。
2.5.3. MeanShift实现聚类分析
Step 1: 读取数据
与上文相同,这里不再重复。
Step 2: 给x和y赋值
与上文相同,这里不再重复。MeanShift 只需要 x;y 仅在后面评估时使用。
Step 3: 训练模型
把数据喂给scikit-learn下的MeanShift模型进行训练即可:
# 训练模型
from sklearn.cluster import MeanShift, estimate_bandwidth
bandwidth = estimate_bandwidth(x, quantile=0.3)

model = MeanShift(bandwidth=bandwidth)
model.fit(x)
estimate_bandwidth(x, quantile=0.3)用于根据数据估计带宽,再传入MeanShift(bandwidth=bandwidth)。quantile控制带宽大小(与 sklearn 在MeanShift(bandwidth=None)时默认估计带宽的方式一致)。也可以传入n_samples用子样本来估计(详见 2.2. 聚类分析算法理论)。
Step 4: 获取预测值
# 获取预测值
y_predict = model.predict(x)
Step 5: 计算准确率
# 计算准确率
from sklearn.metrics import accuracy_score
print(accuracy_score(y, y_predict))
输出:
0.9986666666666667
这说明我们的模型效果非常好,准确率非常接近百分百。
还是强调一下MeanShift模型本身不知道label,所以它的划分是随意的,虽然也会分为3类,但MeanShift划分的0、1、2类不一定和label的0、1、2类一一对应。
这里只是凑巧一一对应上了,如果你发现正确率异常的低,大概率是标签没对上。
如果你需要校正标签,详见 2.4. K均值聚类(KMeans Analysis)实战(进阶)。