2.4. K均值聚类(KMeans Analysis)实战(进阶)
本文紧承上文 2.3. K均值聚类(KMeans Analysis)实战(基础) ,如果没有看请先看上一篇文章。
2.4.1. 获取预测值
我们得先获取预测值,然后用预测值与label的标签比较:
# 获取预测值
y_predict = kmeans.predict(x)
2.4.2. 与原数据对比与校正
获得了预测值以后我们就要根据label的值来对比计算准确率了:
# 计算准确率
from sklearn.metrics import accuracy_score
print(accuracy_score(y, y_predict))
输出:
0.332
但是为什么准确率这么低呢?看图明明分类分的挺好的。
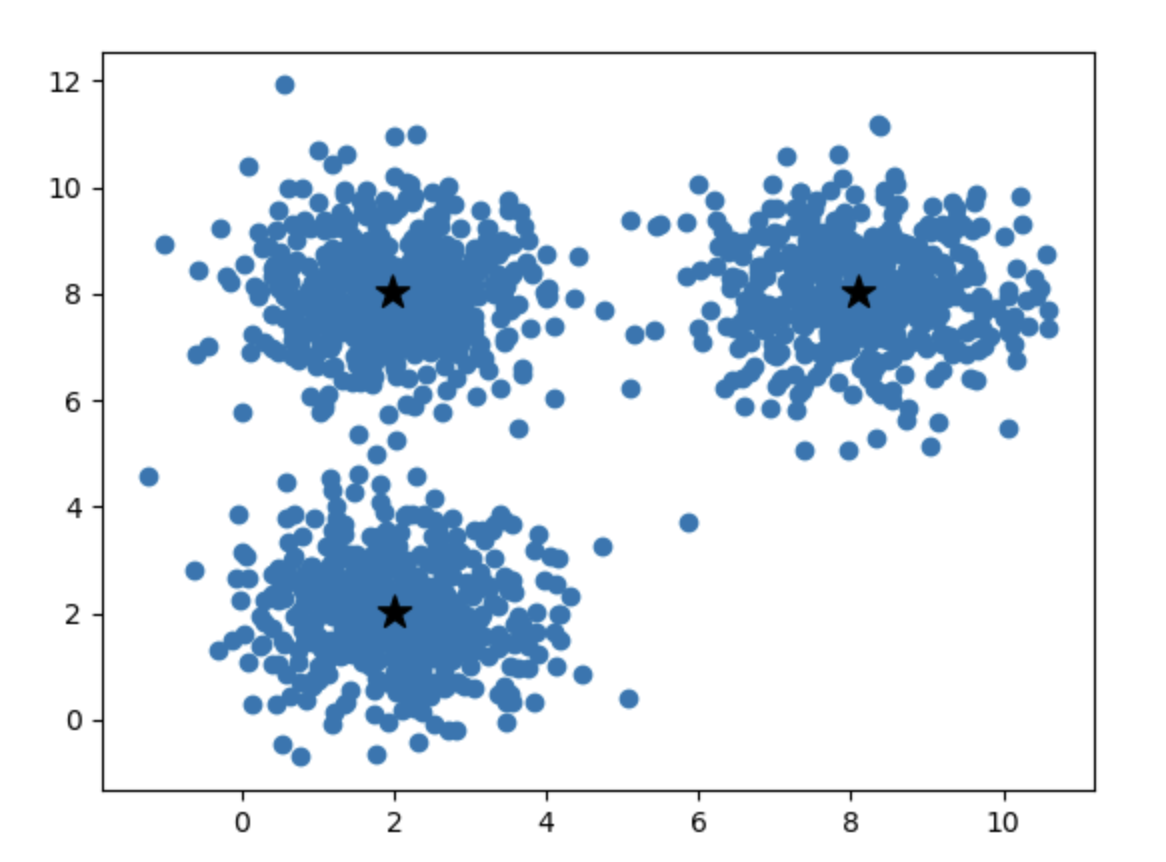
这是因为我们还有一个问题没解决,其实在上一篇文章的末尾我就提到过:
KMeans划分的0、1、2类与label的0、1、2类不一样。KMeans模型本身不知道label,所以它的划分是随意的,虽然也会分为3类,但KMeans划分的0、1、2类不一定和label的0、1、2类一一对应。
这就导致了明明类分对了但是因为标签不同被视为错误。如何解决这个问题呢?一般来说我们可以通过数据的分布来分析:
label中散点数量最多的簇肯定对应预测结果中散点数量最多的簇,label中散点数量最少的簇肯定对应预测结果中散点数量最少的簇。
依此我们就可以把label的分类和模型的分类一一对应上。
那我们如何看数据的分布情况呢?pandas库提供了value_counts方法:
# 查看数据分布
print(pd.value_counts(y_predict))
print(pd.value_counts(y))
输出:
1    501
0    501
2    498
Name: count, dtype: int64
label
0    500
1    500
2    500
Name: count, dtype: int64
你会发现这些数据分布都太接近了,根本就分不出来。所以我们得放弃这个思路。
当然大部分时候这个思路都是有效的,只是我们这里情况特殊。
我们还可以通过画图来展现这个问题:
# 画图
import matplotlib.pyplot as plt
# 画原分类
fig1 = plt.subplot(1, 2, 1)
x1 = data.loc[:, "x1"]
x2 = data.loc[:, "x2"]
label = data.loc[:, "label"]

class0 = (label == 0)
class1 = (label == 1)
class2 = (label == 2)

fig1.scatter(x1[class0], x2[class0], c='r')
fig1.scatter(x1[class1], x2[class1], c='g')
fig1.scatter(x1[class2], x2[class2], c='b')

fig1.set_title("Actual Classification")

# 画模型的分类
fig2 = plt.subplot(1, 2, 2)
predicted_class0 = (y_predict == 0)
predicted_class1 = (y_predict == 1)
predicted_class2 = (y_predict == 2)

fig2.scatter(x1[predicted_class0], x2[predicted_class0], c='r')
fig2.scatter(x1[predicted_class1], x2[predicted_class1], c='g')
fig2.scatter(x1[predicted_class2], x2[predicted_class2], c='b')

fig2.scatter(centers[:, 0], centers[:, 1], c='black', s=100, marker='x', label='Centers')

fig2.set_title("KMeans Classification")

# 显示整个画布
plt.show()
图片输出:
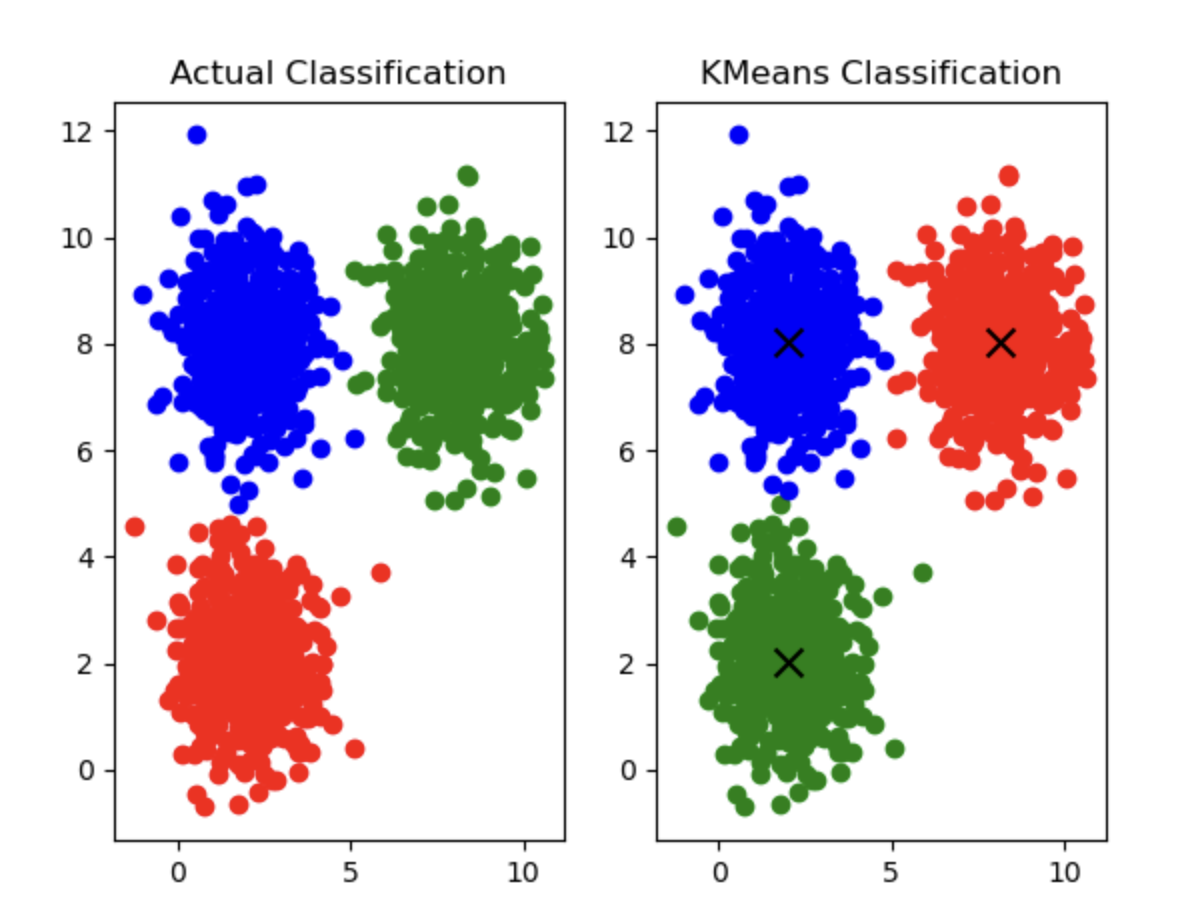
可以看到,是红色和绿色的部分颠倒了,对应KMeans的0标签和1标签反了。所以我们只需要校正这部分即可:
# 校正标签
y_correct = []
for i in y_predict:
    if i == 0:
        y_correct.append(1)
    elif i == 1:
        y_correct.append(0)
    else:
        y_correct.append(2)
- 通过遍历并创建新的数组来校正标签。
- 如果原本是0,在新的数组里就是1;如果原本是1,在新的数组里就是0;其余不变,保持2。
2.4.3. 计算正确的正确率
这下的正确率就应该提高了:
# 计算正确率
from sklearn import metrics
print(metrics.accuracy_score(y, y_correct))
输出:
0.9986666666666667
这就对了。