2.3. K均值聚类(KMeans Analysis)实战(基础)
2.3.1. 一些准备工作
接下来,请你确保你的Python环境中有pandas、matplotlib、scikit-learn和numpy这几个包,如果没有,请在终端输入指令以下载和安装:
pip install pandas matplotlib scikit-learn numpy
我把.csv数据文件放在GitCode上了,点击链接即可下载。
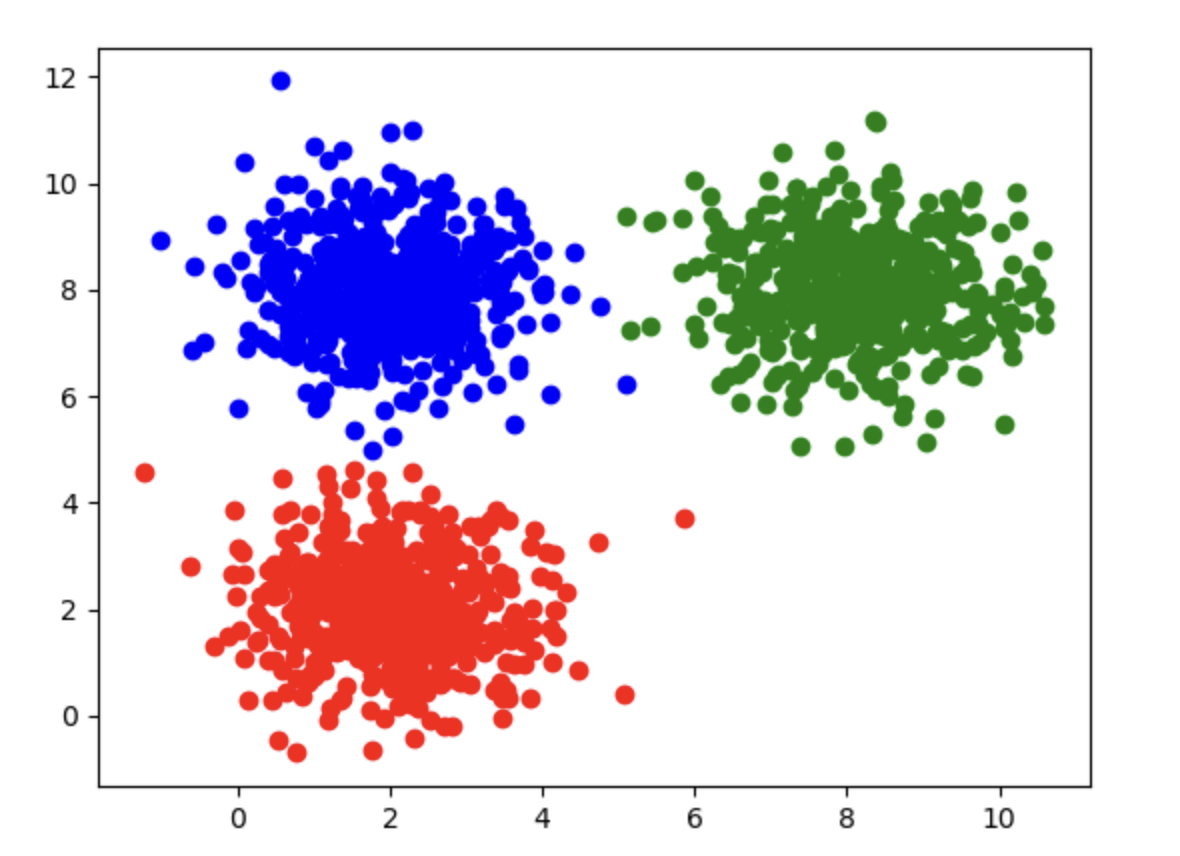
训练数据有3栏:x1, x2和label,x1和x2是两个输入变量,label是标签(0,1,2其中一个),这些数据会用来训练KMeans模型(当然不会给它label信息),数据最后会被分为3个簇,每个簇都有自己的label值。
下载好后把它移到你的Python项目文件夹里即可。
2.3.2. 写代码
Step 1: 读取数据
一样的使用pandas库来读取csv文件,顺便使用head方法来查看一下数据的前几项:
# 读取数据
import pandas as pd
data = pd.read_csv('KMeans_Data.csv')

print(data.head())
输出:
         x1        x2  label
0  2.496714  2.926178      0
1  1.861736  3.909417      0
2  2.647689  0.601432      0
3  3.523030  2.562969      0
4  1.765847  1.349357      0
我们还可以使用 1.8. 逻辑回归实战(基础) 中教过的画有分类的散点图方法来直观的看看数据:
# 可视化数据
import matplotlib.pyplot as plt
x1 = data.loc[:,"x1"]
x2 = data.loc[:,"x2"]
label = data.loc[:,"label"]

class0 = (label == 0)
class1 = (label == 1)
class2 = (label == 2)

plt.scatter(x1[class0],x2[class0],c='r')
plt.scatter(x1[class1],x2[class1],c='g')
plt.scatter(x1[class2],x2[class2],c='b')
plt.show()
图片输出:
Step 2: 给x和y赋值
我们要首先明确x和y代表什么:
x代表输入变量,也就是x1和x2y是label这一栏的数据
# 给x和y赋值
x = data.drop(['label'], axis=1)
y = data.loc[:,'label']
- 使用
drop函数丢弃指定的字段,保留其它字段。这里写的是'label',那就丢弃它,axis=1告诉程序丢弃的是'label'这一列而不是行。
Step 3: 训练模型
把数据喂给scikit-learn下的KMeans模型进行训练即可:
# 训练模型
from sklearn.cluster import KMeans
kmeans = KMeans(n_clusters=3, random_state=0)
kmeans.fit(x)
KMeans有两个参数:n_clusters决定最后归类为几个簇,我这里填的3最后就会归为3个簇random_state=0的作用是保证 KMeans模型每次运行时生成的中心初始化相同(sklearn 默认的init是'k-means++',其中的随机性仍由random_state控制)- 如果你将
random_state设置为其他值,例如random_state=42或random_state=1,算法逻辑不变,但初始中心可能不同,因此聚类结果也可能不同
Step 4: 获取聚类中心
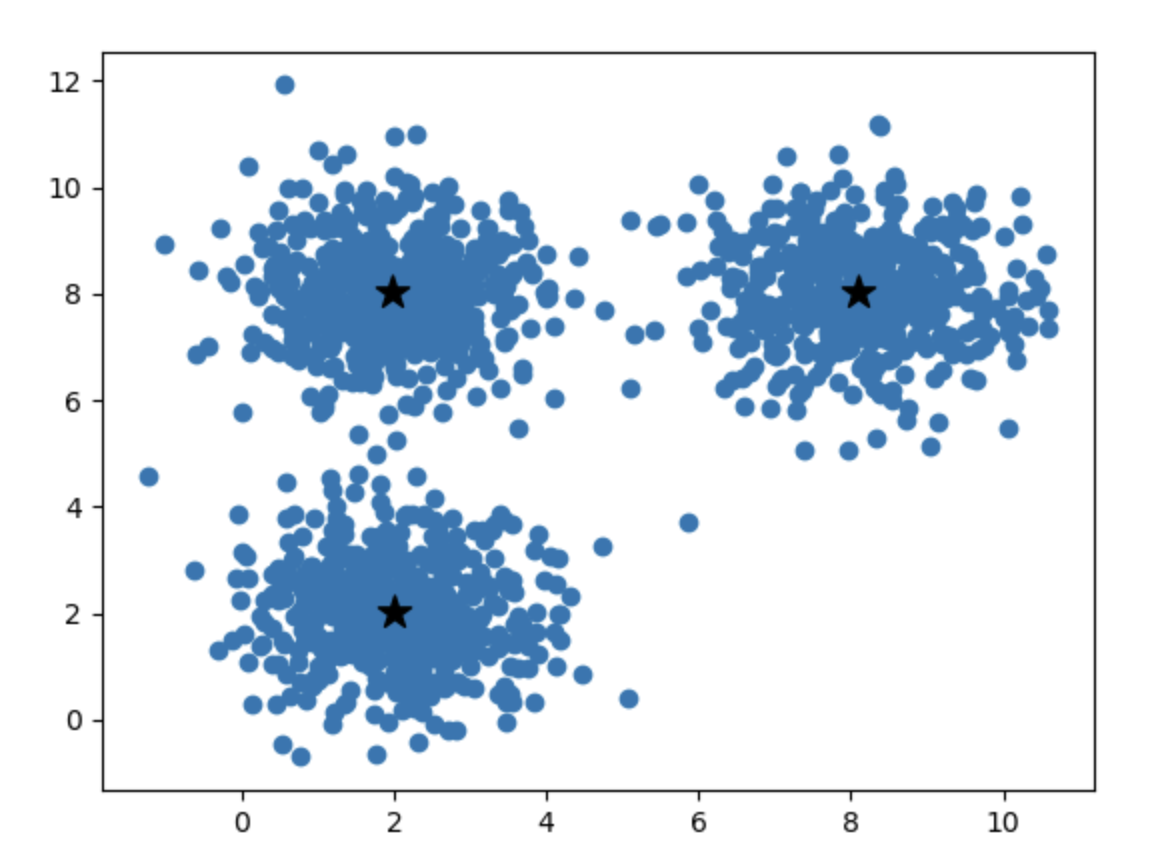
通过cluster_centers_属性可以获得计算出的聚类中心:
# 获取聚类中心
centers = kmeans.cluster_centers_
print(centers)
输出:
[[8.10249937 8.0295763 ]
 [2.00635647 2.03776831]
 [1.98266327 8.03285096]]
Step 5: 可视化聚类中心
我们可以通过matplotlib来可视化聚类中心:
# 可视化聚类中心
import matplotlib.pyplot as plt

x1 = data.loc[:, "x1"]
x2 = data.loc[:, "x2"]
label = data.loc[:, "label"]

plt.scatter(x1, x2)

plt.scatter(centers[:, 0], centers[:, 1], c='k', marker='*', s=150)
plt.show()
输出图片:
Step 6: 获取预测值
既然已经完成分类了,那么我们可以随便找一个点看KMeans模型会给它分到哪一类:
# 一个小测
y_predict = kmeans.predict([[10, 10]])
print(y_predict)
输出:
[0]
KMeans给它分到了第0类,但是$(10,10)$是右上角的位置应该是label的第1类啊?为什么呢?
这是因为KMeans划分的0、1、2类与label的0、1、2类不一样。
KMeans模型本身不知道label,所以它的划分是随意的,虽然也会分为3类,但KMeans划分的0、1、2类不一定和label的0、1、2类一一对应。
在下一篇文章中我们会解决这个问题。