0.1. 环境配置
这篇文章会带你搭好本课程需要的环境:Python、Anaconda(conda)、Jupyter Notebook、以及 PyCharm。如果你已经有可用的 conda 环境,并且能正常打开 Notebook,可以直接进入 0.2。
本文覆盖 Windows、macOS、Linux。安装步骤按系统分开写;装好之后的 conda / Jupyter / PyCharm 操作基本通用。
0.1.1. 你需要什么
| 工具 | 作用 |
|---|---|
| Python | 本课程使用的语言。建议 3.11 或 3.12(不要再用已停止维护的旧版本,例如 3.8)。 |
| Anaconda | 自带 Python、conda 和大量科学计算相关组件的安装包,适合入门。 |
| Jupyter Notebook | 浏览器里的交互式笔记本,方便边写代码边做笔记。 |
| PyCharm | 编辑器 / IDE,可以把 conda 环境当作项目解释器。 |
还需要单独去 python.org 装一份 Python 吗?
一般 不需要。Anaconda 已经包含 Python。按本课程的路径,安装 Anaconda,再建一个带 Python 3.11 或 3.12 的环境即可。单独安装 python.org 版本是可选的(做非 conda 项目时有时方便);若在 Windows 上安装,请勾选 Add python.exe to PATH。
Anaconda 与 Miniconda: Anaconda 体积更大、对新手更友好;Miniconda 更轻,主要提供 conda。两者都能用;本文默认使用 Anaconda。
0.1.2. 安装 Anaconda
下载(各系统通用)
- 打开官方下载页:https://www.anaconda.com/download。
- 按你的操作系统下载对应安装包(Windows / macOS / Linux)。页面通常会推荐合适版本;在 macOS 上请选择 Apple Silicon 或 Intel,与本机芯片一致。

下载前可能会要求填写邮箱,这不是拿到安装包的必要条件。优先使用 Anaconda 官方站点;除非你清楚自己在做什么,否则不要随便用不明来源的第三方包。
Windows
- 运行下载好的
.exe安装程序。 - 没有特殊需求就保持默认选项;需要时再改安装路径。
- 初学者建议用开始菜单里的 Anaconda Prompt 或 Anaconda PowerShell Prompt 执行 conda 命令(不必强行把 Anaconda 加进系统
PATH)。 - 验证安装:打开 Anaconda Prompt,执行:
conda --version

若 Anaconda 装在 C:\Program Files 等受保护目录,创建环境或装包时请以管理员身份打开 Anaconda Prompt,或者一开始就装到用户可写目录。
macOS
- 运行下载好的安装程序(
.pkg,或按官网说明使用 shell 安装脚本)。 - 安装结束后打开 终端(Terminal),为当前 shell 初始化 conda(多数 Mac 使用 zsh):
conda init zsh
完全关闭终端再重新打开,然后检查:
conda --version
Apple Silicon 与 Intel: 安装包架构必须与本机一致(苹果菜单 → 关于本机)。装错架构,后面装包时容易出现难排查的错误。
Linux
- 同样从官网下载 Linux 安装脚本(
.sh)。 - 在终端里用
bash运行(文件名含版本号,按实际为准):
bash ~/Downloads/Anaconda3-*.sh
- 接受许可协议,选择安装路径(默认装在用户主目录即可),并在提示时允许为当前 shell 执行
conda init。 - 关闭并重新打开终端,执行:
conda --version
请使用官方 .sh 安装脚本,不要随便用发行版里来历不明的 apt / dnf / pacman 包,除非你已经了解它们的维护方式。通常不要用 sudo 运行 Anaconda 安装脚本。
0.1.3. 用 Anaconda 新建开发环境(建议)
不要把课程用到的包全部塞进 base。单独建一个环境更干净:
Windows: Anaconda Prompt(或 Anaconda PowerShell Prompt)。
macOS / Linux: 终端(完成 conda init 之后)。
conda create -n machine_learning python=3.12
- 把
machine_learning换成你喜欢的名字,只能用英文。 - 若更想用 3.11,写成
python=3.11即可;本课程两者都可用。
出现是否继续的提示时,输入 y 回车。然后激活环境:
conda activate machine_learning
命令行提示符应出现环境名(例如 (machine_learning)),而不只是 (base)。
(base) user@hostname ~ % conda activate machine_learning
(machine_learning) user@hostname ~ %
常用检查命令:
conda env list
python --version
(base) user@hostname ~ % conda env list

# conda environments:
#
base                  * /opt/anaconda3
machine_learning        /opt/anaconda3/envs/machine_learning
当前环境会在路径前标 *。
也可以启动 Python 交互环境,确认解释器能正常响应:
(base) user@hostname ~ % python
Python 3.12.2 | packaged by conda-forge | (main, Feb 16 2024, 20:54:21) [Clang 16.0.6 ] on darwin
Type "help", "copyright", "credits" or "license" for more information.
>>>
0.1.4. 安装和打开 Jupyter Notebook
先激活你的课程环境,再安装:
pip install notebook
如果下载较慢,可改用国内镜像(清华源示例):
pip install notebook -i https://pypi.tuna.tsinghua.edu.cn/simple
启动 Notebook:
jupyter notebook
浏览器应自动打开。若要打开指定项目目录,先 cd 进去再启动:
cd /path/to/your/project
jupyter notebook

当前 pip install notebook 默认安装的是 Notebook 7+。主题 / 深色模式可在 Notebook 界面的设置里切换,本课程不需要再装第三方主题包。
matplotlib、NumPy、pandas 的安装与试运行见 0.2——环境能跑起来后请接着做那一篇。
0.1.5. PyCharm + Anaconda
目前对新手比较友好的 Python IDE 之一是 JetBrains 的 PyCharm。从 PyCharm 2025.1 起,JetBrains 提供统一的 PyCharm 产品:从官网下载即可;可先试用 Pro 功能,试用结束后可继续免费使用核心功能(已包含 Jupyter 支持),也可订阅 Pro。
- 按操作系统下载并安装 PyCharm,安装选项保持默认即可。
- 打开 PyCharm → 新建项目。
- 解释器选择 conda 相关选项(例如 基础 conda,或指向你创建的
machine_learning环境)。

之后也可在 设置 里搜索 Python 解释器 再改:

在 PyCharm 中新建 Notebook
项目已使用 conda 解释器时,可直接在 IDE 里新建 Jupyter Notebook(例如 新建 → Jupyter Notebook)。

0.1.6. 快速自检
进入下一篇之前,你应能做到:
- 在 Anaconda Prompt(Windows)或终端(macOS / Linux)里运行
conda --version。 conda activate你的课程环境,并且python --version显示 3.11 或 3.12。- 运行
jupyter notebook并打开浏览器界面。 - (可选)在 PyCharm 中新建项目,并选用该 conda 环境。
下一篇:0.2. 下载、安装和试运行需要的包(matplotlib、NumPy、pandas)。
0.2. 下载、安装和试运行需要的包 matplotlib、numpy和pandas
0.2.1. 安装matplotlib和试运行
你需要先下载并安装Anaconda(安装教程在上一篇文章 0.1. 环境配置)。
Step 1:切换环境(可选)
如果你需要把包安装在你指定的环境的话,你得先手动切换到那个环境去
在MacOS上,打开终端;在Windows上,打开Anaconda Prompt或者Anaconda Powershell Prompt(注意:如果你把Anaconda下载在C盘那就得以管理员身份打开,不然有可能在后续的操作中报错),接着输入:
conda env list
- 这个命令可以帮助你查看的电脑上有哪些环境和你现在处在什么环境
(base) user@hostname ~ % conda env list

# conda environments:
#
base                  * /opt/anaconda3
machine_learning        /opt/anaconda3/envs/machine_learning
- 路径前面带了
*就是你当前所处的环境
如果你想要切换环境,可以使用这个指令:
conda activate 指定的环境名
(base) user@hostname ~ % conda activate machine_learning
(machine_learning) user@hostname ~ %
- 看到命令行的前缀变成了你要的环境名就对了
Step 2:下载并安装
使用pip指令就可以下载了:
pip install matplotlib
如果你身处国内,下载速度慢,那可以换用国内镜像源。这里我推荐清华的镜像源:
pip install matplotlib -i https://pypi.tuna.tsinghua.edu.cn/simple
注意:由于numpy是matplotlib的依赖,所以安装matplotlib时就会自动安装numpy。我们就不需要专门输入命令安装numpy了
Step 3:试运行
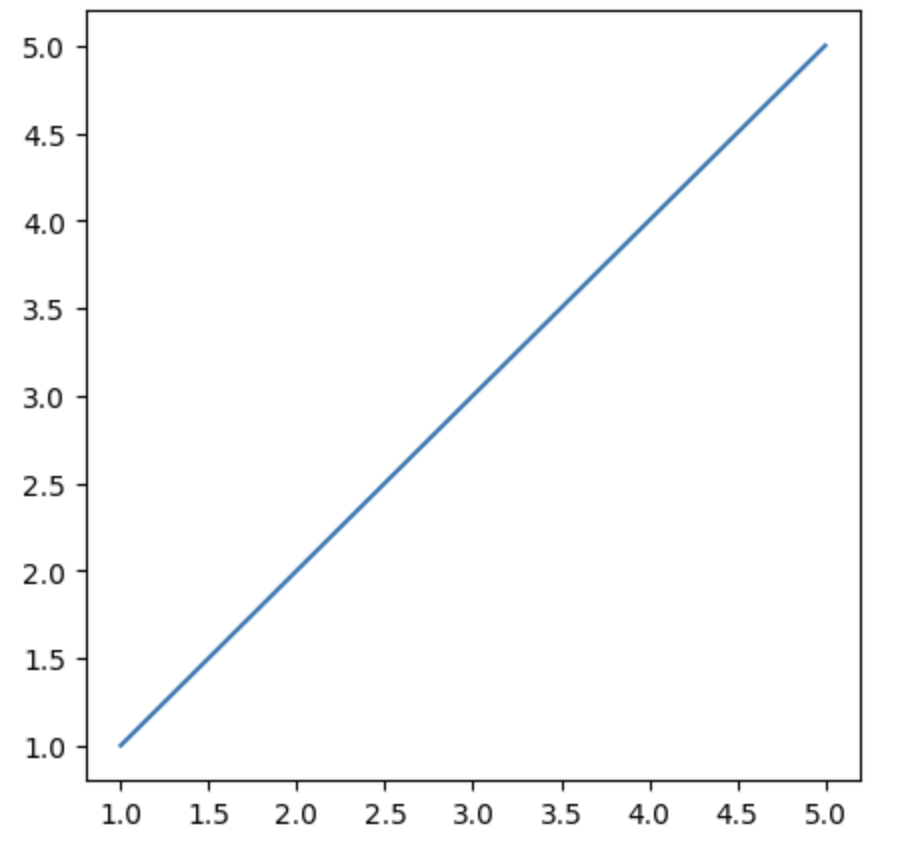
接下来我们可以在代码中运用一下matplotlib来看看有没有安装好:
import matplotlib
from matplotlib import pyplot as plt

x = [1, 2, 3, 4, 5]
y = [1, 2, 3, 4, 5]

fig1 = plt.figure(figsize = (5, 5))
plt.plot(x,y)
plt.show()
pyplot是matplotlib库的一个子模块,提供类似MATLAB风格的绘图接口,通常使用plt作为别名plt.figure()用于创建一个新的Figure对象,即绘图的画布figsize=(5, 5)指定画布的尺寸,单位是英寸
输出:
0.2.2. 安装numpy和试运行
一般来说,由于numpy是matplotlib的依赖,所以安装matplotlib时就会自动安装numpy。我们就不需要专门输入命令安装numpy了。
为了以防万一,这里还是提一下安装numpy的命令。
Step 1:切换环境(可选)
与上文相同,这里不再阐述
Step 2:下载并安装
使用pip指令就可以下载了:
pip install numpy
如果你身处国内,下载速度慢,那可以换用国内镜像源。这里我推荐清华的镜像源:
pip install numpy -i https://pypi.tuna.tsinghua.edu.cn/simple
Step 3:试运行
接下来我们可以在代码中运用一下numpy来看看有没有安装好:
import numpy as np
a = np.eye(5)
print(type(a))
print(a)
np.eye(5)用于创建一个5×5的单位矩阵(Identity Matrix)。单位矩阵是一个对角线元素为 1,其余元素为 0 的矩阵:
输出:
<class 'numpy.ndarray'>
[[1. 0. 0. 0. 0.]
 [0. 1. 0. 0. 0.]
 [0. 0. 1. 0. 0.]
 [0. 0. 0. 1. 0.]
 [0. 0. 0. 0. 1.]]
numpy还有一些有趣的函数:
b = np.ones([5,5])
print(type(b))
print(b)
np.ones([5,5])生成一个5×5的NumPy数组,其中所有元素均为1。ones()是NumPy提供的创建全 1 数组的函数
输出:
<class 'numpy.ndarray'>
[[1. 1. 1. 1. 1.]
 [1. 1. 1. 1. 1.]
 [1. 1. 1. 1. 1.]
 [1. 1. 1. 1. 1.]
 [1. 1. 1. 1. 1.]]
numpy最强大的地方在于数组的直接运算,在这里也展示一下这样的代码:
import numpy as np

a = np.eye(5)
print(f"a =\n {a}\n")

b = np.ones([5,5])
print(f"b =\n {b}\n")

c = a + b # magically
print(f"c =\n {c}\n")
输出:
a =
 [[1. 0. 0. 0. 0.]
 [0. 1. 0. 0. 0.]
 [0. 0. 1. 0. 0.]
 [0. 0. 0. 1. 0.]
 [0. 0. 0. 0. 1.]]

b =
 [[1. 1. 1. 1. 1.]
 [1. 1. 1. 1. 1.]
 [1. 1. 1. 1. 1.]
 [1. 1. 1. 1. 1.]
 [1. 1. 1. 1. 1.]]

c =
 [[2. 1. 1. 1. 1.]
 [1. 2. 1. 1. 1.]
 [1. 1. 2. 1. 1.]
 [1. 1. 1. 2. 1.]
 [1. 1. 1. 1. 2.]]
0.2.3. 安装pandas和试运行
Step 1:切换环境(可选)
与上文相同,这里不再阐述
Step 2:下载并安装
使用pip指令就可以下载了:
pip install pandas
如果你身处国内,下载速度慢,那可以换用国内镜像源。这里我推荐清华的镜像源:
pip install pandas -i https://pypi.tuna.tsinghua.edu.cn/simple
Step 3:试运行
pandas库的强大点在于数据的加载、保存及索引功能,我在本地创建了这么一个csv文件:
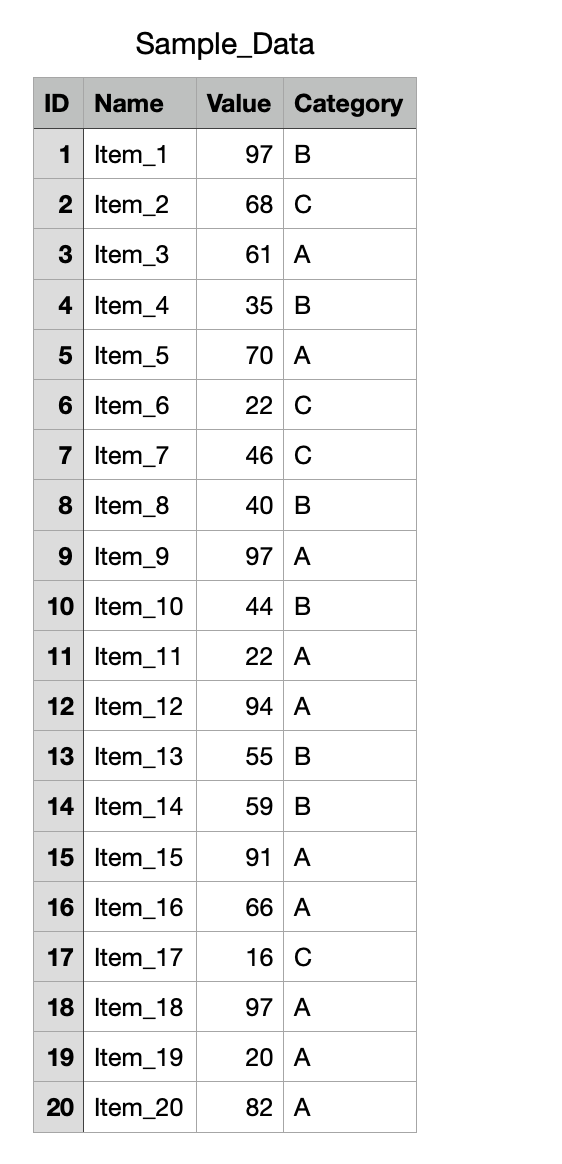
我们可以用pandas库的函数来读取出来:
import pandas as pd
data = pd.read_csv('Sample_Data.csv')
print(type(data))
print(data)
- 使用
pd.read_csv('Sample_Data.csv')读取Sample_Data.csv文件,并将其存入data变量中 - 读取后,
data将是一个pandas.DataFrame,即一个二维数据表结构,类似于Excel表格。
输出:
<class 'pandas.core.frame.DataFrame'>
    ID     Name  Value Category
0    1   Item_1     97        B
1    2   Item_2     68        C
2    3   Item_3     61        A
3    4   Item_4     35        B
4    5   Item_5     70        A
5    6   Item_6     22        C
6    7   Item_7     46        C
7    8   Item_8     40        B
8    9   Item_9     97        A
9   10  Item_10     44        B
10  11  Item_11     22        A
11  12  Item_12     94        A
12  13  Item_13     55        B
13  14  Item_14     59        B
14  15  Item_15     91        A
15  16  Item_16     66        A
16  17  Item_17     16        C
17  18  Item_18     97        A
18  19  Item_19     20        A
19  20  Item_20     82        A
既然我们都知道如何读取数据了,那顺便就转存一下数据吧:
value = data.loc[:,'Value']
print(type(value))
print(value)
data.loc[:, 'Value']选取data这个DataFrame中所有行(:)和**“Value” 列** ('Value')loc[]是Pandas用于基于标签选择数据的方法,:代表选取所有行
输出:
<class 'pandas.core.series.Series'>
0     97
1     68
2     61
3     35
4     70
5     22
6     46
7     40
8     97
9     44
10    22
11    94
12    55
13    59
14    91
15    66
16    16
17    97
18    20
19    82
我们再来试一试pandas的数据筛选功能:
import pandas as pd
data = pd.read_csv('Sample_Data.csv')

values = data.loc[:, 'Value']

special_category = data.loc[:,'Category'][values > 50]

print(special_category)
data.loc[:, 'Category'][values > 50]:values > 50会返回一个布尔索引,用于筛选Value列中大于50的行- 先取出
Category列data.loc[:, 'Category'],然后只保留Value大于50的行 - 结果是
Category列的一个筛选后的Series
输出:
0     B
1     C
2     A
4     A
8     A
11    A
12    B
13    B
14    A
15    A
17    A
19    A
Name: Category, dtype: object
我们还可以通过pandas把数据存储为本地的文件。比如说我们现在把所有的数据都加10然后保存:
import pandas as pd

data = pd.read_csv('Sample_Data.csv')

data['Value'] = data['Value'] + 10

data.to_csv('Sample_Data_modified.csv')

print(data.head())
to_csv可以将数据保存为.csv文件,其参数就是保存的文件名head方法可以打印列表的前几项而不是所有,这对于打印比较大的列表来说比较方便
输出:
   ID    Name  Value Category
0   1  Item_1    107        B
1   2  Item_2     78        C
2   3  Item_3     71        A
3   4  Item_4     45        B
4   5  Item_5     80        A
新的叫做Sample_Data_modified.csv的文件也被创建了:
,ID,Name,Value,Category
0,1,Item_1,107,B
1,2,Item_2,78,C
2,3,Item_3,71,A
3,4,Item_4,45,B
4,5,Item_5,80,A
5,6,Item_6,32,C
6,7,Item_7,56,C
7,8,Item_8,50,B
8,9,Item_9,107,A
9,10,Item_10,54,B
10,11,Item_11,32,A
11,12,Item_12,104,A
12,13,Item_13,65,B
13,14,Item_14,69,B
14,15,Item_15,101,A
15,16,Item_16,76,A
16,17,Item_17,26,C
17,18,Item_18,107,A
18,19,Item_19,30,A
19,20,Item_20,92,A
0.2.4. pandas和numpy联动操作
我们可以很轻松地将pandas的DataFrame转换为numpy的ndarray:
import pandas as pd
import numpy as np

data = pd.read_csv('Sample_Data.csv')
data_array = np.array(data)

print(type(data_array))
print(data_array)
输出:
<class 'numpy.ndarray'>
[[1 'Item_1' 97 'B']
 [2 'Item_2' 68 'C']
 [3 'Item_3' 61 'A']
 [4 'Item_4' 35 'B']
 [5 'Item_5' 70 'A']
 [6 'Item_6' 22 'C']
 [7 'Item_7' 46 'C']
 [8 'Item_8' 40 'B']
 [9 'Item_9' 97 'A']
 [10 'Item_10' 44 'B']
 [11 'Item_11' 22 'A']
 [12 'Item_12' 94 'A']
 [13 'Item_13' 55 'B']
 [14 'Item_14' 59 'B']
 [15 'Item_15' 91 'A']
 [16 'Item_16' 66 'A']
 [17 'Item_17' 16 'C']
 [18 'Item_18' 97 'A']
 [19 'Item_19' 20 'A']
 [20 'Item_20' 82 'A']]
1.1. 机器学习(Machine Learning)介绍
1.1.1. 什么是机器学习?
举个例子:
小明1月工资1000,每月增长10%,第10月是多少?
| 月份 x | 工资 y |
|---|---|
| 1 | 1,000 |
| 2 | 1,100 |
| 3 | 1,210 |
| 4 | 1,331 |
| 5 | 1,464 |
| 6 | 1,611 |
| 7 | 1,772 |
| 8 | 1,949 |
| 9 | 2,144 |
| 10 | ??? |
那么你很轻松就能列出函数:y = 1000 × 1.1^(x-1)
这正是传统算法的写法:你告诉计算机起始工资y0(1000元),再告诉它每一个月工资的函数关系y = 1000 × 1.1^(x-1),让计算机计算出第10个月的工资
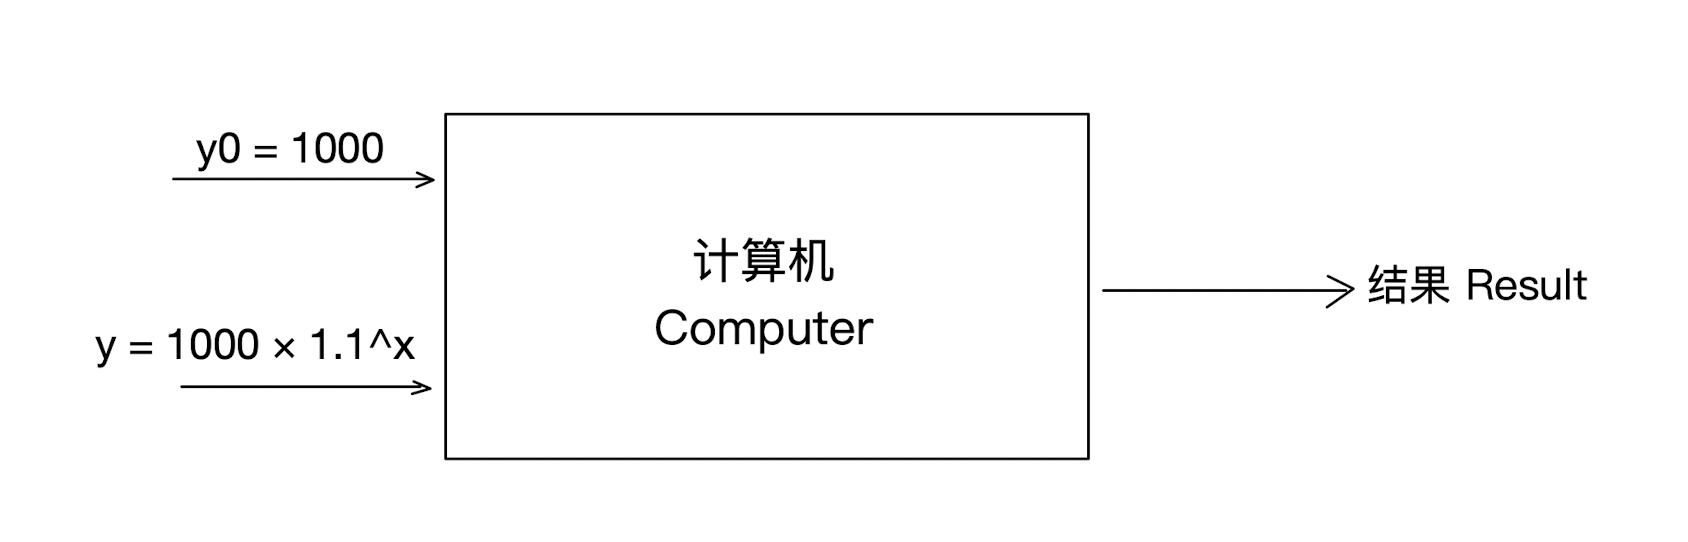
机器学习则会直接告诉计算机月份与工资的数据,让计算机自己推导其中的函数关系,并由此得出第10个月的工资。
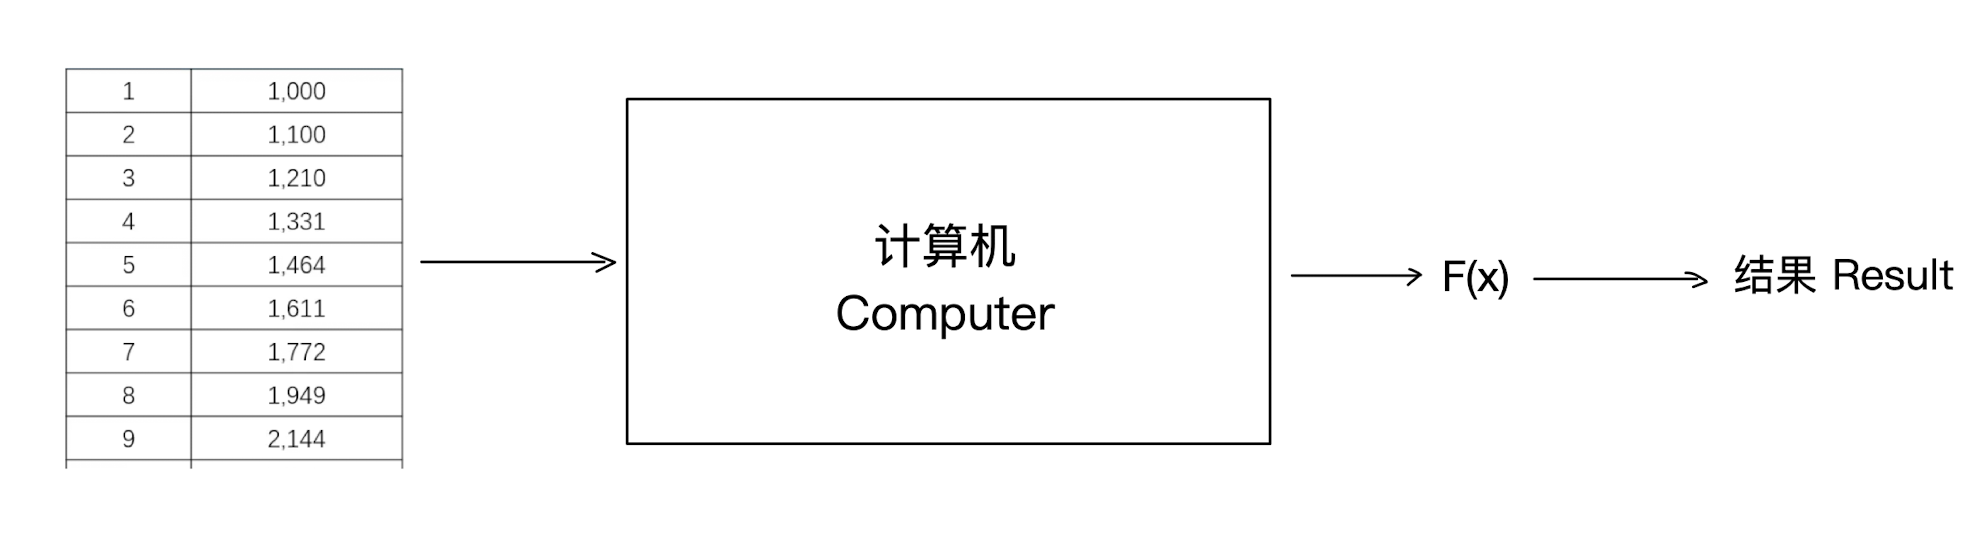
一句话总结:机器学习是一种使计算机能够从数据中自动学习模式并进行预测或决策的算法和技术。
1.1.2. Transformer大行其道,还有必要学ML和DL吗?
有很多同学都会有这个疑问:现在Transformer模型非常火爆,我干嘛还要去学机器学习(ML)和深度学习(DL)的内容呢?
我们来看看作为Transformer模型最杰出的产物ChatGPT对此的回答:
Q:请你用一段话回答这个问题:现在Transformer大行其道,还有必要学习Machine Learning 和 Deep Learning吗?
A:当然有必要!Transformer虽然在自然语言处理、计算机视觉等领域取得了巨大成功,但Machine Learning(机器学习)和Deep Learning(深度学习)仍然是整个AI领域的基础。Transformer本质上是深度学习的一种架构,理解其原理需要扎实的深度学习知识,如神经网络、梯度下降、优化方法等。此外,机器学习中的传统方法(如决策树、SVM、聚类等)在小数据集、可解释性、低计算资源需求等场景下仍然具有优势。因此,系统学习机器学习和深度学习,不仅能帮助更好地理解和优化Transformer,还能在更广泛的应用场景中找到合适的解决方案。
我想GPT的回答已经很清晰了——机器学习(ML)和深度学习(DL)是基础,了解这两者才能为学习Transformer打好基础。
1.1.3. 机器学习的基本框架
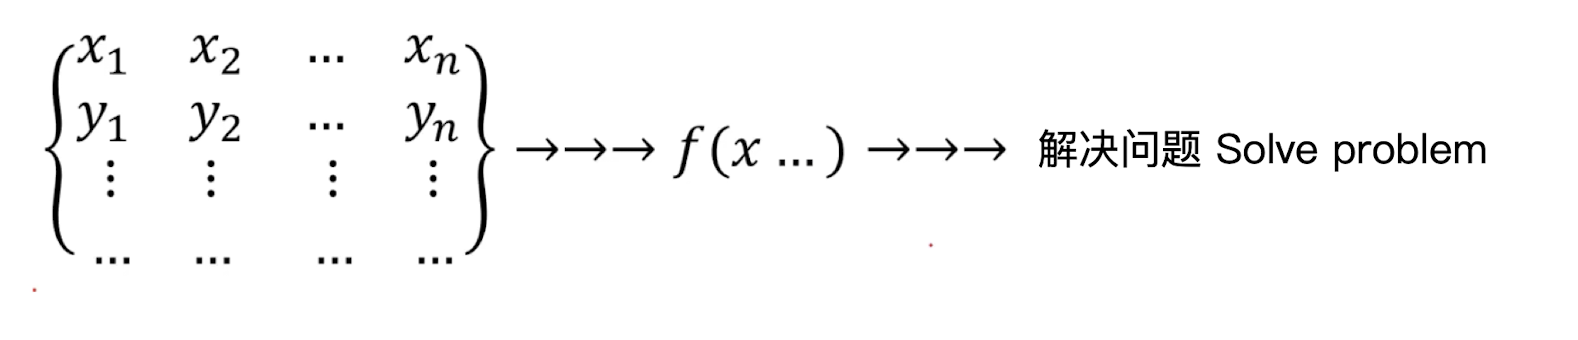
机器学习(ML)和深度学习(DL)的核心是数据,尤其是训练数据。在图中,左侧的矩阵展示了训练数据的基本结构,其中包含多个样本,每个样本由一组输入特征(x1, x2, …, xn)和相应的输出标签 y 组成。这些数据用于指导模型学习输入与输出之间的映射关系,为后续的预测和决策提供依据。
在ML和DL中,模型的目标是找到一个映射函数 f(x),使得对于新的输入 x,能够预测出合理的输出 y。这一过程涉及训练(Training),即让计算机根据提供的数据自动学习数据之间的关系,并不断优化模型参数,使其能够更准确地映射输入到输出。ML 可能依赖手工特征工程,而 DL 通过神经网络自动学习特征。
训练完成后,模型可以用于解决实际问题。对于新的数据输入 x,模型会利用已经学习到的f(x)进行预测,输出相应的结果。这一过程即为推理(Inference)。
ML和DL的一个关键特性是“自动求解数据关系”。在传统编程方法中,程序员需要手动编写规则来处理数据,而在 ML 和 DL 中,计算机通过训练数据自动学习这些规则。ML 适用于结构化数据,DL 适用于更复杂的数据类型,如图像、语音和文本。这种方式大大提高了模型的适应能力,使其能够应对复杂的现实问题。
1.2.机器学习的类别
监督学习 (Supervised Learning)
监督学习是指模型在训练时使用的数据包含正确的结果(标签-label)。在训练过程中,模型通过输入数据和对应的正确标签进行学习,目的是找到输入与输出之间的映射关系,以便对新数据进行准确预测。
无监督学习 (Unsupervised Learning)
无监督学习的训练数据不包含正确的结果,模型需要自己从数据中学习其内在结构或模式。通常用于聚类(clustering) 和 降维(dimensionality reduction) 任务。
半监督学习 (Semi-supervised Learning)
半监督学习介于监督学习和无监督学习之间,训练数据包含少量正确的结果,但大部分数据是未标注的。该方法结合了两者的优点,可以在标注数据有限的情况下提升模型性能。
强化学习 (Reinforcement Learning)
强化学习是一种通过与环境交互来学习最优策略的机器学习方法。智能体(Agent)在环境(Environment)中执行动作(Action),并根据奖励(Reward) 来调整策略,以最大化长期收益。与监督学习不同,强化学习没有固定的正确答案,而是通过探索和试错来优化决策。
1.3. 课程内容
之后的系列文章中我们会讲到这些部分:
1. 监督学习
- 线性回归 - ML
- 逻辑回归 - ML
- 决策树 - ML
- 神经网络(NN)、卷积神经网络(CNN)、循环神经网络(RNN) - DL
2. 无监督学习
- 聚类算法 - ML
3. 混合学习
- 监督学习 + 无监督学习 - ML
1.2. 线性回归理论
1.2.1. 什么是回归分析(Regressive Analysis)?
一些例子
举一些例子吧:
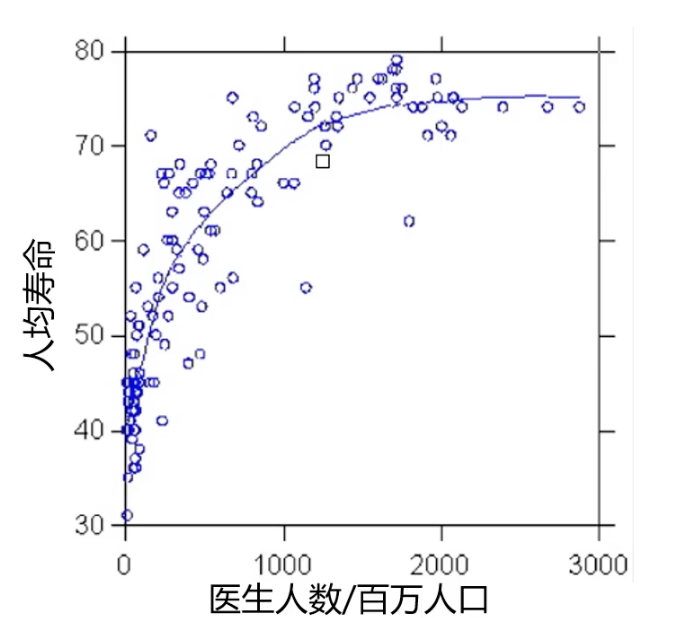
下图是一个每百万人医生数和人均寿命的关系图,其中散点是我们收集到的数据,而拟合出的曲线是我们需要找出的:
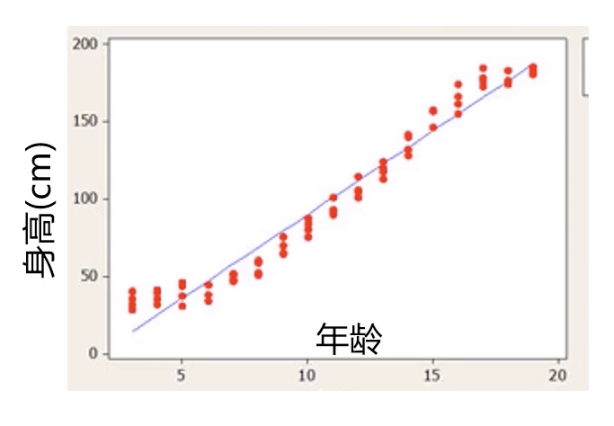
下图是一个年龄与身高的关系图,其中散点是收集到的数据,我们的目标是找到一条拟合曲线:
定义
相信看过上文两个例子之后你对回归分析又了一定的认识,这里我直接给出回归分析的定义:
根据数据,确定两种或两种以上变量间相互依赖的定量关系。
其函数表达式为: y = f(x_1, x_2 , …, x_n)
回归分析的分类
回归分析有很多种。
如果我们以变量数来分类,有:
- 一元回归:y = f(x)
- 多元回归:y = f(x_1, x_2 , …, x_n)
如果我们以函数关系来分类,有:
- 线性回归:y = ax + b
- 非线性回归:y = ax^2 + bx + c
1.2.2. 线性回归
线性回归指的是回归分析中,变量与因变量间存在线性关系。其函数表达式为:y = ax + b
回归问题求解
问题:面积为110平方米的房子售价150万是否值得投资?
| 面积(A) | 售价(P) |
|---|---|
| 79 | 404,976 |
| 92 | 948,367 |
| … | … |
| 108 | 1,049,007 |
| 110 | ??? |
| 118 | 578,142 |
| … | … |
我们要回答这个问题一般来说要分成以下几步去完成:
- 确定
P、A之间的关系:P = f(A) - 根据关系预测合理价格:P(A = 110) = f(110)
- 做出判断
这3步中最核心的问题就是第一步——找关系。
下图是根据表格数据整理出的散点图:
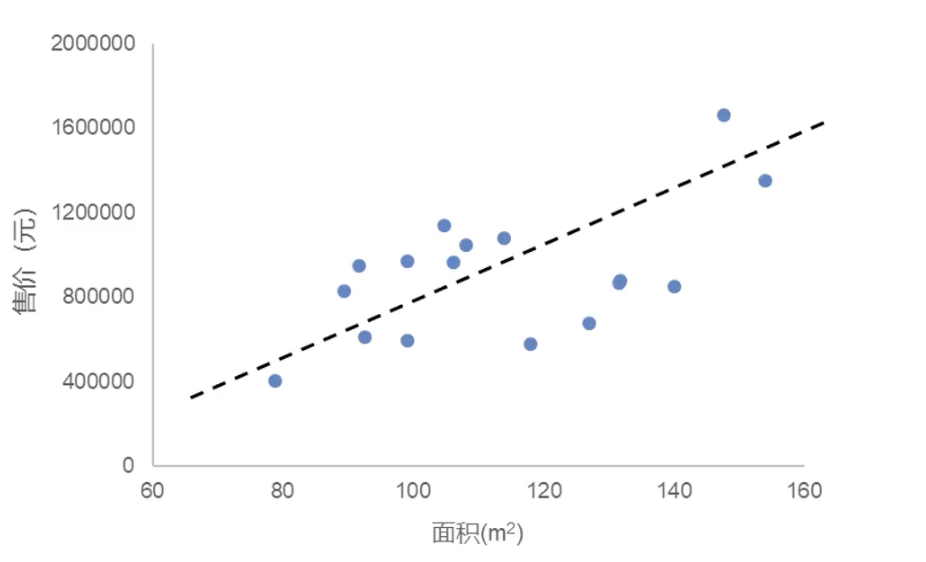
我们的目标就是要找到这条黑色的拟合曲线的对应的函数式是怎么写的。
这里我们假设这条拟合曲线是线性函数,也就是y = ax + b,所以我们真正的目标其实就是找到合理的参数a和b的值。
1.2.3. 最小化平方误差和公式
把问题进行以下转换:假设x为变量,y为对应的结果,y’(也就是ax + b)为模型输出的结果。这时候我们的目标就是让y’尽可能地接近y,也就是最小化 平方误差和(Sum of Squared Errors, SSE): $$ \textit{minimize} \left{ \sum_{i=1}^{m} (y’_i - y_i)^2 \right} $$
m:数据样本的数量。y_i:第i个样本的真实值(ground truth)。y‘_i:第i个样本的预测值(由模型计算得到)。(y'_i - y_i)^2:每个样本的误差平方,表示预测值与真实值之间的偏差。i = 1:i是数据点的索引,i = 1是指索引的起始值为1
我们还需要对这个公式进行一个变换: $$ \textit{minimize} \left{ \frac{1}{2m} \sum_{i=1}^{m} (y’_i - y_i)^2 \right} $$
该公式多了一个1/2m,主要是为了在梯度下降时更方便求导: $$ \frac{d}{d\theta} \frac{1}{2m} \sum_{i=1}^{m} (y{\prime}_i - y_i)^2 $$ 导数中的2会被消去,使更新公式更简洁。由于m是一个常数,所以这个变换并不会影响最后得出的a和b的值。
一点名词解释:
- 梯度下降是一种优化算法,用于最小化函数(如机器学习模型的损失函数)。在机器学习和深度学习中,梯度下降用于优化模型参数,使损失函数的值最小化。
- 求导就是计算函数的斜率,描述一个变量如何随另一个变量的变化而变化。
一个小例子
我们来看一个小例子吧:
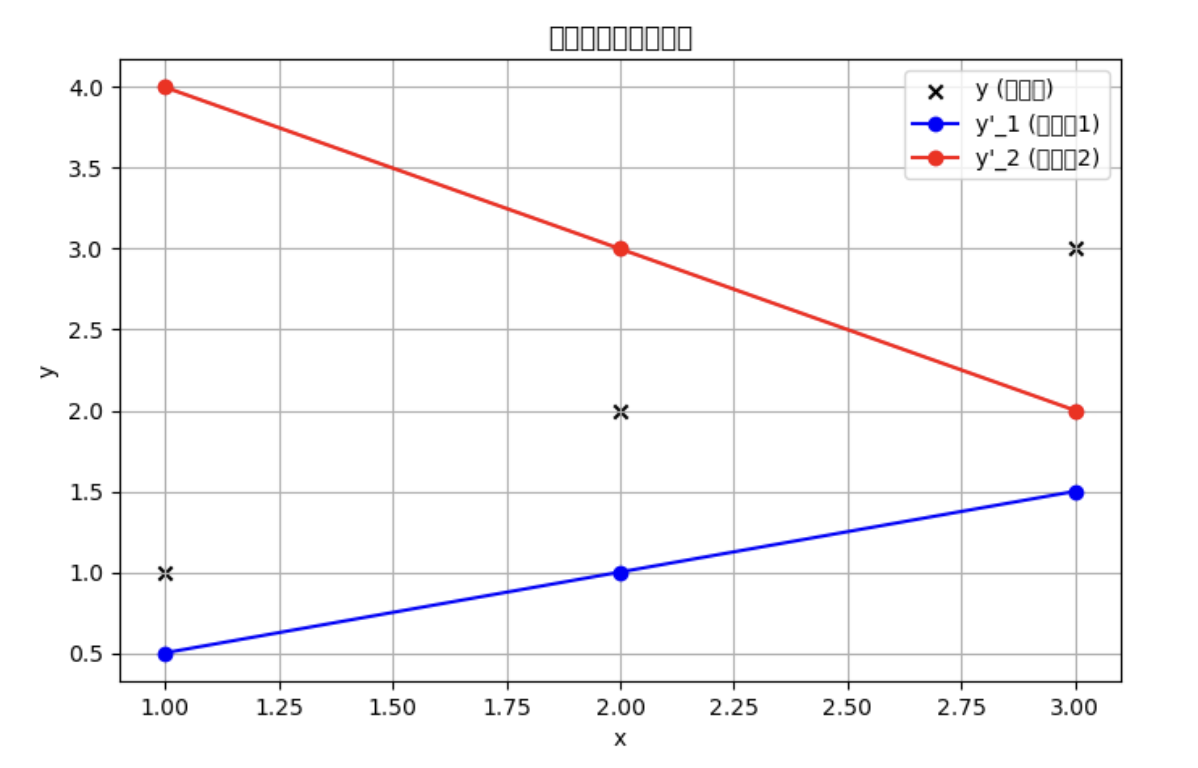
- 黑色散点:代表真实值
y - 蓝色折线:代表预测值
y'_1 - 红色折线:代表预测值
y'_2可以清楚地看到,y'_1和y'_2的趋势与y的分布情况。y'_1接近真实值,而y'_2变化趋势相反。
以下是数据的表格统计:
| x | y | y’_1 | y’_2 |
|---|---|---|---|
| 1 | 1 | 0.5 | 4 |
| 2 | 2 | 1 | 3 |
| 3 | 3 | 1.5 | 2 |
| 接下来我们就用上文讲过的SSE公式的变形来算误差: | |||
| $$ | |||
| J_1 = \frac{1}{2m} \sum_{i=1}^{m} (y’_1 - y)^2 = \frac{1}{2 \times 3} \times \left( (0.5 - 1)^2 + (1 - 2)^2 + (1.5 - 3)^2 \right) = 0.583 | |||
| $$ | |||
| $$ | |||
| J_2 = \frac{1}{2m} \sum_{i=1}^{m} (y’_2 - y)^2 = \frac{1}{2 \times 3} \times \left( (4 - 1)^2 + (3 - 2)^2 + (2 - 3)^2 \right) = 1.83 | |||
| $$ | |||
可以看到,跟图中所展现的关系一样,J_1明显小于J_2,代表y'_1的误差明显小于y'_2。 |
一点题外话:上面的折线图是用matplotlib生成的哦,你也可以试着使用表格中的数据用Python写出一样的效果。我在下面提供了Python源码,写完之后你可以对照一下:
import matplotlib.pyplot as plt

# 数据
x = [1, 2, 3]
y = [1, 2, 3]        # 真实值
y1_pred = [0.5, 1, 1.5]  # 预测值1
y2_pred = [4, 3, 2]  # 预测值2

# 创建图表
plt.figure(figsize=(8, 5))

# 绘制真实值的散点图
plt.scatter(x, y, color='black', marker='x', label="y (真实值)")

# 绘制 y'_1 折线图
plt.plot(x, y1_pred, marker='o', linestyle='-', color='blue', label="y'_1 (预测值1)")

# 绘制 y'_2 折线图
plt.plot(x, y2_pred, marker='o', linestyle='-', color='red', label="y'_2 (预测值2)")

# 标注
plt.xlabel("x")
plt.ylabel("y")
plt.title("真实值与预测值对比")
plt.legend()
plt.grid(True)

# 显示图表
plt.show()
1.2.4. 梯度下降法
OK,让我们回到正题。我们真正要求的是y = ax + b中a和b的值,所以我们还得变换一下SSE公式,让函数的参数变为a和b。其实这一步变化也很简单,就是把原函数中的y'_i替换成ax_i + b即可:
$$
J = \frac{1}{2m} \sum_{i=1}^{m} (y’i - y_i)^2 = \frac{1}{2m} \sum{i=1}^{m} (a x_i + b - y_i)^2 = g(a, b)
$$
为了让这个损失函数尽可能的小,我们就需要梯度下降法:
- 它是寻找极小值的一种方法。通过向函数上当前点对应梯度(或者是近似梯度)的反方向的规定步长距离点进行迭代搜索,直到在极小点收敛。
- “收敛”指的是趋向于某个极限值(比如一个函数的最大值/最小值)
假设:
$$
J = f(p)
$$
那么对于p使用梯度下降法的公式就是:
$$
p_{i+1} = p_i - \alpha \frac{\partial}{\partial p_i} f(p_i)
$$
p_i+1是更新后的参数值,由当前值p_i进行调整α(学习率):控制每次更新的步长α后面跟的那一串是函数f(p)在当前点p_i处的梯度(偏导数),表示f(p)在该点变化的方向和大小。
我们以亲民的方式讲解一下梯度,你可以把梯度(Gradient) 想象成坡的陡峭程度和方向:
- 如果坡很陡(梯度大),你往下走就会很快。
- 如果坡很平缓(梯度小),你往下走就会慢一点。
- 如果到了山谷(梯度接近 0),说明你已经走到了最低点(最优解)。
数学上的梯度,其实就是告诉你:
- “你现在所处的位置,往哪个方向下降最快?而且下降的速度是多少?”
我们再用这个例子解释一下梯度下降法的步骤:
- 你站在山上,不知道最低点在哪(开始训练)
- 你用脚感受坡的方向(计算梯度)
- 你沿着坡最陡的下坡方向走一步(更新参数)
- 你重复这个过程,每次都调整方向(不断优化)
- 走到坡度几乎没有变化的地方(梯度接近 0),你就到达了山谷(找到最优解)
举个例子我们来一步步算,假设我们有一个简单的函数: $$ J(a) = (a - 3)^2 $$
只要是有中学学历都能一眼看出来最小值在3,但我们就假装不知道,用梯度下降法一步步算:
1. 计算梯度
梯度就是函数的导数,我们先求出J(a)对a的导数:
$$
\frac{dJ}{da} = 2(a - 3)
$$
这个梯度告诉我们:当前的a离3还有多远,以及它应该往哪个方向调整。
2. 设定初始值
我们随便选个起点,比如a = 0,然后逐步优化它。
3. 更新a
梯度下降的更新公式是: $$ a := a - \alpha \cdot \frac{dJ}{da} $$
α是学习率,我们设α = 0.1(步子大小)
刚才我们设了a = 0,所以这时候梯度是:
$$
\frac{dJ}{da} = 2(0 - 3) = -6
$$
代入更新公式:
$$
a := 0 - 0.1 \times (-6)
$$
$$
a = 0 + 0.6 = 0.6
$$
更新后,a从0变成了0.6,朝着正确的方向移动了!
4. 不断重复
我们一直不断重复这个步骤:
| 迭代次数 | a 当前值 | 计算梯度 | 更新后的 a |
|---|---|---|---|
| 1 | 0.0 | -6 | 0.6 |
| 2 | 0.6 | -4.8 | 1.08 |
| 3 | 1.08 | -3.84 | 1.464 |
| 4 | 1.464 | -3.072 | 1.7712 |
| 5 | 1.7712 | -2.4576 | 2.01696 |
可以看到, a一步步向3逼近!如果继续迭代,最终会非常接近a = 3。 |
这个方法以后我们在讲回归逻辑和神经网络时还会遇到的,所以大家务必铭记。
1.2.5. 对a和b使用梯度下降法
回到我们之前变换过后,参数是a和b的SSE函数:
$$
J = \frac{1}{2m} \sum_{i=1}^{m} (y’i - y_i)^2 = \frac{1}{2m} \sum{i=1}^{m} (a x_i + b - y_i)^2 = g(a, b)
$$
对a和b使用梯度下降法非常简单且暴力:
$$
\begin{cases}
temp_a = a - \alpha \frac{\partial}{\partial a} g(a,b) = a - \alpha \frac{1}{m} \sum\limits_{i=1}^{m} (a x_i + b - y_i)x_i \
temp_b = b - \alpha \frac{\partial}{\partial b} g(a,b) = b - \alpha \frac{1}{m} \sum\limits_{i=1}^{m} (a x_i + b - y_i)
\end{cases}
$$
temp_a和temp_b是临时的变量。经过一次计算后,我们对a和b进行一次更新,把temp_a和temp_b分别赋给它们:
$$
a = temp_a
$$
$$
b = temp_b
$$
然后再进行一次计算,一次更新,就这样一直重复直到函数收敛。
这里我们展示的是一元的线性回归,其实多元线性回归也是一样的思路,使用梯度下降法。只不过参数会不止a和b,还有c、d、e等等。
1.3. 线性回归实战(基础)
1.3.1. Scikit-learn
Scikit-learn是Python语言中专门针对机器学习应用而发展出的开源框架(算法库)。同个这个算法库我们可以实现数据预处理、分类、回归、降维、模型选择等常用的机器学习算法。
有了这个模型,能将我们上一篇文章 1.2. 线性回归理论 中所讲的线性回归理论压缩到不到5行的代码量。你看过上文的数学阐述有多长就知道实现这点有多不容易了。
它的特点就是集成了机器学习中各类成熟的算法,容易安装和使用,样例丰富,教程和文档也很详细。
它的缺点是不支持Python以外的语言,不支持深度学习和强化学习。
1.3.2. 安装Scikit-learn
在MacOS上,打开终端;在Windows上,打开Anaconda Prompt或者Anaconda Powershell Prompt(注意:如果你把Anaconda下载在C盘那就得以管理员身份打开,不然有可能在后续的操作中报错)。输入如下指令:
pip install scikit-learn
1.3.2. 调用Scikit-learn求解线性回归问题
在上一篇文章 1.2. 线性回归理论 中我们就详细阐述过了线性回归问题的核心思路——寻找y = ax + b中的两个参数a和b。
这里我给大家提供一些数据:
x,y
0,3.4941499975136017
1,3.2195777812087623
2,7.020239126724705
3,10.561179685791949
4,11.829186585662265
5,11.75496874167899
6,16.58341895848982
7,17.851195579820043
8,18.938095976526668
9,20.573327586269645
10,21.402583214283524
11,25.383074825333473
12,26.80228829909171
13,29.477295234061874
14,31.491963327709488
15,33.52264335242398
16,32.243263034545826
17,37.49084903752127
18,39.72984009710374
19,40.75882117159081
把这些复制到一个.csv文件中,命名为data,然后放到Python项目的文件夹里即可
接下来,在这个Python项目的main.py中这么写(确保你已经安装好了pandas库,0.2. 下载、安装和试运行需要的包 中有教程):
import pandas as pd
from sklearn.linear_model import LinearRegression

# 读取数据
data = pd.read_csv('data.csv')
x = data.loc[:, ['x']]
y = data.loc[:, ['y']]

# 训练线性回归模型
Ir_model = LinearRegression()
Ir_model.fit(x, y)

# 获取回归系数和截距
a = Ir_model.coef_[0][0]  # 提取数值
b = Ir_model.intercept_[0]  # 提取数值
print('a = ', a)
print('b = ', b)
-
pd.read_csv('data.csv')读取data.csv文件,将其存储在类型为DataFrame的变量data中 -
x = data.loc[:, ['x']]取出x列,并保持其为 二维数组(DataFrame类型),因为scikit-learn要求输入X是二维结构 -
y = data.loc[:, ['y']]取出 y 列,作为目标变量(也是二维) -
Ir_model = LinearRegression()创建线性回归模型 -
Ir_model.fit(x, y):使用x和y这两个变量里的内容训练模型,让它找到最优的回归系数(coef_)和截距(intercept_) -
a = Ir_model.coef_[0][0]:Ir_model.coef_返回系数矩阵,因为scikit-learn允许多元回归(多个特征),但我们这里的数据拟合出来的线只有一元一次,也就是只会有一个系数,处于系数矩阵的[0][0]。我们这里用[0][0]取出具体数值(如果是多元回归,coef_会是一个数组) -
b = Ir_model.intercept_[0]:Ir_model.intercept_返回截距,因为scikit-learn允许多元回归(多个特征),所以截距的结果会存储在一个数组里。我们这里的数据是线性回归的,只有一元一次,也就是只会有一个截距,处于系数矩阵的[0]。同样用[0]提取具体数值。
输出:
a =  1.984261059610437
b =  3.155918014368453
我们还可以通过predict方法来看拟合出的曲线每个x点对应的y值:
# 预测
predictions = Ir_model.predict(x)
print(predictions)
输出:
[[ 3.15591801]
 [ 5.14017907]
 [ 7.12444013]
 [ 9.10870119]
 [11.09296225]
 [13.07722331]
 [15.06148437]
 [17.04574543]
 [19.03000649]
 [21.01426755]
 [22.99852861]
 [24.98278967]
 [26.96705073]
 [28.95131179]
 [30.93557285]
 [32.91983391]
 [34.90409497]
 [36.88835603]
 [38.87261709]
 [40.85687815]]
最后我们再用matplotlib对数据进行可视化:
import matplotlib.pyplot as plt

# ...中间的内容已省略

# 绘制散点图
plt.scatter(x, y, color='blue', label='数据点')

# 绘制回归直线
x_line = x.sort_values(by='x')  # 确保 x 排序
y_line = a * x_line + b  # 根据模型计算
plt.plot(x_line, y_line, color='red', label=f'回归线: y = {a:.2f}x + {b:.2f}')
plt.show()
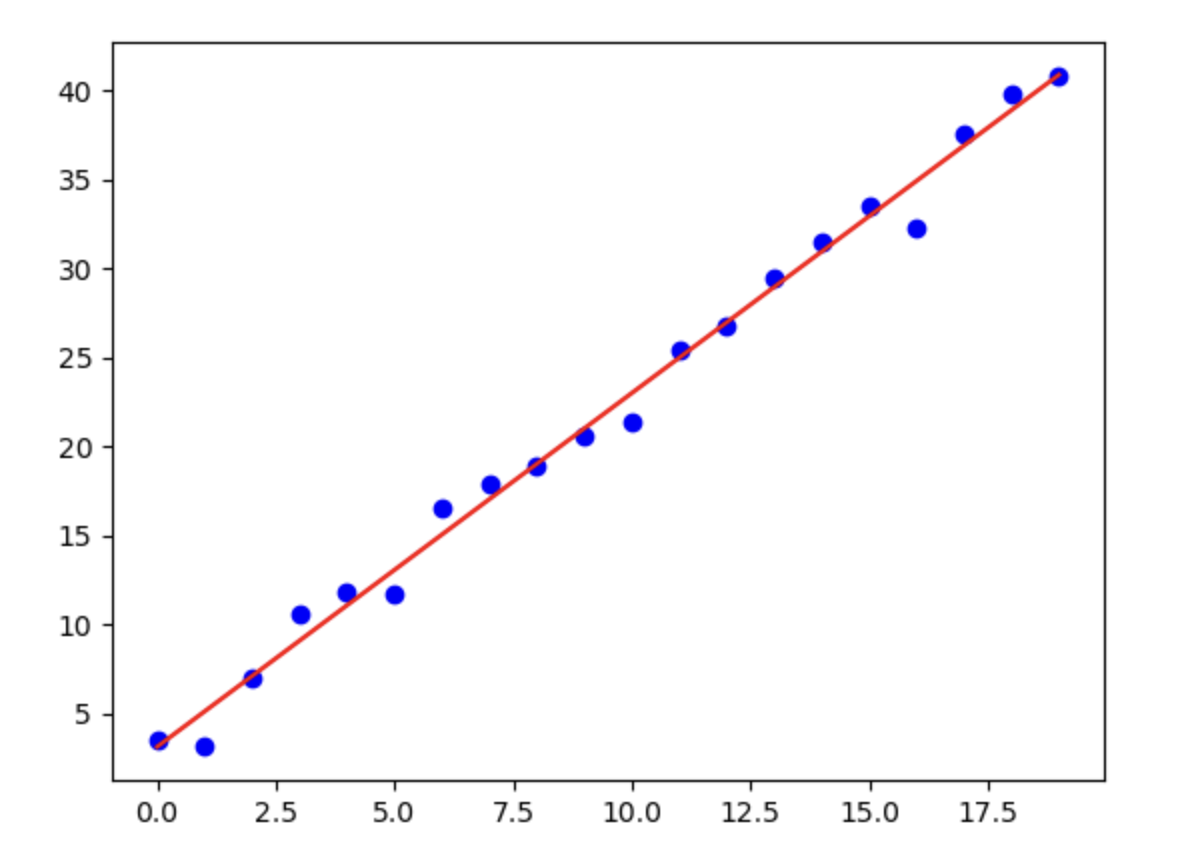
生成的图长这样:
1.4. 评估线性回归模型模型表现
后面会有专门的一篇文章来介绍如何评估模型的表现。这里为了让大家对上一篇文章 1.3. 线性回归实战(基础) 所创建的线性回归模型有一个基本的了解,先讲一些适用于线性回归模型评估的方法。
1.4.1. y与y'的均方误差(MSE)
数学公式
均方误差(Mean Square Error)公式如下: $$ MSE = \frac{1}{m} \sum_{i=1}^{m} (y’_i - y_i)^2 $$
MSE和我们之前讲过的损失函数(平方误差和公式Sum of Square Error)非常像: $$ { SSE = \sum_{i=1}^{m} (y’_i - y_i)^2 } $$
两者的区别在于:
-
SSE是所有预测值和真实值之间的平方误差的总和,不进行归一化处理。主要用于衡量整体误差的绝对大小,适用于模型拟合质量的评估。
-
MSE 是SSE除以样本数量m,即SSE的均值。它表示平均每个数据点的平方误差,能够提供误差的标准化度量,适用于模型优化和比较。
MSE越小越好,等于0时就是完美的拟合
代码实现
接下来我们来敲代码,数据和之前的代码都与上一篇文章 1.3. 线性回归实战(基础) 保持一致,这里我还是再敲一边:
data.csv:
x,y
0,3.4941499975136017
1,3.2195777812087623
2,7.020239126724705
3,10.561179685791949
4,11.829186585662265
5,11.75496874167899
6,16.58341895848982
7,17.851195579820043
8,18.938095976526668
9,20.573327586269645
10,21.402583214283524
11,25.383074825333473
12,26.80228829909171
13,29.477295234061874
14,31.491963327709488
15,33.52264335242398
16,32.243263034545826
17,37.49084903752127
18,39.72984009710374
19,40.75882117159081
main.py:
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression

# 读取数据
data = pd.read_csv('data.csv')
x = data.loc[:, ['x']]
y = data.loc[:, ['y']]

# 训练线性回归模型
Ir_model = LinearRegression()
Ir_model.fit(x, y)

# 获取回归系数和截距
a = Ir_model.coef_[0][0]  # 提取数值
b = Ir_model.intercept_[0]  # 提取数值
print('a = ', a)
print('b = ', b)

# 预测
predictions = Ir_model.predict(x)
print(predictions)

# 绘制散点图
plt.scatter(x, y, color='blue', label='数据点')

# 绘制回归直线
x_line = x.sort_values(by='x')  # 确保 x 排序
y_line = a * x_line + b  # 根据模型计算
plt.plot(x_line, y_line, color='red', label=f'回归线: y = {a:.2f}x + {b:.2f}')
plt.show()
为了计算MSE值,我们需要在上一篇文章 1.3. 线性回归实战(基础) 的代码上增加这个部分:
from sklearn.metrics import mean_squared_error

# ...中间省略

mse = mean_squared_error(y.to_numpy(), predictions)
print(f'MSE: {mse:.2f}')
mean_squared_error函数可以计算MSE值,只需要传入参数y和y'即可y得先使用to_numpy方法,因为mean_squared_error函数接受的参数是numpy的ndarray类型而不是pandas的DataFrame类型
输出:
MSE: 1.16
1.4.2. R方值
数学公式
R方值的计算公式为: $$ R^2 = 1 - \frac{SSE}{SST} $$ 其中SSE的公式就在上文,这里不做详细阐述;SST就是方差少了个1/m,也就是没有归一化处理的方差: $$ SST = \sum_{i=1}^{m} (y_i - \bar{y})^2 $$ 把SSE和SST展开写到R方值公式中就是: $$ R^2 = 1 - \frac{\sum_{i=1}^{m} (y’i - y_i)^2}{\sum{i=1}^{m} (y_i - \bar{y})^2} $$
R方值越接近1就代表效果越好,等于1时就是完美的拟合。
代码实现
为了计算R方值,我们需要在上一篇文章 1.3. 线性回归实战(基础) 的代码上增加这个部分:
from sklearn.metrics import r2_score

# ...中间省略

# R方值计算
r_square = r2_score(y.to_numpy(), predictions)
print(f'R^2: {r_square:.2f}')
r2_score函数可以计算R方值,参数是y和y'- 由于这个函数也只能接受
numpy的ndarray类型,所以也得先使用to_numpy函数
输出:
R^2: 0.99
1.4.3. 可视化
我们也可以通过画图来可视化模型的表现:
# ...前文已省略

# 画散点图
plt.scatter(y, predictions)
plt.show()
这么写输出的x轴就代表真实值y,而y轴代表拟合出的直线预测出的值。
输出的图片:
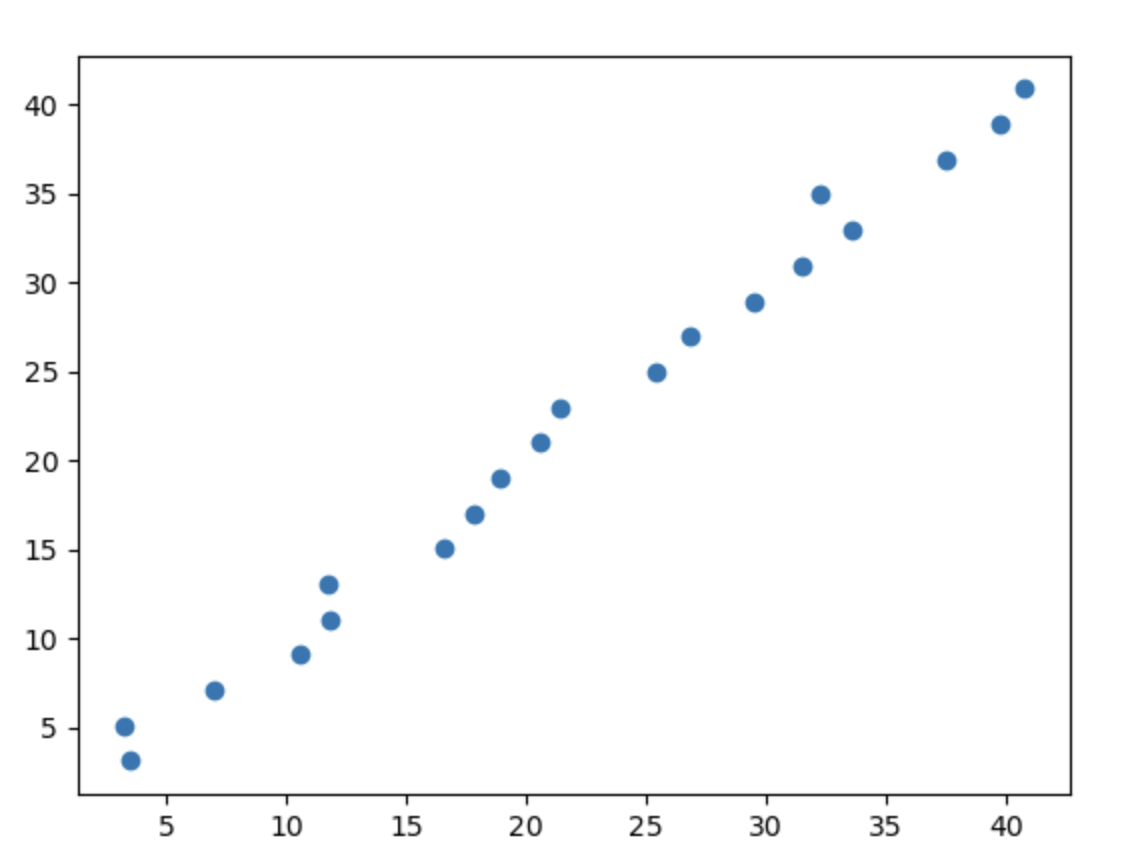
像这样沿对角线的散点分布就代表非常好的效果,越接近y = x这条直线分布就代表效果越好。
1.5. 线性回归实战(进阶)
1.5.1. 一些准备工作
在 1.3. 线性回归实战(基础) 中我们使用了一些小数据对线性回归的代码做了讲解。
在进阶篇中我们会使用特别复杂且巨大的数据。这里需要感谢GitHub用户Brendan Barsness,我们会使用他上传的开源数据——美国房价统计表USA_Housing.csv。
对于登不了GitHub的同学,我会把数据上传到GitCode,点击链接即可查看和下载。
下载好后,请把文件拖至你的Python项目文件夹中。
接下来,请你确保你的Python环境中有pandas、matplotlib、scikit-learn和numpy这几个包,如果没有,请在终端输入指令以下载和安装:
pip install pandas matplotlib scikit-learn numpy
1.5.2. 任务目标
- 以
Avg. Area Income为输入变量,建立单因子模型,评估模型表现,可视化线性回归预测结果 - 以
Avg. Area Income、Avg. Area House Age、Avg. Area Number of Rooms、Avg. Area Number of Bedrooms、Area Population为输入变量,建立多因子模型,评估模型表现 - 预测
Income为65000,House Age为5、Number of Rooms为5、Number of Bedrooms为3、Population为30000的合理房价
1.5.3. 加载数据、数据的可视化、数据的定性分析
由于加载数据在每个任务的代码中都是必须的,所以我就先把它写在这里。
通过pandas库的函数来加载数据:
# 读取数据
import pandas as pd
data = pd.read_csv("USA_Housing.csv")
我们还可以写点代码来预览数据:
# 预览数据
print(type(data),data.shape)
print(data.head())
type(data)获取数据的类型data.shape获取数据有几行几列data.head获取数据的前5行
输出:
<class 'pandas.core.frame.DataFrame'> (5000, 7)
   Avg. Area Income  ...                                            Address
0      79545.458574  ...  208 Michael Ferry Apt. 674\nLaurabury, NE 3701...
1      79248.642455  ...  188 Johnson Views Suite 079\nLake Kathleen, CA...
2      61287.067179  ...  9127 Elizabeth Stravenue\nDanieltown, WI 06482...
3      63345.240046  ...                          USS Barnett\nFPO AP 44820
4      59982.197226  ...                         USNS Raymond\nFPO AE 09386

[5 rows x 7 columns]
- 数据的类型是
DataFrame - 数据有5000行7列
我们还可以用matplotlib来可视化数据:
# 可视化原始数据
import matplotlib.pyplot as plt
fig = plt.figure(figsize=(10, 10))

# 图1
fig1 = plt.subplot(2, 3, 1)
plt.scatter(data.loc[:,'Avg. Area Income'], data.loc[:,'Price'])
plt.title('Income vs Price')

# 图2
fig2 = plt.subplot(2, 3, 2)
plt.scatter(data.loc[:,'Avg. Area House Age'], data.loc[:,'Price'])
plt.title('House Age vs Price')

# 图3
fig3 = plt.subplot(2, 3, 3)
plt.scatter(data.loc[:,'Avg. Area Number of Rooms'], data.loc[:,'Price'])
plt.title('Number of Rooms vs Price')

# 图4
fig4 = plt.subplot(2, 3, 4)
plt.scatter(data.loc[:,'Avg. Area Number of Bedrooms'], data.loc[:,'Price'])
plt.title('Number of Bedrooms vs Price')

# 图5
fig5 = plt.subplot(2, 3, 5)
plt.scatter(data.loc[:,'Area Population'], data.loc[:,'Price'])
plt.title('Population vs Price')

plt.show()
- 注意:
plt.scatter函数的第一个参数是x轴数据,第二个参数是y轴数据
输出图片:
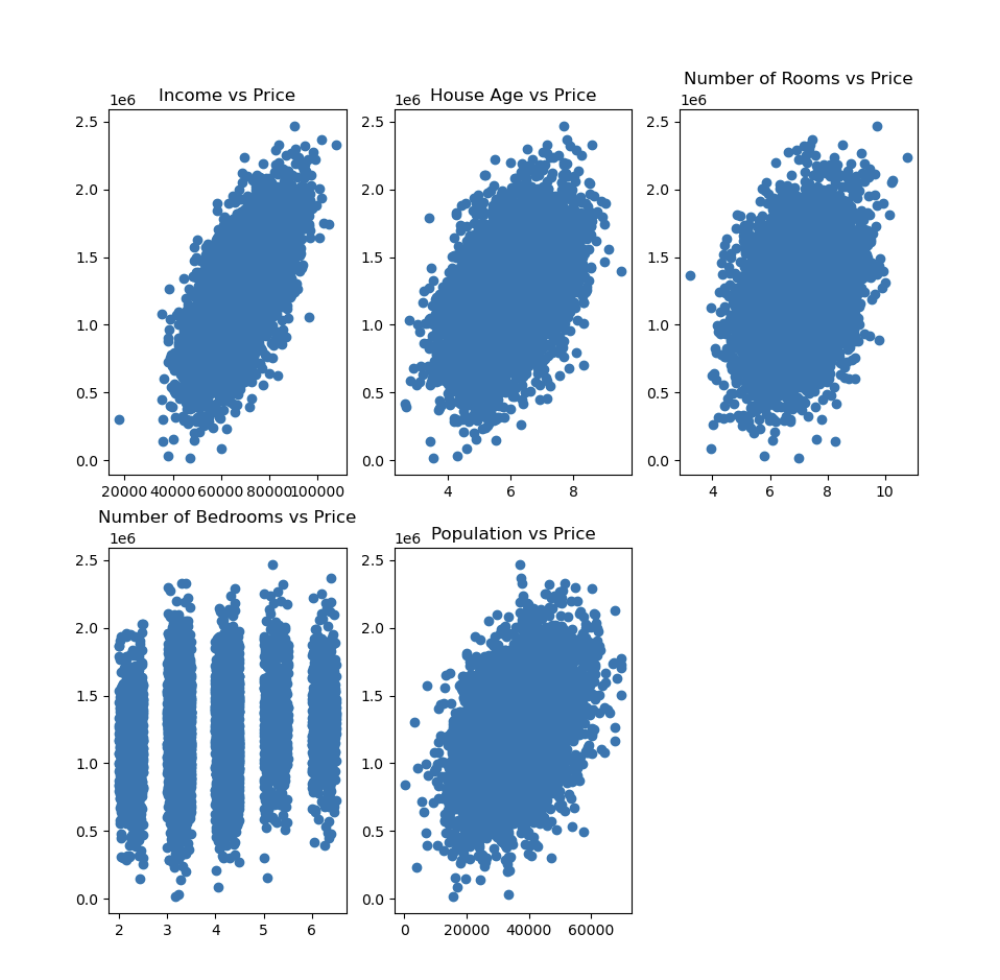
通过这个图,我们可以进行定性的分析(定量得还得写代码):
- 房价与收入呈现正相关关系,收入越高,房价通常越高
- 房龄与房价有一定的正相关性,但相关性较弱,较新的房子房价更集中在较高区间。
- 房间数量与房价存在一定正相关关系,但数据较为分散,说明房价受其他因素影响较大。
- 卧室数量与房价的关系较为离散,表明卧室数量对房价的影响较小,可能受房屋面积或地段影响更大
- 人口数量与房价有一定相关性,但数据呈现较大的分布范围,说明房价可能受人口密度影响,但不是唯一因素
1.5.4. 单因子模型
任务目标:以Avg. Area Income为输入变量,建立单因子模型,评估模型表现,可视化线性回归预测结果
Step 1: 给x和y赋值
既然以Avg. Area Income为输入变量,那么x肯定就是Avg. Area Income,y肯定是Price。
接着上面的读取代码部分来写:
# 给x和y赋值
x = data.loc[:, "Avg. Area Income"]
y = data.loc[:, "Price"]

# 顺带输出一下x和y的前几个值来检查代码写对没有
print(x.head())
print(y.head())
输出:
0    79545.458574
1    79248.642455
2    61287.067179
3    63345.240046
4    59982.197226
Name: Avg. Area Income, dtype: float64
0    1.059034e+06
1    1.505891e+06
2    1.058988e+06
3    1.260617e+06
4    6.309435e+05
Name: Price, dtype: float64
没有任何问题。
Step 2: 训练模型
接下来我们导入scikit-learn中的线性回归模型,并用x和y进行训练:
# 导入线性回归模型
from sklearn.linear_model import LinearRegression
LR = LinearRegression()

# 给x转化一下维度
import numpy as np
x = np.array(x).reshape(-1, 1)

# 训练模型
LR.fit(x, y)
- 转化维度是为了将
x转换成二维数组,因为scikit-learn的fit方法要求x必须是二维数组 (n_samples,n_features) .reshape(-1, 1):-1让NumPy自动计算行数(即数据的样本数n_samples)。1表示x只有一个特征(即n_features=1)
Step 3: 计算预测值
接下来我们根据训练好的模型来看拟合出的直线在x上对应的y值是多少,也就是y_predict:
# 获得预测值
y_predict = LR.predict(x)
print(y_predict)
输出:
[1464424.9504096  1458133.78934377 1077429.52283635 ... 1122016.75893299
 1219741.59365632 1166948.95599714]
Step 4: 可视化预测结果
使用matplotlib画出散点和拟合出的线:
# 可视化
import matplotlib.pyplot as plt
plt.scatter(x, y)
plt.plot(x, y_predict, color="red")
plt.show()
图片输出:
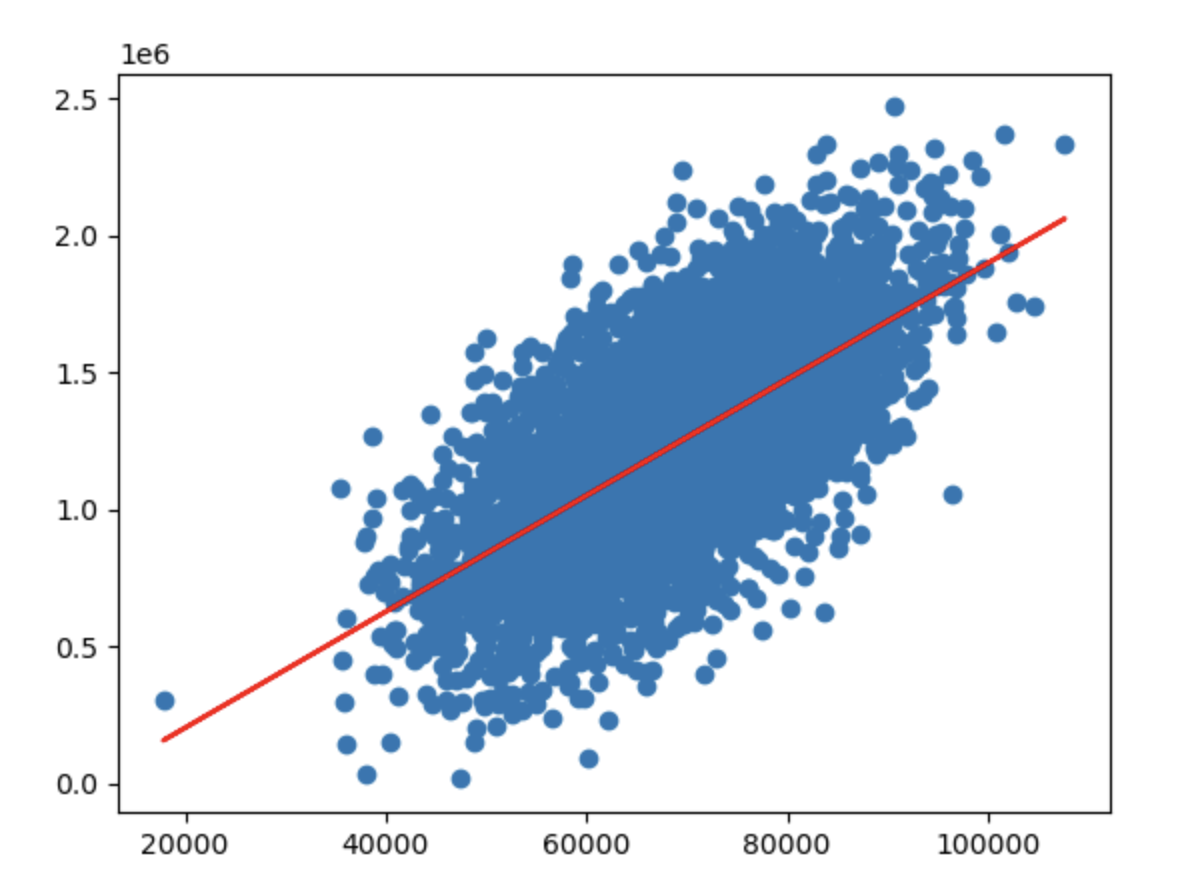
其实你看到,拟合出的线和散点数据的差距还是蛮大的。这就是因为还有其他因素在影响房价,这点我们会在下文的多因子模型中解决。
Step 5: 评估模型
那么如何定量地评估拟合出的线和散点数据的差距呢?这时候就需要使用 1.4. 评估线性回归模型模型表现 中讲过的均方误差(MSE)、R方值两者:
# 评估模型表现
from sklearn.metrics import r2_score
from sklearn.metrics import mean_squared_error

print(f"R2 = {r2_score(y, y_predict):.2f}")
print(f"MSE = {mean_squared_error(y, y_predict):.2f}")
输出:
R2 = 0.41
MSE = 73645940735.19
注:R方值越接近1就代表效果越好, MSE越小越代表效果越好。
通过R方值和MSE也确实看得出这个模型的效果不太好。
1.5.5. 多因子线性回归模型建立
任务目标:以Avg. Area Income、Avg. Area House Age、Avg. Area Number of Rooms、Avg. Area Number of Bedrooms、Area Population为输入变量,建立多因子模型,评估模型表现。
Step 1: 给x_multi和y赋值
其实多因子的线性回归模型大致上和单因子差不多。在赋值这块x就不止一个因子,所以命名为x_multi,y保持不变,依旧是Price:
# 给x_multi和y赋值
x_multi = data.drop(["Price", "Address"], axis=1)
y = data.loc[:, "Price"]

print(x_multi.head())
print(y.head())
drop是用于丢弃的方法。axis = 1告诉这个函数是丢弃列上指定的字段,axis = 0就是丢弃行上指定的字段
输出:
   Avg. Area Income  ...  Area Population
0      79545.458574  ...     23086.800503
1      79248.642455  ...     40173.072174
2      61287.067179  ...     36882.159400
3      63345.240046  ...     34310.242831
4      59982.197226  ...     26354.109472

[5 rows x 5 columns]
0    1.059034e+06
1    1.505891e+06
2    1.058988e+06
3    1.260617e+06
4    6.309435e+05
Name: Price, dtype: float64
Step 2: 训练模型
一样的使用线性回归模型,把x_multi和y喂给它来训练:
# 训练模型
from sklearn.linear_model import LinearRegression
model = LinearRegression()
model.fit(x_multi, y)
Step 3: 计算预测值
# 计算预测值
y_predict = model.predict(x_multi)
Step 4: 可视化预测结果
由于因子不止一个所以不可能画出来。这里我们采用画y和y_predict对应关系的散点图的方法:
# 可视化
import matplotlib.pyplot as plt
plt.scatter(y, y_predict)
散点越接近y = x这条直线分布就代表效果越好。
图片输出:
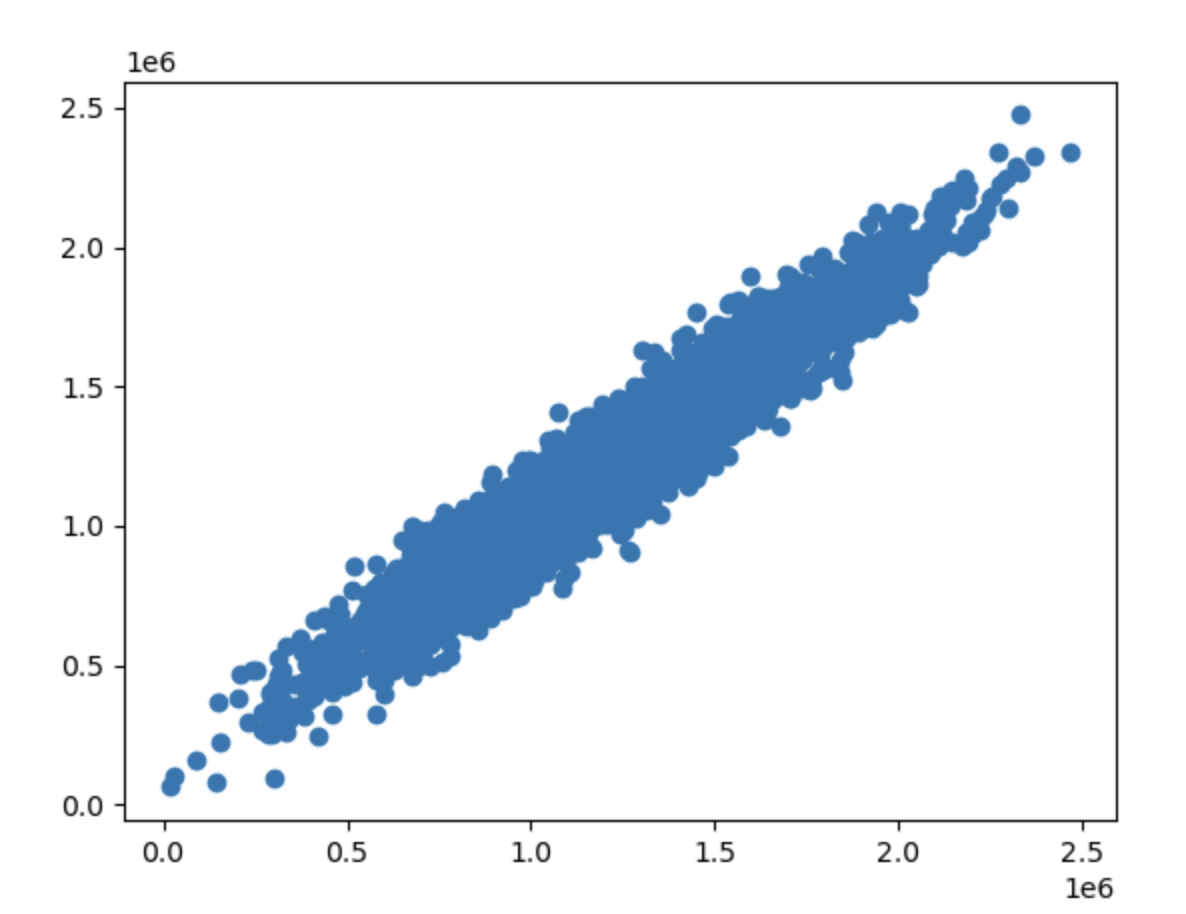
可以看出来效果非常好。
Step 5: 评估模型
一样的使用R方和MSE来评估:
# 评估模型
from sklearn.metrics import mean_squared_error
from sklearn.metrics import r2_score

print(f"MSE = {mean_squared_error(y, y_predict):.2f}")
print(f"R2 = {r2_score(y, y_predict):.2f}")
输出:
MSE = 10219734313.25
R2 = 0.92
我把单因子模型的结果也附在这里:
R2 = 0.41
MSE = 73645940735.19
可以直观地看出多因子模型比单因子的效果好了很多。
1.5.6. 针对具体值的预测
任务目标:预测Income为65000,House Age为5、Number of Rooms为5、Number of Bedrooms为3、Population为30000的合理房价。
Step 1: 输入和转换具体值
首先我们得把这些具体值放到数组里,再转为numpy的二维数组:
# 具体值的转化
import numpy as np
x_test = [65000, 5, 5, 3, 30000]
x_test = np.array(x_test).reshape(1, -1)
- 注意顺序要保持一致
Step 2: 用训练好的模型预测
# 用训练好的模型预测
y_test_predict = model.predict(x_test)
print(y_test_predict)
输出:
[657734.79447461]
1.6. 逻辑回归理论(基础)
1.6.1. 如何求解分类问题?
举个简单的例子:根据余额,判断小明是否会去看电影。
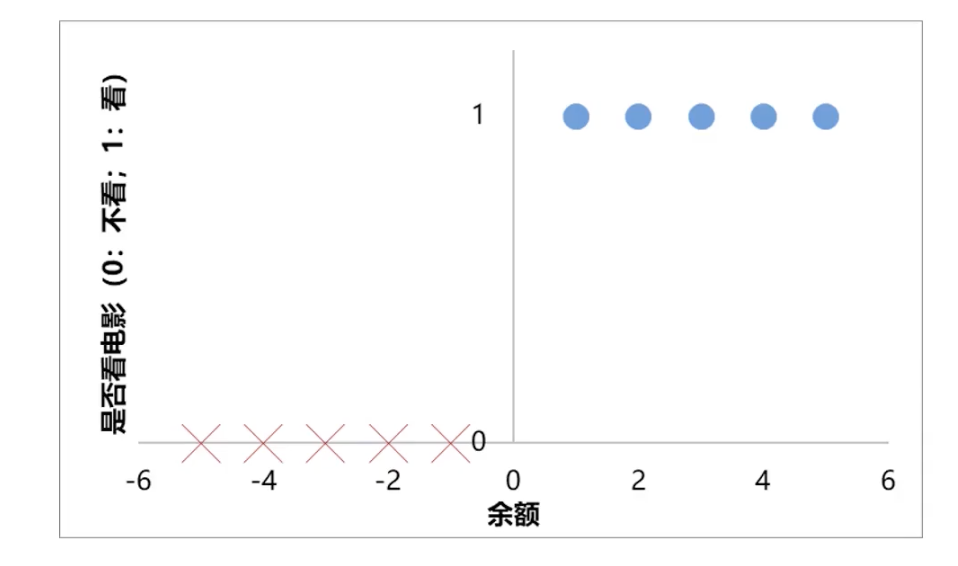
从这幅图中我们可以看到:
y = 0代表不看电影、y = 1代表去看电影- 余额为1、2、3、4、5时,去看电影(正样本)
- 余额为-1、-2、-3、-4、-5时,不看电影(负样本)
1.6.2. 分类任务基本框架
那么如何让计算器来进行这样的分类任务呢?我们需要数学的帮助: $$ \left{ \begin{array}{l} y = f(x_1, x_2 \cdots x_n) \ \text{判断为类别 } N, \text{ 如果 } y = n \end{array} \right. $$ 分类任务分成两步:
- 第一步是去求解预测出的结果,这个结果还不是我们最终想要的类别,而是类似于0、1、2这样的数字(离散的数)。
- 第二步就是根据这个数字来判断它属于什么类别,比如说0的时候代表不看电影,1的时候代表看电影
具体到我们这里的看电影这个例子中,数学表述就是:
$$
y = f(x) \in {0,1}
$$
f(x)的结果,也就是y,属于{0, 1},也就是说要么是0,要么是1。而在上文的图中我们也说过了y = 0代表不看电影(负样本)、y = 1代表去看电影(正样本).
那么此时这个例子的核心问题就转变为了寻找f(x)。
1.6.3. 通过线性回归求解分类问题
我们先采用一个非常简单的模型,就是我们之前讲的线性回归模型(原理详见 1.2. 线性回归理论)。使用这个模型的目的在于预测点的分布情况。
我们首先不管是正样本还是负样本,我们现在要做的只是把点的分布给模拟出来:
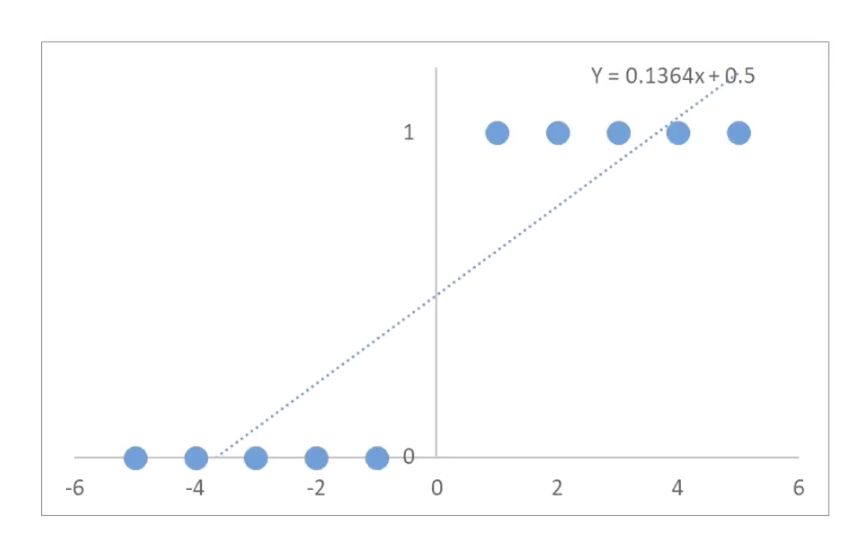
拟合出来的线是y = 0.1364x + 0.5,这就是展现点可能的分布的函数。
这条线上的点不只有0和1怎么办呢?很简单,我们只要取0和1的中点——0.5即可。只要是分布函数的y值大于0.5,我们就把它认定为是1,也就是去看电影;反之就认定为0,不会去看电影。
更专业地说,我们会把0.5叫做阈值。而这种把很多值(分布函数上的值)根据阈值最终整理为两个值(0或1)的操作叫做二值化。
这样一来我们就完成了一个非常简单的分类任务的预测。我们再来总结一下步骤: $$ \begin{aligned} (1) \quad Y &= 0.1364x + 0.5 \ (2) \quad y &= f(x) = \begin{cases} 1, & Y \geq 0.5 \ 0, & Y < 0.5 \end{cases} \end{aligned} $$
- 第一步是找出
f(x),也就是这里的Y - 第二步就是确定阈值,根据阈值来进行二次筛选
我们把Y带入原来的数据点,看一下效果:
| x | Y(x)分布函数的值 | y(x)二值化之后的值 | 实际y |
|---|---|---|---|
| -5 | -0.18 | 0 | 0 |
| -4 | -0.05 | 0 | 0 |
| -3 | 0.09 | 0 | 0 |
| -2 | 0.23 | 0 | 0 |
| -1 | 0.36 | 0 | 0 |
| 1 | 0.64 | 1 | 1 |
| 2 | 0.77 | 1 | 1 |
| 3 | 0.91 | 1 | 1 |
| 4 | 1.05 | 1 | 1 |
| 5 | 1.18 | 1 | 1 |
这么一看线性回归的效果好像还不错,但其实它的局限性还蛮大的。
1.6.4. 线性回归求解分类问题的局限性
线性回归的主要问题在于:极端离群点会严重扭曲拟合直线,从而降低分类准确率。
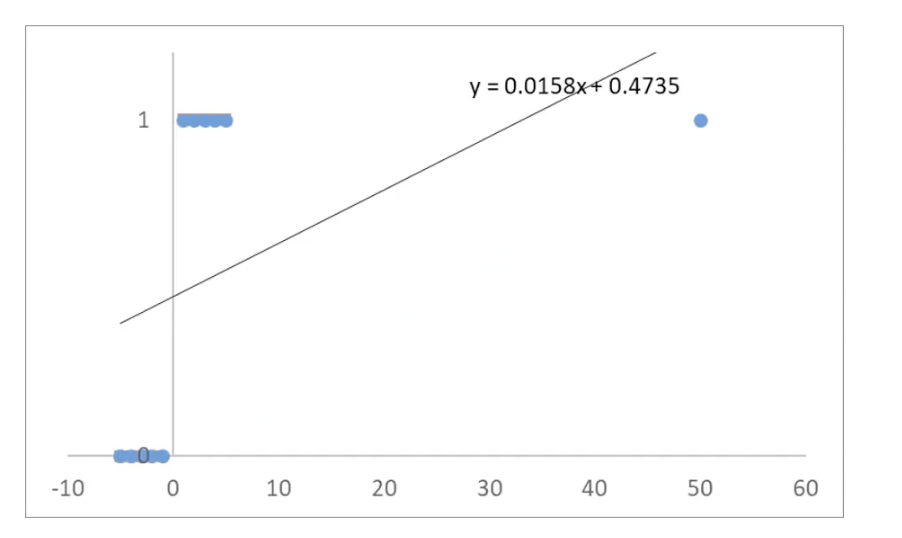
原本的数据中x的值仅在-5到5。而这时如果我们添加一个比较远的点,比如(50, 1),就会对线性回归计算出的线产生巨大的影响。
我们还是一样的把Y带入原来的数据点,看一下效果:
| x | Y(x)分布函数的值 | y(x)二值化之后的值 | 实际y |
|---|---|---|---|
| -5 | 0.39 | 0 | 0 |
| -4 | 0.41 | 0 | 0 |
| -3 | 0.43 | 0 | 0 |
| -2 | 0.44 | 0 | 0 |
| -1 | 0.46 | 0 | 0 |
| 1 | 0.49 | 0 | 1 |
| 2 | 0.51 | 1 | 1 |
| 3 | 0.52 | 1 | 1 |
| 4 | 0.54 | 1 | 1 |
| 5 | 0.55 | 1 | 1 |
| 50 | 1.26 | 1 | 1 |
当x = 1时,由于Y(x)的结果0.49,小于0.5,导致二值化之后y(x) = 0,但是实际情况是x = 1时y = 1。 |
1.6.5. 逻辑回归的原理
逻辑回归对于求解分类问题的第一步进行了优化:
$$
\begin{aligned}
(1) \quad Y &= \frac{1}{1 + e^{-x}} \
(2) \quad y &= f(x) =
\begin{cases}
1, & Y \geq 0.5 \
0, & Y < 0.5
\end{cases}
\end{aligned}
$$
之所以叫做逻辑回归是因为第一步的这个函数叫做Sigmoid函数(逻辑函数),它将输入x映射到 (0,1)之间。
它根据数据的特征或属性,计算其归属于某一类别的概率P(x),根据概率数值来判断其所属类别。
它的主要应用场景就是二分类问题(也就是只有两种可能性的问题)。
它的数学表达式是: $$ \begin{aligned} P(x) &= \frac{1}{1 + e^{-x}} \ y &= \begin{cases} 1, & P(x) \geq 0.5 \ 0, & P(x) < 0.5 \end{cases} \end{aligned} $$
y为类别结果P为概率分布x为特征值
它的效果如下:
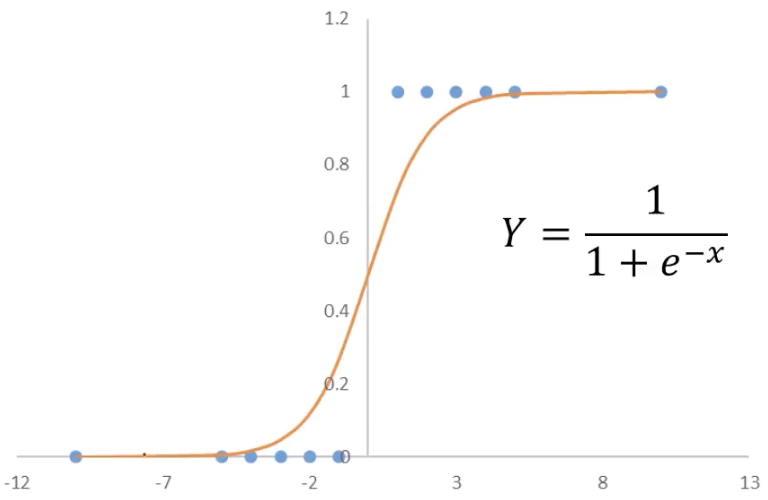
如果我们使用逻辑函数作为Y:
| x | Y(x)使用逻辑函数 | y(x)二值化之后的值 | 实际y |
|---|---|---|---|
| -5 | 0.01 | 0 | 0 |
| -4 | 0.02 | 0 | 0 |
| -3 | 0.05 | 0 | 0 |
| -2 | 0.12 | 0 | 0 |
| -1 | 0.27 | 0 | 0 |
| 1 | 0.73 | 1 | 1 |
| 2 | 0.88 | 1 | 1 |
| 3 | 0.95 | 1 | 1 |
| 4 | 0.98 | 1 | 1 |
| 5 | 0.99 | 1 | 1 |
| 50 | 1.00 | 1 | 1 |
| 1000 | 1.00 | 1 | 1 |
可以看到,即使加入了极端点 x = 50(甚至 x = 1000),分类结果仍然保持正确。
逻辑回归只是用于解决分类问题的一种模型(你可以使用其它模型,只是效果可能没这么好)。其实它的思想与线性回归差不多,只不过换用了逻辑函数。
1.6.6. 利用逻辑函数解问题
我们就用逻辑回归解决一下本文开篇提出的那个问题:根据余额,判断小明是否会去看电影(余额-10、100的情况下)
只需要带入逻辑方程即可:
余额为-10的情况下: $$ P(x = -10) = \frac{1}{1 + e^{10}} = 4.5 \times 10^{-5} < 0.5 $$ 由于计算出的值小于0.5,所以会被二值化为0,也就是不会去看电影。
余额为100的情况下: $$ P(x = 100) = \frac{1}{1 + e^{-100}} = 1 > 0.5 $$ 由于计算出的值大于0.5,所以会被二值化为1,也就是会去看电影。
1.7. 逻辑回归理论(进阶)
1.7.1. 多维度(因子)逻辑回归问题
在上一篇文章 1.6. 逻辑回归理论(基础) 中我们讨论了简单的逻辑回归问题。这篇文章我们来讨论复杂的逻辑回归问题:
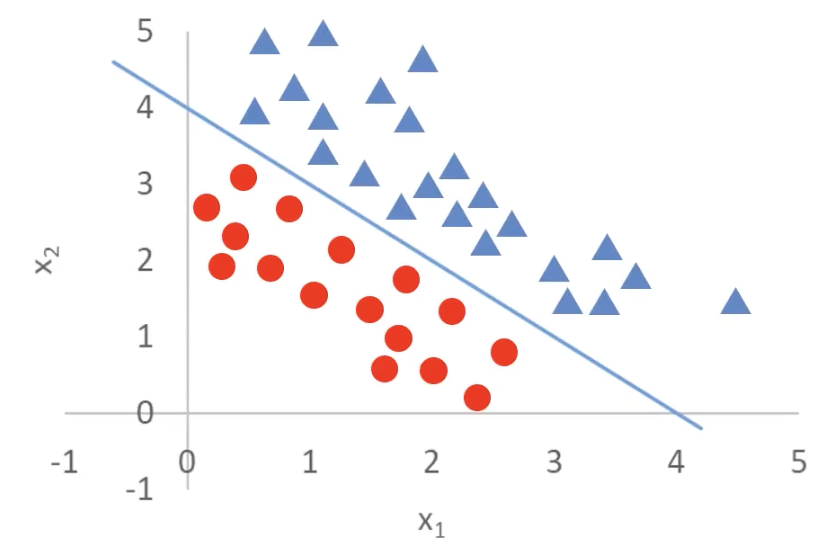
原来我们只有一个维度(比如说小明的余额),但这个图里我们有两个维度——x_1和x_2。
虽然这个图看上去仍然是一个二维图像,但是它的两个轴都是输入变量。实际的输出是图中的三角形和圆形。
也就是说,这里的目标是通过x_1和x_2去分辨三角形和圆形。
怎么去求解呢?对于逻辑回归问题肯定得用逻辑函数: $$ P(x) = \frac{1}{1 + e^{-x}} $$ 但是这个函数的参数只有一个,所以我们得改一下: $$ \begin{aligned} P(x) &= \frac{1}{1 + e^{-g(x)}} \ g(x) &= \theta_0 + \theta_1 x_1 + \theta_2 x_2 \end{aligned} $$
- 把
e的指数中的x替换为了g(x) - 而
g(x)实际上是一个线性回归方程,代表了图中的蓝色线,其中:θ_0是截距(bias)θ_1,θ_2是特征的权重(回归系数)x_1,x_2是输入的两个特征(因子)
不仅如此,这里我们只展示了有两个输入变量的情况,g(x)还可以有更多的输入变量:
$$
g(x) = \theta_0 + \theta_1 x_1 + \theta_2 x_2 + \dots + \theta_n x_n
$$
g(x),也就是蓝色这条线通过点(4,0)和(0,4),可以表示为:
$$
x_1 + x_2 = 4
$$
就可以等价地写为:
$$
g(x) = -4 + x_1 + x_2 = 0
$$
这条线又叫决策边界(decision boundary)。有了决策边界之后,我们就能把三角形和圆形的分开: $$ \begin{aligned} g(x) = -4 + x_1 + x_2 > 0 & : \text{ 三角形} \ g(x) = -4 + x_1 + x_2 < 0 & : \text{ 圆形} \end{aligned} $$
对于多维度(因子)的逻辑回归问题来说,最重要也是最难的步骤就是找出这条决策边界。
这时候再增加一点难度,如果决策边界是圆怎么办?
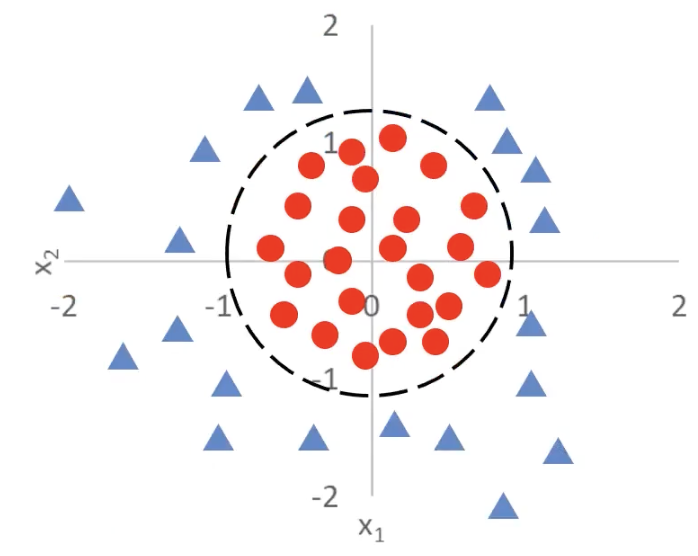
首先确定逻辑函数是保持不变的:
$$
P(x) = \frac{1}{1 + e^{-g(x)}}
$$
目标是要找出决策曲线,也就是逻辑函数中的g(x)这一项的表达式。
这里我提供两种解法:
方法1: 根据圆的表达式来推导
其实很简单,大家还记得圆在平面直角坐标系的表达式吗:
$$
(x - a)^2 + (y - b)^2 = r^2
$$
由于这里圆心在原点上,所以可以化简为:
$$
x^2 + y^2 = r^2
$$
因为图中决策曲线这个圆过了(1,0)、(-1,0)、(0,1)、(0,-1),所以知道半径r = 1,代入原式:
$$
x^2 + y^2 = 1
$$
再移项即可得:
$$
g(x) = -1 + x^2 + y^2 = 0
$$
这就是我们所要的决策边界解析式,由此可得:
$$
g(x) = -1 + x_1^2 + x_2^2 \begin{cases} > 0, & \text{三角形} \
< 0, & \text{圆形}
\end{cases}
$$
方法2: 从回归方程推导
我们都知道线性回归方程基本式长这样:
$$
g(x) = \theta_0 + \theta_1 x_1 + \theta_2 x_2
$$
但是我们这里是有曲线的,所以不可能是线性的。也就是说,x的指数不可能只有1次。所以我们要引入二次项:
$$
g(x) = \theta_0 + \theta_1 x_1 + \theta_2 x_2 + \theta_3 x_1^2 + \theta_4 x_2^2
$$
x_1^2和x_2^2是新的非线性特征,用于捕捉曲线(尤其是圆形)模式- 这样,我们的决策边界可以不再是直线,而是更复杂的形状,比如椭圆或圆
如果我们进一步简化,只保留二次项(假设θ_1 = θ_2 = 0),我们得到:
$$
g(x) = \theta_0 + \theta_3 x_1^2 + \theta_4 x_2^2
$$
令θ_0 = -r^2 ,θ_3 = θ_4 = 1,我们得到:
$$
g(x) = x_1^2 + x_2^2 - r^2
$$
当g(x) = 0时:
$$
x_1^2 + x_2^2 = r^2
$$
这正是圆的方程!然后我们就可以根据法1的逻辑推理到g(x)的解析式了。
从这些例子我们可以看出:逻辑回归结合多项式边界函数可以解决复杂的分类问题。
1.7.2. 逻辑回归的本质
我们把逻辑回归的函数放在这里:
$$
\begin{aligned}
P(x) &= \frac{1}{1 + e^{-g(x)}} \
g(x) &= \theta_0 + \theta_1 x_1 + \theta_2 x_2 + …
\end{aligned}
$$
根据刚才的讲解,我们清楚了:逻辑回归问题的关键在于寻找决策边界g(x),而寻找逻辑边界g(x)的关键就在于寻找参数θ_0、θ_1、θ_2…
有没有觉得熟悉?寻找g(x)中各项的参数不就是线性回归模型在做的事吗!那我可不可以用最小化损失函数呢:
$$
\textit{minimize} \left{ \frac{1}{2m} \sum_{i=1}^{m} (y’_i - y_i)^2 \right}
$$
会让你感到失望的是,平方误差在这里并不是好选择。即便我们使用 Sigmoid 输出的连续概率,对逻辑回归使用 MSE 也会得到非凸优化问题,而且当模型“错得很自信”时梯度会变得很小,训练不稳定。
最小化损失这个思路本身没有问题,我们只是需要更合适的损失函数。常用的是交叉熵(对数)损失,它与逻辑回归天然匹配(也出现在 Nelder 与 Wedderburn 提出的广义线性模型框架中): $$ J_i = \begin{cases}
- \log(P(x_i)), & \text{if } y_i = 1 \
- \log(1 - P(x_i)), & \text{if } y_i = 0 \end{cases} $$ 它的核心思想是:
- 当
y = 1时(也就是真实情况是1),你计算出的P(x)(也就是你的模型预估出的情况)越接近1就代表损失越小,越接近0就代表损失越大 - 当
y = 0时(也就是真实情况是0),你计算出的P(x)(也就是你的模型预估出的情况)越接近0就代表损失越小,越接近1就代表损失越大

把两个方程式结合起来,转化为下面这个方程,获得交叉熵损失的平均值: $$ J = \frac{1}{m} \sum_{i=1}^{m} J_i = -\frac{1}{m} \left[ \sum_{i=1}^{m} \left( y_i \log P(x_i) + (1 - y_i) \log (1 - P(x_i)) \right) \right] $$ 而其中: $$ \begin{aligned} P(x) &= \frac{1}{1 + e^{-g(x)}} \ g(x) &= \theta_0 + \theta_1 x_1 + \theta_2 x_2 + … \end{aligned} $$ 所以说逻辑回归最核心的就是: $$ \textit{minimize} \left{ J(\theta) \right} $$
1.7.3. 最小化损失函数
我们知道了如何计算损失之后,又该如何最小化它呢?其实它的思路跟线性回归的梯度下降法差不多。
我们先来回顾一下梯度下降法: $$ p_{i+1} = p_i - \alpha \frac{\partial}{\partial p_i} f(p_i) $$
p_i+1是更新后的参数值,由当前值p_i进行调整α(学习率):控制每次更新的步长α后面跟的那一串是函数f(p)在当前点p_i处的梯度(偏导数),表示f(p)在该点变化的方向和大小。
逻辑回归也要运用梯度下降法: $$ \left{ \begin{array}{l} \textit{temp}{\theta_j} = \theta_j - \alpha \frac{\partial}{\partial \theta_j} J(\theta) \ \theta_j = \textit{temp}{\theta_j} \end{array} \right. $$ 也是一样的通过系数减梯度不断重复计算直到函数收敛。
1.8. 逻辑回归实战(基础)
1.8.1. 使用matplotlib画分类散点图
我想大家都知道未分类别的散点图是怎么画的:
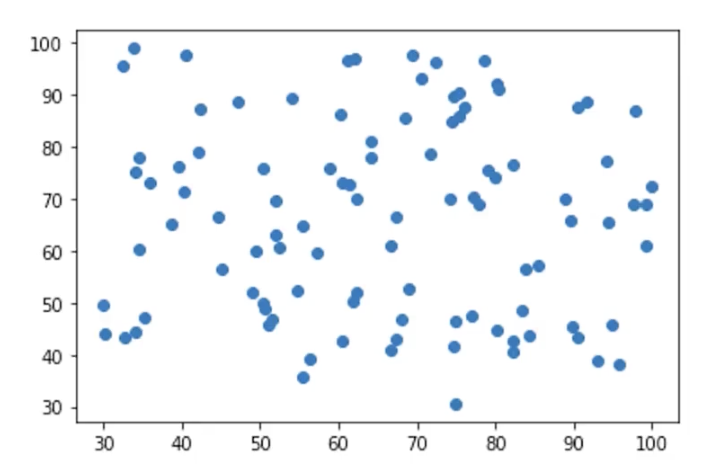
plt.scatter(x1, x2)
但在分类问题中你会需要把不同的类别的点体现出来,你可以改颜色,也可以改形状,也可以两者都改:
假设我们有两个特征x1和x2,以及类别标签y(0和1)。其中,类别0用红色圆点(o) 表示,类别1用蓝色三角形(^) 表示。
import numpy as np
import matplotlib.pyplot as plt

# 生成随机数据
np.random.seed(42)
x1 = np.random.randn(20)
x2 = np.random.randn(20)
y = np.random.randint(0, 2, 20)  # 随机分类 0 或 1

# 过滤数据
class_0 = (y == 0)
class_1 = (y == 1)

# 绘制散点图
plt.figure(figsize=(6, 5))

# 绘制类别 0(红色圆形)
plt.scatter(x1[class_0], x2[class_0], c='red', marker='o', label="Class 0")

# 绘制类别 1(蓝色三角形)
plt.scatter(x1[class_1], x2[class_1], c='blue', marker='^', label="Class 1")

# 添加图例和标签
plt.xlabel("Feature x1")
plt.ylabel("Feature x2")
plt.title("Scatter Plot of Two Classes")
plt.legend()
plt.grid(True)

# 显示图形
plt.show()
-
生成数据:
- 使用
np.random.randn()生成两个特征x1和x2(随机正态分布) np.random.randint(0, 2, 20)生成20个随机分类标签(0或1)
- 使用
-
数据筛选:
- 通过
class_0 = (y == 0)和class_1 = (y == 1)选取不同类别的数据
- 通过
-
绘制散点图:
- 用
plt.scatter()分别绘制类别0和1,并设定不同的 颜色(c) 和 形状(marker):类别 0(红色圆形o)、类别 1(蓝色三角形^)
- 用
-
增强可视化:
- 通过
plt.legend()添加图例,使类别区分更清晰 plt.grid(True)添加网格,提高可读性
- 通过
输出图片:
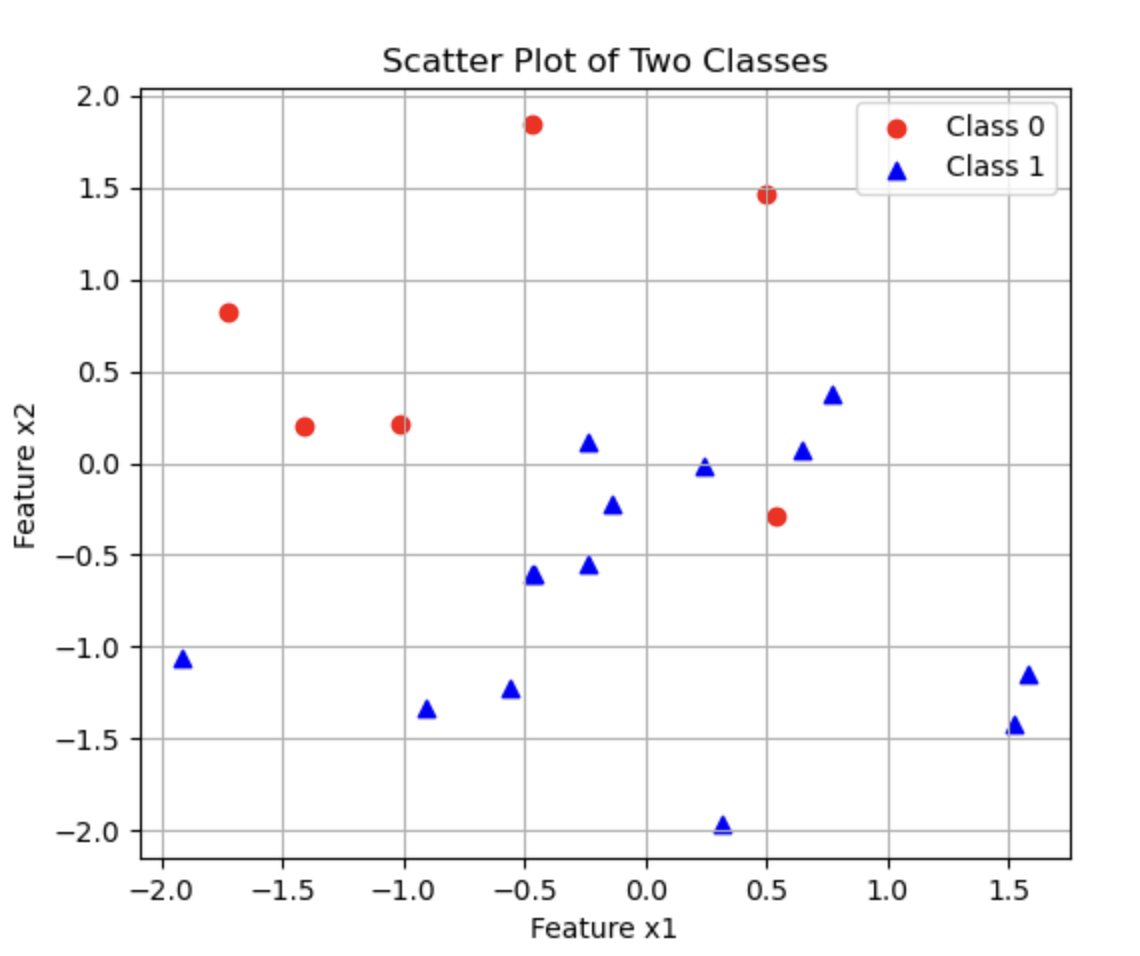
1.8.2. 逻辑回归的代码实现
接下来,请你确保你的Python环境中有pandas、matplotlib、scikit-learn和numpy这几个包,如果没有,请在终端输入指令以下载和安装:
pip install pandas matplotlib scikit-learn numpy
Step 1: 准备数据
这里需要使用到我的csv文件,我把它上传到了GitCode,你点击链接即可查看和下载。
它有3栏信息,一栏是x1,一栏是x2,这两栏代表两个输入变量。另一栏是success_or_fail,这一栏数据要么是0要么是1,1代表成功,0代表失败。
下载好后把它移到你的Python项目文件夹里即可。
Step 2: 读取数据
我们依旧使用pandas库来读取数据:
# 读取数据
import pandas as pd
data = pd.read_csv('Logistic_Regression_Data.csv')

print(data.head())
输出:
   x1  x2  success_or_fail
0   6   2                0
1  19  11                1
2  14   7                1
3  10   2                0
4   7   0                0
如果你有一样的输出就代表没问题。
我们还可以用上文我们介绍过的画分类别的散点图的知识来可视化这些数据:
# 可视化数据
import matplotlib.pyplot as plt

x1 = data.loc[:,'x1'].to_numpy()
x2 = data.loc[:,'x2'].to_numpy()
y = data.loc[:,'success_or_fail'].to_numpy()

class_0 = (y == 0)
class_1 = (y == 1)

# 绘制类别 0(红色圆形)
plt.scatter(x1[class_0], x2[class_0], c='red', marker='o', label="Class 0")

# 绘制类别 1(蓝色三角形)
plt.scatter(x1[class_1], x2[class_1], c='blue', marker='^', label="Class 1")

# 添加图例和标签
plt.xlabel("Feature x1")
plt.ylabel("Feature x2")
plt.title("Scatter Plot of Two Classes")
plt.legend()

# 显示图形
plt.show()
输出图片:
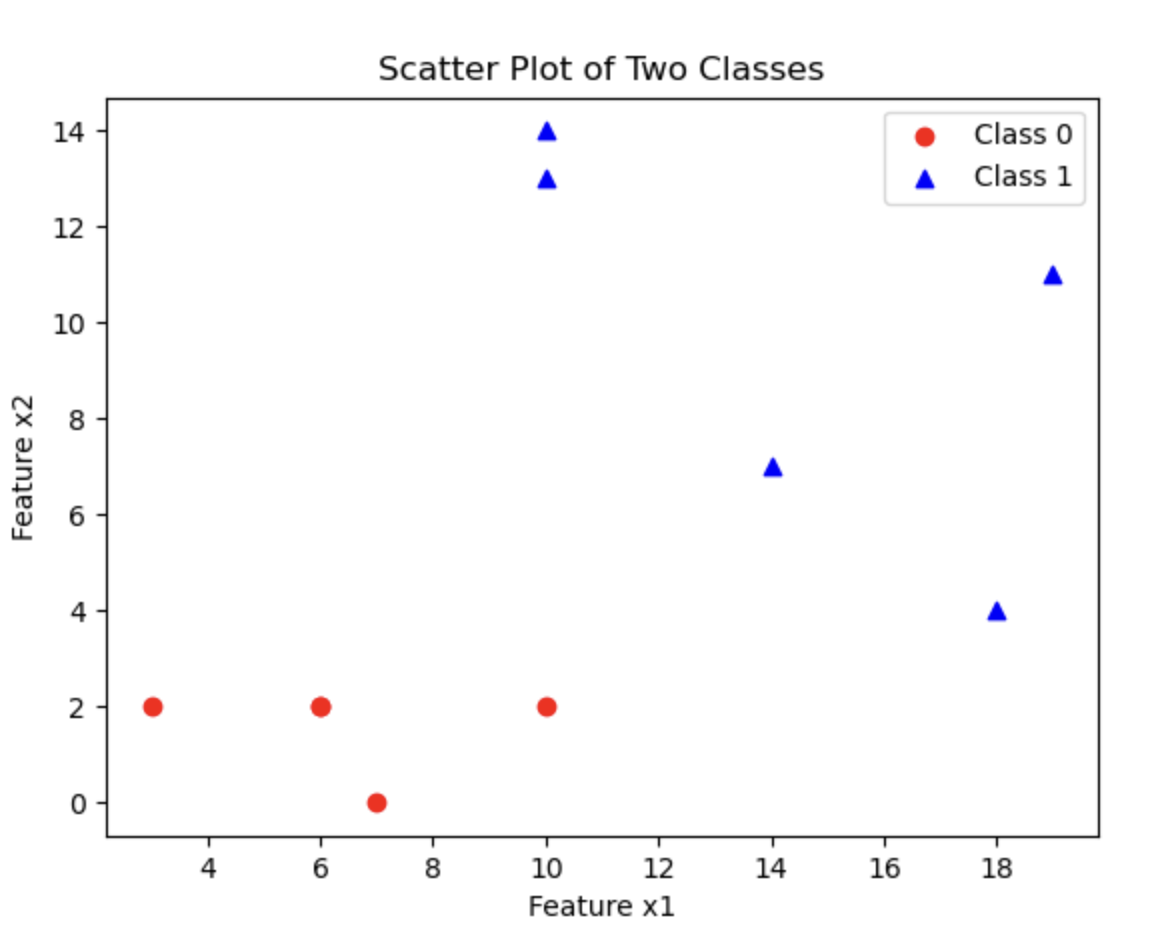
Step 2: 给x和y赋值
我们要首先明确x和y代表什么:
x代表的是输入变量,也就是x1和x2y是success_or_fail这一栏的数据
# 给x和y赋值
x = data.drop(['success_or_fail'], axis=1)
y = data.loc[:,'success_or_fail']
- 使用
drop函数丢弃指定的字段,保留其它字段。这里写的是'success_or_fail',那就丢弃它,axis=1告诉程序丢弃的是'success_or_fail'这一列而不是行。
Step 3: 训练模型
把数据喂给scikit-learn下的逻辑回归模型进行训练即可:
# 训练模型
from sklearn.linear_model import LogisticRegression
model = LogisticRegression()
model.fit(x, y)
Step 4: 获取决策边界
我们可以通过coef_和intercept_两个方法分别获得截距和系数:
# 获取决策边界
theta1, theta2 = model.coef_[0]
theta0 = model.intercept_[0]

print(f"Decision Boundary: y = {theta1}x1 + {theta2}x2 + {theta0}")
- 由于我们有两个输入变量,所以就有两个系数
theta1和theta2
这些值也就对应了上一篇文章 1.7. 逻辑回归理论(进阶) 中所讲的公式的各个参数: $$ g(x) = \theta_0 + \theta_1 x_1 + \theta_2 x_2 $$ 输出:
Decision Boundary: y = 0.5729567667358711x1 + 0.5997810709872152x2 + -9.324928012209842
Step 5: 获取预测值
# 获取预测值
prediction = model.predict(x)

print(prediction)
输出:
[0 1 1 0 0 0 1 1 1 0]
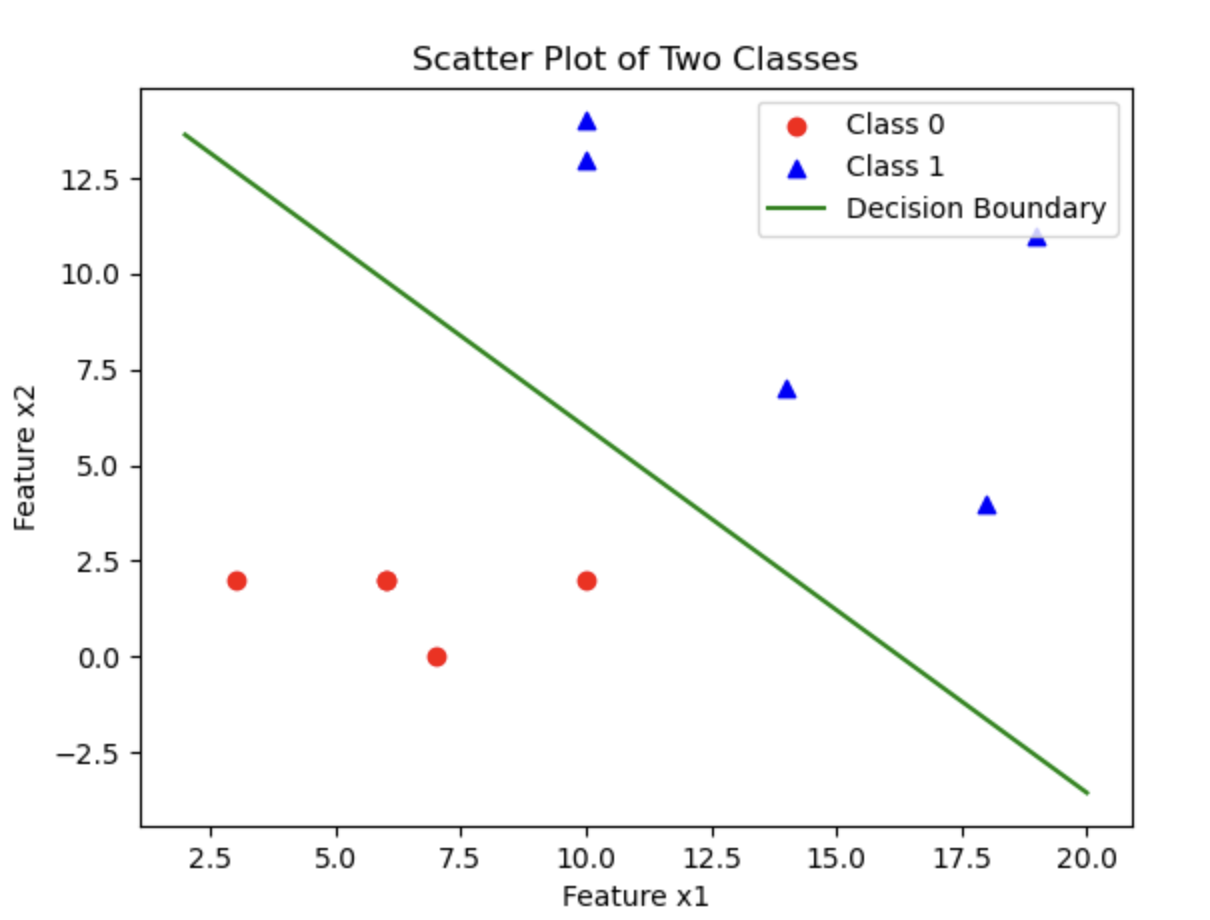
Step 6: 可视化决策边界
我们现在来把决策边界画出来:
# 可视化数据
import matplotlib.pyplot as plt

x1 = data.loc[:, 'x1'].to_numpy()
x2 = data.loc[:, 'x2'].to_numpy()
y = data.loc[:, 'success_or_fail'].to_numpy()

class_0 = (y == 0)
class_1 = (y == 1)

# 绘制类别 0(红色圆形)
plt.scatter(x1[class_0], x2[class_0], c='red', marker='o', label="Class 0")

# 绘制类别 1(蓝色三角形)
plt.scatter(x1[class_1], x2[class_1], c='blue', marker='^', label="Class 1")

# 绘制决策边界
import numpy as np

# 计算 x1 的范围
x1_min, x1_max = x1.min() - 1, x1.max() + 1
x1_range = np.linspace(x1_min, x1_max, 100)

# 使用决策边界公式计算 x2
x2_boundary = -(theta1 * x1_range + theta0) / theta2

# 绘制决策边界
plt.plot(x1_range, x2_boundary, color='green', label="Decision Boundary")

# 添加图例和标签
plt.xlabel("Feature x1")
plt.ylabel("Feature x2")
plt.title("Scatter Plot of Two Classes")
plt.legend()

# 展示
plt.show()
-
x1.min()和x1.max():找到训练数据中x_1的最小值和最大值 -
x1.min() - 1和x1.max() + 1:在边界外稍微扩展一点,保证绘制的直线不会刚好卡在边界上,视觉上更好 -
np.linspace(x1_min, x1_max, 100):- 生成 100 个均匀分布的
x_1值,形成一个连续的 x 轴范围 - 这样可以绘制一条平滑的直线
- 生成 100 个均匀分布的
-
x1_range传入后,可以计算出100个对应的x_2值,形成一条直线
输出图片:
1.8.3. 评估模型表现
对于比较少的数据,我们可以直接画图来看模型效果(如上图)。对于比较多的数据,我们要定量地评估就不能只靠图了。
评估逻辑回归模型相比起评估线性回归模型要简单一些,使用准确率来评判即可: $$ Accuracy = \frac{正确预测样本数量}{总样本数量} $$ 准确率肯定是越接近1越好。但是不要过于追求准确率,否则会导致过拟合问题。
我们可以用scikit-learn提供的代码来计算准确率:
# 计算准确率
from sklearn.metrics import accuracy_score
accuracy = accuracy_score(y, prediction)
print(f"Accuracy: {accuracy}")
输出:
Accuracy: 1.0
这说明我们的模型非常成功,是百分百的正确率(其实看图也看得出来)。
1.9. 逻辑回归实战(进阶)
1.9.1. 一些准备工作
接下来,请你确保你的Python环境中有pandas、matplotlib、scikit-learn和numpy这几个包,如果没有,请在终端输入指令以下载和安装:
pip install pandas matplotlib scikit-learn numpy
我把.csv数据文件放在GitCode上了,点击链接即可下载。
训练数据有3栏:exam1、exam2和exam3_pass_or_not。exam1和exam2里填写的是学生在两次考试中的成绩(可以是浮点数,满分100),exam3_pass_or_not代表第三次考试有没有通过,通过是1,没通过是0。我们的目标就是训练逻辑回归模型去找到exam3_pass_or_not的决策边界。
下载好后把它移到你的Python项目文件夹里即可。
1.9.2. 建立一阶边界模型
在上一篇文章 1.8. 逻辑回归实战(基础) 中我们介绍了如何建立简单的一阶边界模型,这里就不再详细讲解了,我就直接把代码和输出贴在这里:
# 读取数据
import pandas as pd
data = pd.read_csv('exam_results.csv')

# 给x和y赋值
x = data.drop(['exam3_pass_or_not'], axis=1)
y = data.loc[:, 'exam3_pass_or_not']

# 训练模型
from sklearn.linear_model import LogisticRegression
model = LogisticRegression()
model.fit(x, y)

# 获取决策边界
theta1, theta2 = model.coef_[0]
theta0 = model.intercept_[0]

# 获取预测值
prediction = model.predict(x)

# 可视化
import matplotlib.pyplot as plt
import numpy as np

x1 = data.loc[:, 'exam1'].to_numpy()
x2 = data.loc[:, 'exam2'].to_numpy()
y = data.loc[:, 'exam3_pass_or_not'].to_numpy()

class0 = (y == 0)
class1 = (y == 1)

plt.scatter(x1[class0], x2[class0], c='r', marker='o')
plt.scatter(x1[class1], x2[class1], c='b', marker='x')
plt.xlabel('exam1')
plt.ylabel('exam2')

# 计算 x1 的范围
x1_min, x1_max = x1.min() - 1, x1.max() + 1
x1_range = np.linspace(x1_min, x1_max, 100)

# 使用决策边界公式计算 x2
x2_boundary = -(theta1 * x1_range + theta0) / theta2

# 绘制决策边界
plt.plot(x1_range, x2_boundary, color='green', label="Decision Boundary")

# 展示
plt.legend()
plt.show()

# 计算准确率
from sklearn.metrics import accuracy_score
accuracy = accuracy_score(y, prediction)
print(f'Accuracy: {accuracy}')
输出:
Accuracy: 0.972
输出图片:
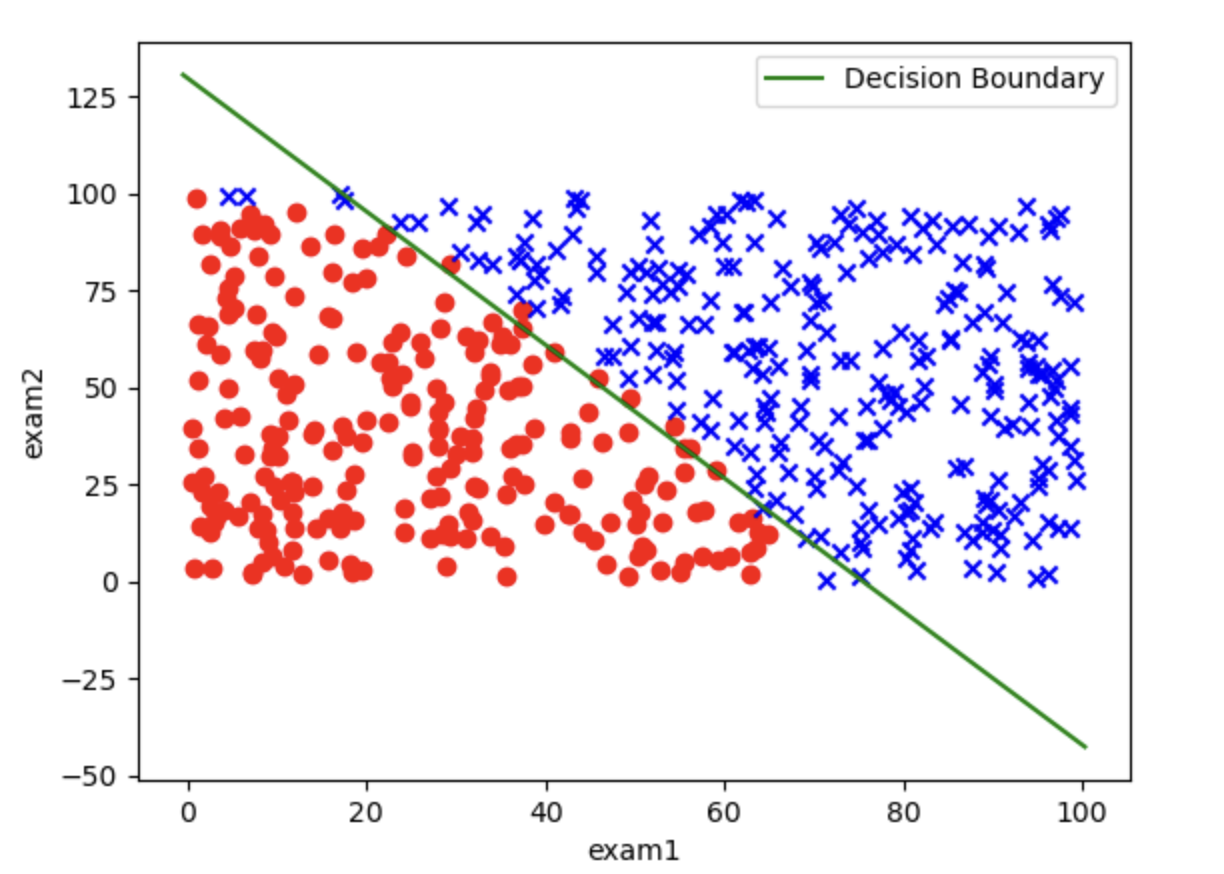
可以看到,有一些数据确实呗决策曲线错分类了,这是一阶决策边界(一条直线)的极限了。如果还要提升准确率就需要建立二阶的决策边界(一条曲线)。
1.9.3.建立二阶决策边界
Step 1: 读取数据
一样的使用pandas库来读取csv文件,顺便使用head方法来查看一下数据的前几项:
# 读取数据
import pandas as pd
data = pd.read_csv('exam_results.csv')

print(data.head())
输出:
       exam1      exam2  exam3_pass_or_not
0  37.454012  69.816171                  0
1  95.071431  53.609637                  1
2  73.199394  30.952762                  1
3  59.865848  81.379502                  1
4  15.601864  68.473117                  0
我们还可以使用上一篇文章 1.8. 逻辑回归实战(基础) 中教过的画有分类的散点图方法来直观的看看数据:
# 可视化原始数据
import matplotlib.pyplot as plt
x1 = data.loc[:, 'exam1'].to_numpy()
x2 = data.loc[:, 'exam2'].to_numpy()
y = data.loc[:, 'exam3_pass_or_not'].to_numpy()

class0 = ( y == 0 )
class1 = ( y == 1 )

plt.scatter(x1[class0], x2[class0], c='r', marker='o')
plt.scatter(x1[class1], x2[class1], c='b', marker='x')
plt.xlabel('exam1')
plt.ylabel('exam2')
plt.show()
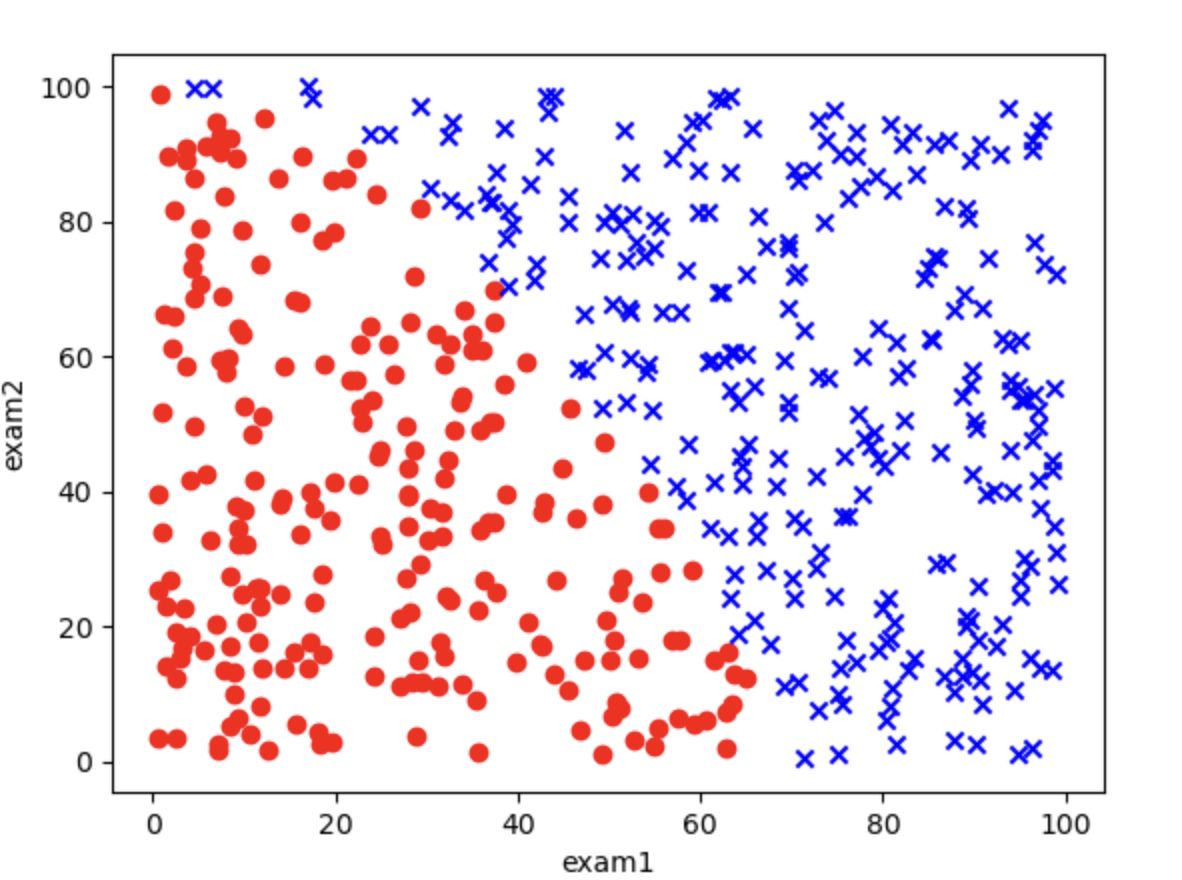
输出图片:
Step 2: 给x和y赋值
我们要首先明确x和y代表什么:
y是exam3_pass_or_not这一栏的数据
x有些特别,由于我们建立的是二阶模型,所以方程的项跟原来比更复杂:
$$
\theta_0 + \theta_1 X_1 + \theta_2 X_2 + \theta_3 X_1^2 + \theta_4 X_2^2 + \theta_5 X_1 X_2 = 0
$$
有x_1^2、x_2^2、X_1 * x_2这些项。所以我们得把这些项打包在字典里,再转为模型能使用的DataFrame格式给它使用。
# 给x和y赋值
y = data.loc[:, 'exam3_pass_or_not']
x1 = data.loc[:, 'exam1']
x2 = data.loc[:, 'exam2']
x = {
    'x1': x1,
    'x2': x2,
    'x1^2': x1 ** 2,
    'x2^2': x2 ** 2,
    'x1*x2': x1 * x2,
}

x = pd.DataFrame(x)
print(x.head())
输出:
          x1         x2         x1^2         x2^2        x1*x2
0  37.454012  69.816171  1402.803006  4874.297789  2614.895713
1  95.071431  53.609637  9038.576924  2873.993140  5096.744851
2  73.199394  30.952762  5358.151308   958.073452  2265.723399
3  59.865848  81.379502  3583.919807  6622.623341  4871.852929
4  15.601864  68.473117   243.418162  4688.567787  1068.308266
这是最基础的一种方法,还有一种简单的方法来生成这个字典:
from sklearn.preprocessing import PolynomialFeatures
poly = PolynomialFeatures(degree=2, include_bias=False)
x = data.drop(['exam3_pass_or_not'], axis=1)
x = poly.fit_transform(x)
poly = PolynomialFeatures(degree=2, include_bias=False)中先创建了一个PolynomialFeatures实例,然后通过degree参数来调整是几次的多项式,我写的是2生成的就会是2次多项式;include_bias=False避免再额外生成一列全为1的偏置项(截距仍由LogisticRegression的intercept_负责)。- 使用
data.drop(['exam3_pass_or_not'], axis = 1)来去掉最后一列的数据,保留前两列 - 使用
poly上的fit_transform方法来生成特征矩阵。注意:PolynomialFeatures生成的特征列顺序与上面手动字典不完全相同,因此后面按手动字典顺序解包theta、打印和画边界的代码,应配合手动字典那条路径使用。
Step 3: 训练模型
把数据喂给scikit-learn下的逻辑回归模型进行训练即可:
# 训练模型
from sklearn.linear_model import LogisticRegression
model = LogisticRegression()
model.fit(x, y)
Step 4: 获取决策边界
我们可以通过coef_和intercept_两个方法分别获得截距和系数:
# 获取决策边界
theta1, theta2, theta3, theta4, theta5 = model.coef_[0]
theta0 = model.intercept_[0]

print(f'Decision Boundary: {theta0} + {theta1}x1 + {theta2}x2 + {theta3}x1^2 + {theta4}x2^2 + {theta5}x1*x2')
这里面的每个变量都对应着方程中的参数: $$ \theta_0 + \theta_1 X_1 + \theta_2 X_2 + \theta_3 X_1^2 + \theta_4 X_2^2 + \theta_5 X_1 X_2 = 0 $$
输出:
Decision Boundary: -204.44094927587327 + -1.0566693402530631x1 + 1.3772537803356335x2 + 0.057584352318122055x1^2 + 0.006716600903162952x2^2 + 0.010830701167147672x1*x2
Step 5: 获取预测值
# 获取预测值
prediction = model.predict(x)
由于我们有500个数据,打出来太多了,这里就不进行打印了。
Step 6: 可视化决策边界
这里可视化决策边界稍微有点复杂,因为是二阶的项变多了,但是思路是暴力且简单的:我们都知道了所有的theta值,就是把解析式得出来了。接着根据x_1、x_2值和直接算对应的点即可。
# 可视化
import matplotlib.pyplot as plt
import numpy as np

x1 = x1.to_numpy()
x2 = x2.to_numpy()
y = y.to_numpy()

class0 = (y == 0)
class1 = (y == 1)

plt.scatter(x1[class0], x2[class0], c='r', marker='o')
plt.scatter(x1[class1], x2[class1], c='b', marker='x')
plt.xlabel('exam1')
plt.ylabel('exam2')

# 可视化二阶决策边界

# 定义exam1和exam2的范围,为了画网格
x1_min, x1_max = x1.min() - 1, x1.max() + 1
x2_min, x2_max = x2.min() - 1, x2.max() + 1

# 生成网格数据
xx1, xx2 = np.meshgrid(np.linspace(x1_min, x1_max, 500),
                       np.linspace(x2_min, x2_max, 500))

# 计算每个点的决策边界值
z = (theta0 +
     theta1 * xx1 +
     theta2 * xx2 +
     theta3 * xx1 ** 2 +
     theta4 * xx2 ** 2 +
     theta5 * xx1 * xx2)

# 绘制样本点
plt.scatter(x1[class0], x2[class0], c='r', label='Not Pass', marker='o')
plt.scatter(x1[class1], x2[class1], c='b', label='Pass', marker='x')

# 绘制决策边界
plt.contour(xx1, xx2, z, levels=[0], colors='g')

# 添加标签和图例
plt.xlabel('Exam1 Score')
plt.ylabel('Exam2 Score')
plt.legend()
plt.title('Decision Boundary')
plt.show()
- 网格生成 (
np.meshgrid):生成exam1和exam2值的坐标网格,用于计算每一个点的决策值 - 决策值计算 (
z):z是决策函数的值,基于 logistic 回归的系数和截距 - 等高线画图 (
plt.contour):plt.contour()方法可以绘制出特定值(比如0对应决策边界)的等高线
输出图片:
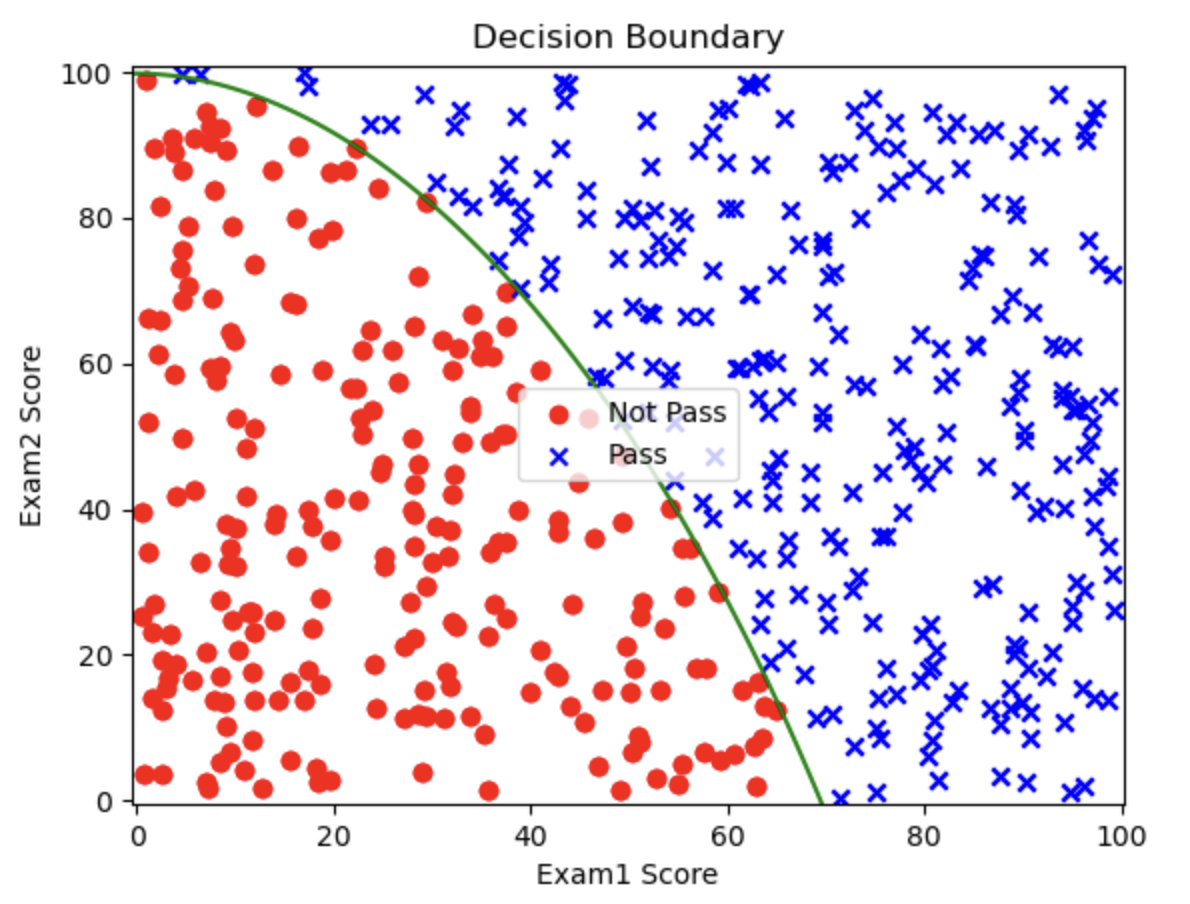
可以看到,这个决策边界的误判率低了很多。下面我们通过计算准确率来定量分析。
Step 7: 计算准确率
# 计算准确率
from sklearn.metrics import accuracy_score
accuracy = accuracy_score(y, prediction)
print(f'Accuracy: {accuracy}')
输出:
Accuracy: 1.0
百分百的正确率说明我们这个模型很成功。
1.10. 逻辑回归实战(高阶)
1.10.1. 一些准备工作
这篇文章我们会在 1.9. 逻辑回归实战(进阶) 的基础上再进一步,讲一下如何找(类)圆形的决策边界。
圆形的回归边界大部分时候都会是二阶的,但有的时候数据很复杂,就会需要更多阶,本文涉及的就是这部分。
接下来,请你确保你的Python环境中有pandas、matplotlib、scikit-learn和numpy这几个包,如果没有,请在终端输入指令以下载和安装:
pip install pandas matplotlib scikit-learn numpy
我把.csv数据文件放在GitCode上了,点击链接即可下载。
训练数据有3栏:test1、test2和pass_or_not。test1和test2里填写的是芯片在两次不同的测试中的数值,pass_or_not代表最终芯片是否合格,合格是1,不合格是0。我们的目标就是训练逻辑回归模型去找到pass_or_not的决策边界。
下载好后把它移到你的Python项目文件夹里即可。
1.10.2. 写二阶决策边界的代码
其实这一部分与上一篇文章 1.9. 逻辑回归实战(进阶) 的步骤一样,所以这里我就速讲一遍。
Step 1: 读取数据
# 读取数据
import pandas as pd
data = pd.read_csv('Chip_Test_Data.csv')

print(data.head())
输出:
       test1      test2  pass_or_not
0  62.472407  81.889703            1
1  97.042858  72.165782            1
2  83.919637  58.571657            1
3  75.919509  88.827701            1
4  49.361118  81.083870            1
然后我们还可以使用matplotlib对数据进行可视化:
# 读取数据
import pandas as pd
data = pd.read_csv('Chip_Test_Data.csv')

# 可视化
import matplotlib.pyplot as plt

x1 = data.loc[:, 'test1'].to_numpy()
x2 = data.loc[:, 'test2'].to_numpy()
y = data.loc[:, 'pass_or_not'].to_numpy()

class0 = (y == 0)
class1 = (y == 1)

plt.scatter(x1[class0], x2[class0], c='r', marker='o')
plt.scatter(x1[class1], x2[class1], c='b', marker='x')
plt.xlabel('test1')
plt.ylabel('test2')
plt.show()
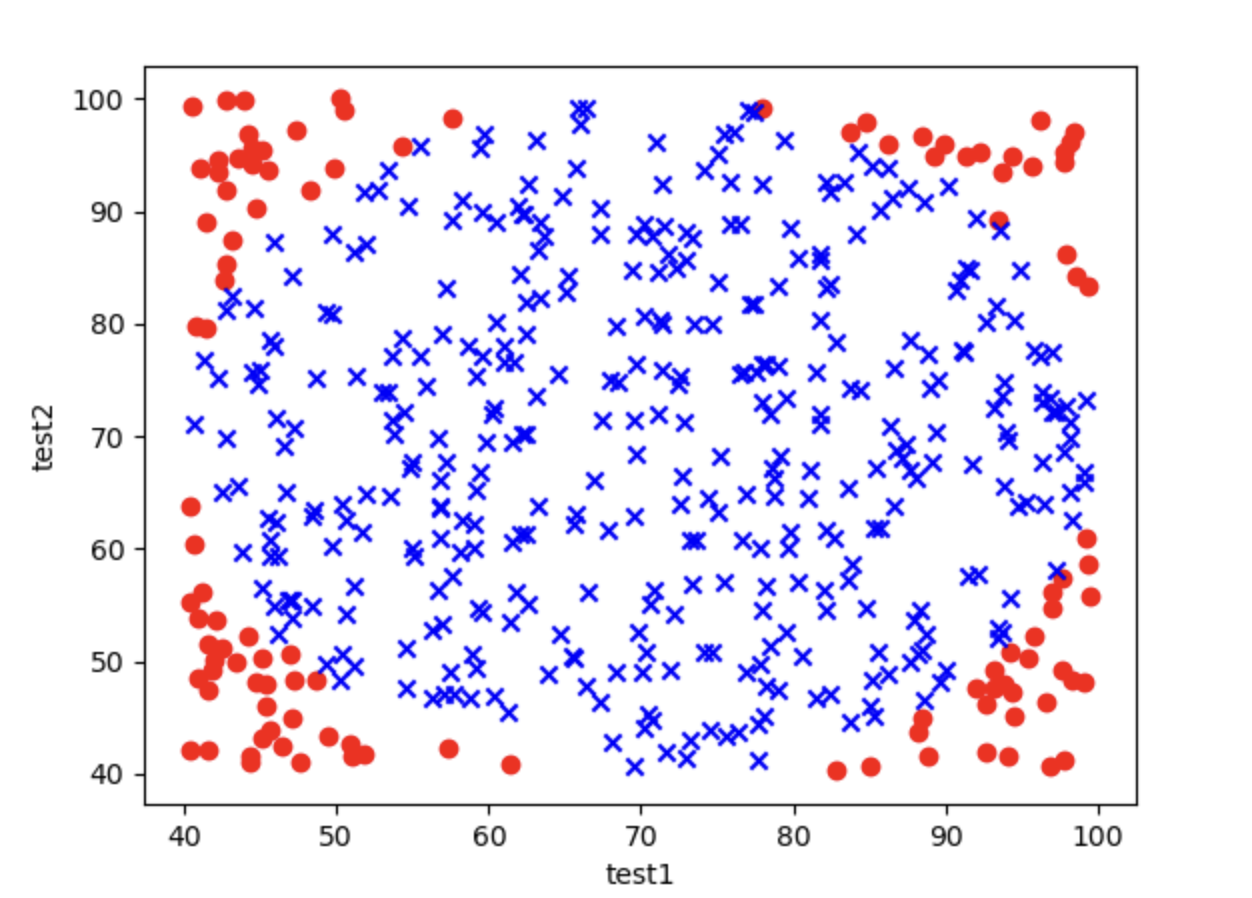
输出图片:
Step 2: 给x和y赋值
我们要首先明确x和y代表什么:
y是pass_or_not这一栏的数据
x有些特别,由于我们建立的是二阶模型,所以方程的项跟原来比更复杂:
$$
\theta_0 + \theta_1 X_1 + \theta_2 X_2 + \theta_3 X_1^2 + \theta_4 X_2^2 + \theta_5 X_1 X_2 = 0
$$
有x_1^2、x_2^2、X_1 * x_2这些项。所以我们得把这些项打包在字典里,再转为模型能使用的DataFrame格式给它使用。
# 给x和y赋值
y = data.loc[:, 'pass_or_not']
x1 = data.loc[:, 'test1']
x2 = data.loc[:, 'test2']
x = {
    'x1': x1,
    'x2': x2,
    'x1^2': x1 ** 2,
    'x2^2': x2 ** 2,
    'x1*x2': x1 * x2,
}

x = pd.DataFrame(x)
print(x.head())
输出:
          x1         x2         x1^2         x2^2        x1*x2
0  62.472407  81.889703  3902.801653  6705.923431  5115.846856
1  97.042858  72.165782  9417.316363  5207.900089  7003.173761
2  83.919637  58.571657  7042.505392  3430.639001  4915.312163
3  75.919509  88.827701  5763.771855  7890.360497  6743.755464
4  49.361118  81.083870  2436.520012  6574.594031  4002.390527
我们也可以使用上一篇文章 1.9. 逻辑回归实战(进阶) 说过的简单的方法来生成这个字典:
from sklearn.preprocessing import PolynomialFeatures
poly = PolynomialFeatures(degree=2, include_bias=False)
x = data.drop(['pass_or_not'], axis=1)
x = poly.fit_transform(x)
Step 3: 训练模型
# 训练模型
from sklearn.linear_model import LogisticRegression
model = LogisticRegression()
model.fit(x, y)
Step 4: 获取决策边界
# 获取决策边界
theta1, theta2, theta3, theta4, theta5 = model.coef_[0]
theta0 = model.intercept_[0]

print(f'Decision Boundary: {theta0} + {theta1}x1 + {theta2}x2 + {theta3}x1^2 + {theta4}x2^2 + {theta5}x1*x2')
这里面的每个变量都对应着方程中的参数: $$ \theta_0 + \theta_1 X_1 + \theta_2 X_2 + \theta_3 X_1^2 + \theta_4 X_2^2 + \theta_5 X_1 X_2 = 0 $$
输出:
Decision Boundary: -1.55643301596937 + 0.0687019597360078x1 + 0.04589152052058807x2 + -0.001380801702595371x1^2 + -0.0012980632178920715x2^2 + 0.0018080315329989266x1*x2
Step 5: 获取预测值与计算准确率
# 获取预测值与计算准确率
prediction = model.predict(x)
from sklearn.metrics import accuracy_score
print(f"accuracy: {accuracy_score(y, prediction)}")
输出:
accuracy: 0.842
Step 6: 可视化决策边界
# 可视化
import matplotlib.pyplot as plt
import numpy as np

x1 = x1.to_numpy()
x2 = x2.to_numpy()
y = y.to_numpy()

class0 = (y == 0)
class1 = (y == 1)

plt.scatter(x1[class0], x2[class0], c='r', marker='o')
plt.scatter(x1[class1], x2[class1], c='b', marker='x')
plt.xlabel('exam1')
plt.ylabel('exam2')

# 可视化二阶决策边界

# 定义exam1和exam2的范围,为了画网格
x1_min, x1_max = x1.min() - 1, x1.max() + 1
x2_min, x2_max = x2.min() - 1, x2.max() + 1

# 生成网格数据
xx1, xx2 = np.meshgrid(np.linspace(x1_min, x1_max, 500),
                       np.linspace(x2_min, x2_max, 500))

# 计算每个点的决策边界值
z = (theta0 +
     theta1 * xx1 +
     theta2 * xx2 +
     theta3 * xx1 ** 2 +
     theta4 * xx2 ** 2 +
     theta5 * xx1 * xx2)

# 绘制样本点
plt.scatter(x1[class0], x2[class0], c='r', label='Not Pass', marker='o')
plt.scatter(x1[class1], x2[class1], c='b', label='Pass', marker='x')

# 绘制决策边界
plt.contour(xx1, xx2, z, levels=[0], colors='g')

# 添加标签和图例
plt.xlabel('Test1 Score')
plt.ylabel('Test2 Score')
plt.legend()
plt.title('Decision Boundary')
plt.show()
输出图片:
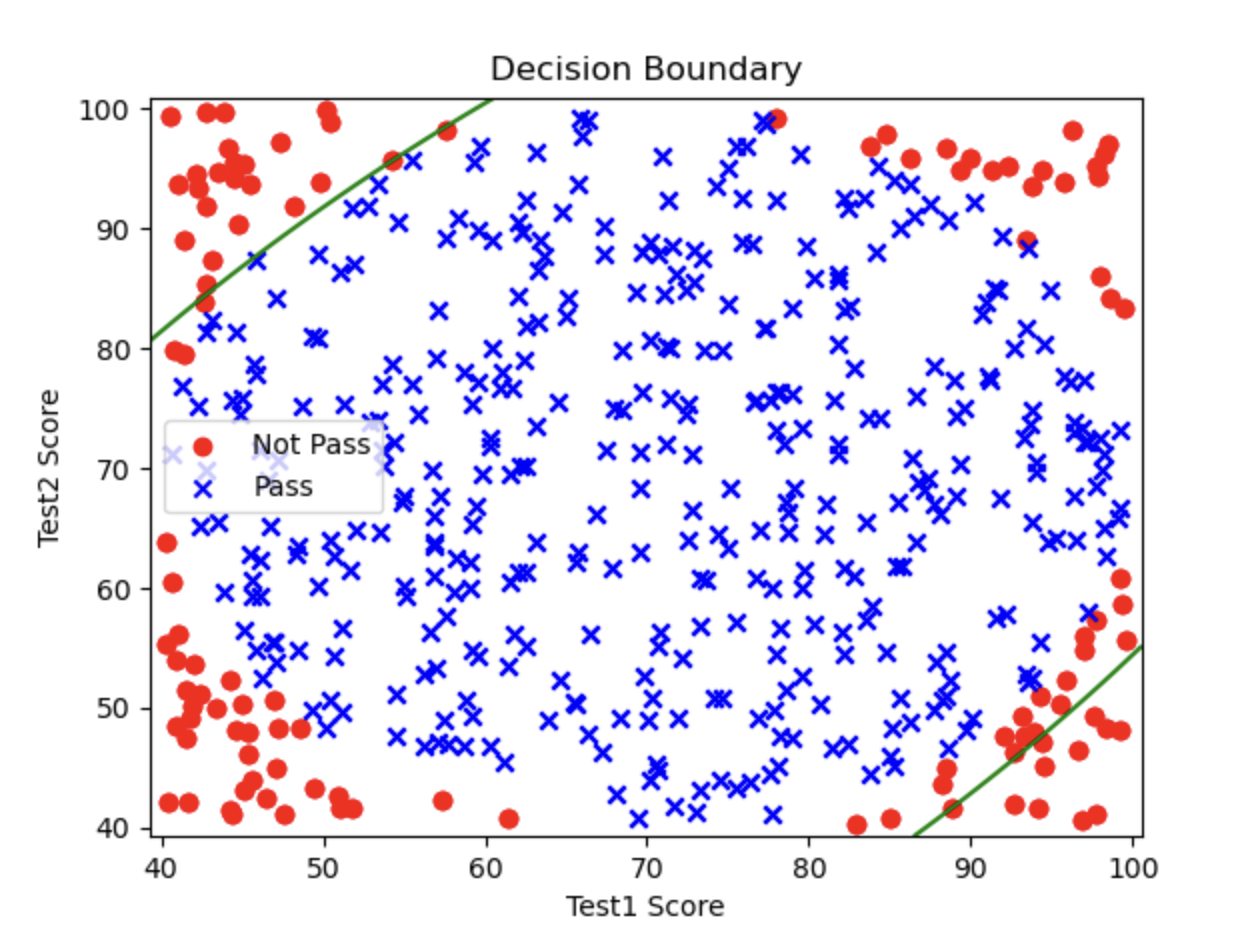
你会发现这个图只画了左上和右下的两条线,而左下和右上应该有决策边界的地方却没有。这就是阶数太少导致的拟合不到位,如果我们继续增阶,就会拟合的更好。
1.10.3. 三阶的决策边界
其实写三阶决策边界的代码与写二阶的思路基本一致,就是在给x赋成字典然后转为DataFrame这一块多添加几个字段以符合更高阶的特征:
# 给 x 和 y 赋值
y = data.loc[:, 'pass_or_not']
x1 = data.loc[:, 'test1']
x2 = data.loc[:, 'test2']

# 手动创建高阶特征字典
x = {
    'x1': x1,
    'x2': x2,
    'x1^2': x1 ** 2,
    'x2^2': x2 ** 2,
    'x1*x2': x1 * x2,
    'x1^3': x1 ** 3,
    'x2^3': x2 ** 3,
    'x1^2*x2': (x1 ** 2) * x2,
    'x1*x2^2': x1 * (x2 ** 2),
}

# 将特征字典转换为 DataFrame
x = pd.DataFrame(x)
这样字典里的每个字段都能对应到3阶g(x)的每一项:
$$
g(x) = \theta_0 + \theta_1 X_1 + \theta_2 X_2 + \theta_3 X_1^2 + \theta_4 X_2^2 + \theta_5 X_1 X_2 + \theta_6 X_1^3 + \theta_7 X_2^3 + \theta_8 X_1^2 X_2 + \theta_9 X_1 X_2^2 = 0
$$
也可以使用PolynomialFeatures创建字典:
from sklearn.preprocessing import PolynomialFeatures
poly = PolynomialFeatures(degree=3, include_bias=False)
x = data.drop(['pass_or_not'], axis=1)
x = poly.fit_transform(x)
其余的部分基本不变,我把三阶的完整代码贴出来:
# 导入必要模块
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

# 第1部分:读取数据
file_path = "Chip_Test_Data.csv"
data = pd.read_csv(file_path)

# 给 x 和 y 赋值
y = data.loc[:, 'pass_or_not']
x1 = data.loc[:, 'test1']
x2 = data.loc[:, 'test2']

# 手动创建高阶特征字典
x = {
    'x1': x1,
    'x2': x2,
    'x1^2': x1 ** 2,
    'x2^2': x2 ** 2,
    'x1*x2': x1 * x2,
    'x1^3': x1 ** 3,
    'x2^3': x2 ** 3,
    'x1^2*x2': (x1 ** 2) * x2,
    'x1*x2^2': x1 * (x2 ** 2),
}

# 将特征字典转换为 DataFrame
x = pd.DataFrame(x)

# 第3部分:训练逻辑回归模型
model = LogisticRegression(max_iter=10000)
model.fit(x, y)

# 获取模型的系数与截距
theta = model.coef_[0]
theta0 = model.intercept_[0]

# 获取预测值并计算准确率
prediction = model.predict(x)
accuracy = accuracy_score(y, prediction)
print(f"Accuracy: {accuracy}")

# 第4部分:生成网格,计算决策边界
# 定义 x1 和 x2 的范围,用于绘制网格决策边界
x1_min, x1_max = x1.min() - 1, x1.max() + 1
x2_min, x2_max = x2.min() - 1, x2.max() + 1

# 生成网格数据
xx1, xx2 = np.meshgrid(np.linspace(x1_min, x1_max, 500),
                       np.linspace(x2_min, x2_max, 500))

# 使用生成网格计算多项式特征
grid_x = {
    'x1': xx1.ravel(),
    'x2': xx2.ravel(),
    'x1^2': xx1.ravel() ** 2,
    'x2^2': xx2.ravel() ** 2,
    'x1*x2': xx1.ravel() * xx2.ravel(),
    'x1^3': xx1.ravel() ** 3,
    'x2^3': xx2.ravel() ** 3,
    'x1^2*x2': (xx1.ravel() ** 2) * xx2.ravel(),
    'x1*x2^2': xx1.ravel() * (xx2.ravel() ** 2),
}

grid_x = pd.DataFrame(grid_x)

# 计算每个网格点的预测值
z = model.predict(grid_x)
z = z.reshape(xx1.shape)

# 第5部分:可视化
# 绘制样本点
class0 = (y == 0)
class1 = (y == 1)

plt.figure(figsize=(8, 6))

# 绘制 Not Pass 和 Pass 样本点
plt.scatter(x1[class0], x2[class0], c='r', label='Not Pass', marker='o')
plt.scatter(x1[class1], x2[class1], c='b', label='Pass', marker='x')

# 绘制决策边界
plt.contour(xx1, xx2, z, levels=[0.5], colors='g')

# 添加标签和标题
plt.xlabel('Test 1 Score')
plt.ylabel('Test 2 Score')
plt.legend()
plt.title('Polynomial Logistic Regression (Degree=3)')
plt.show()
输出:
Accuracy: 1.0
图片输出:
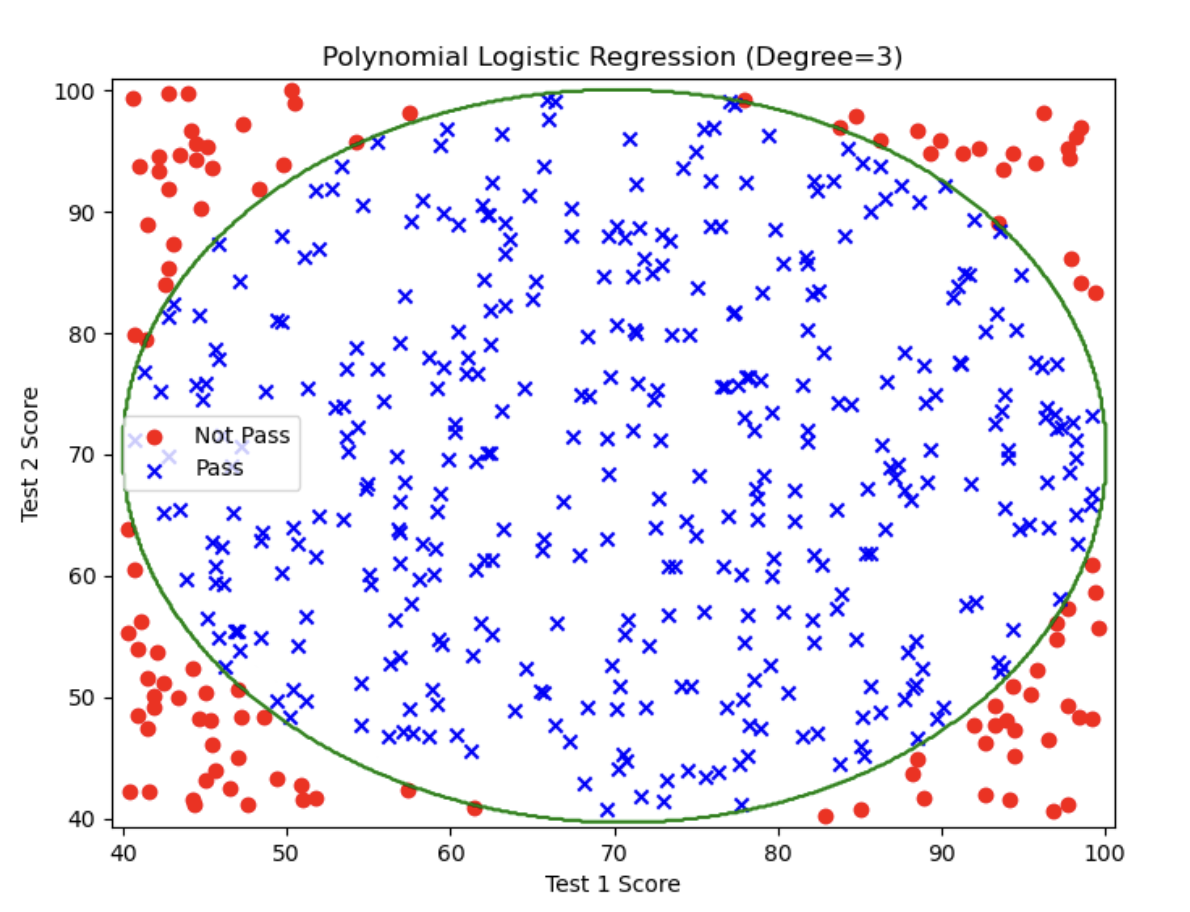
这已经是一个完美的决策边界了!准确率百分百!
2.1. 无监督学习(Unsupervised Learning)
2.1.1. 什么是无监督学习(Unsupervised Learning)?
我们来看一个例子:
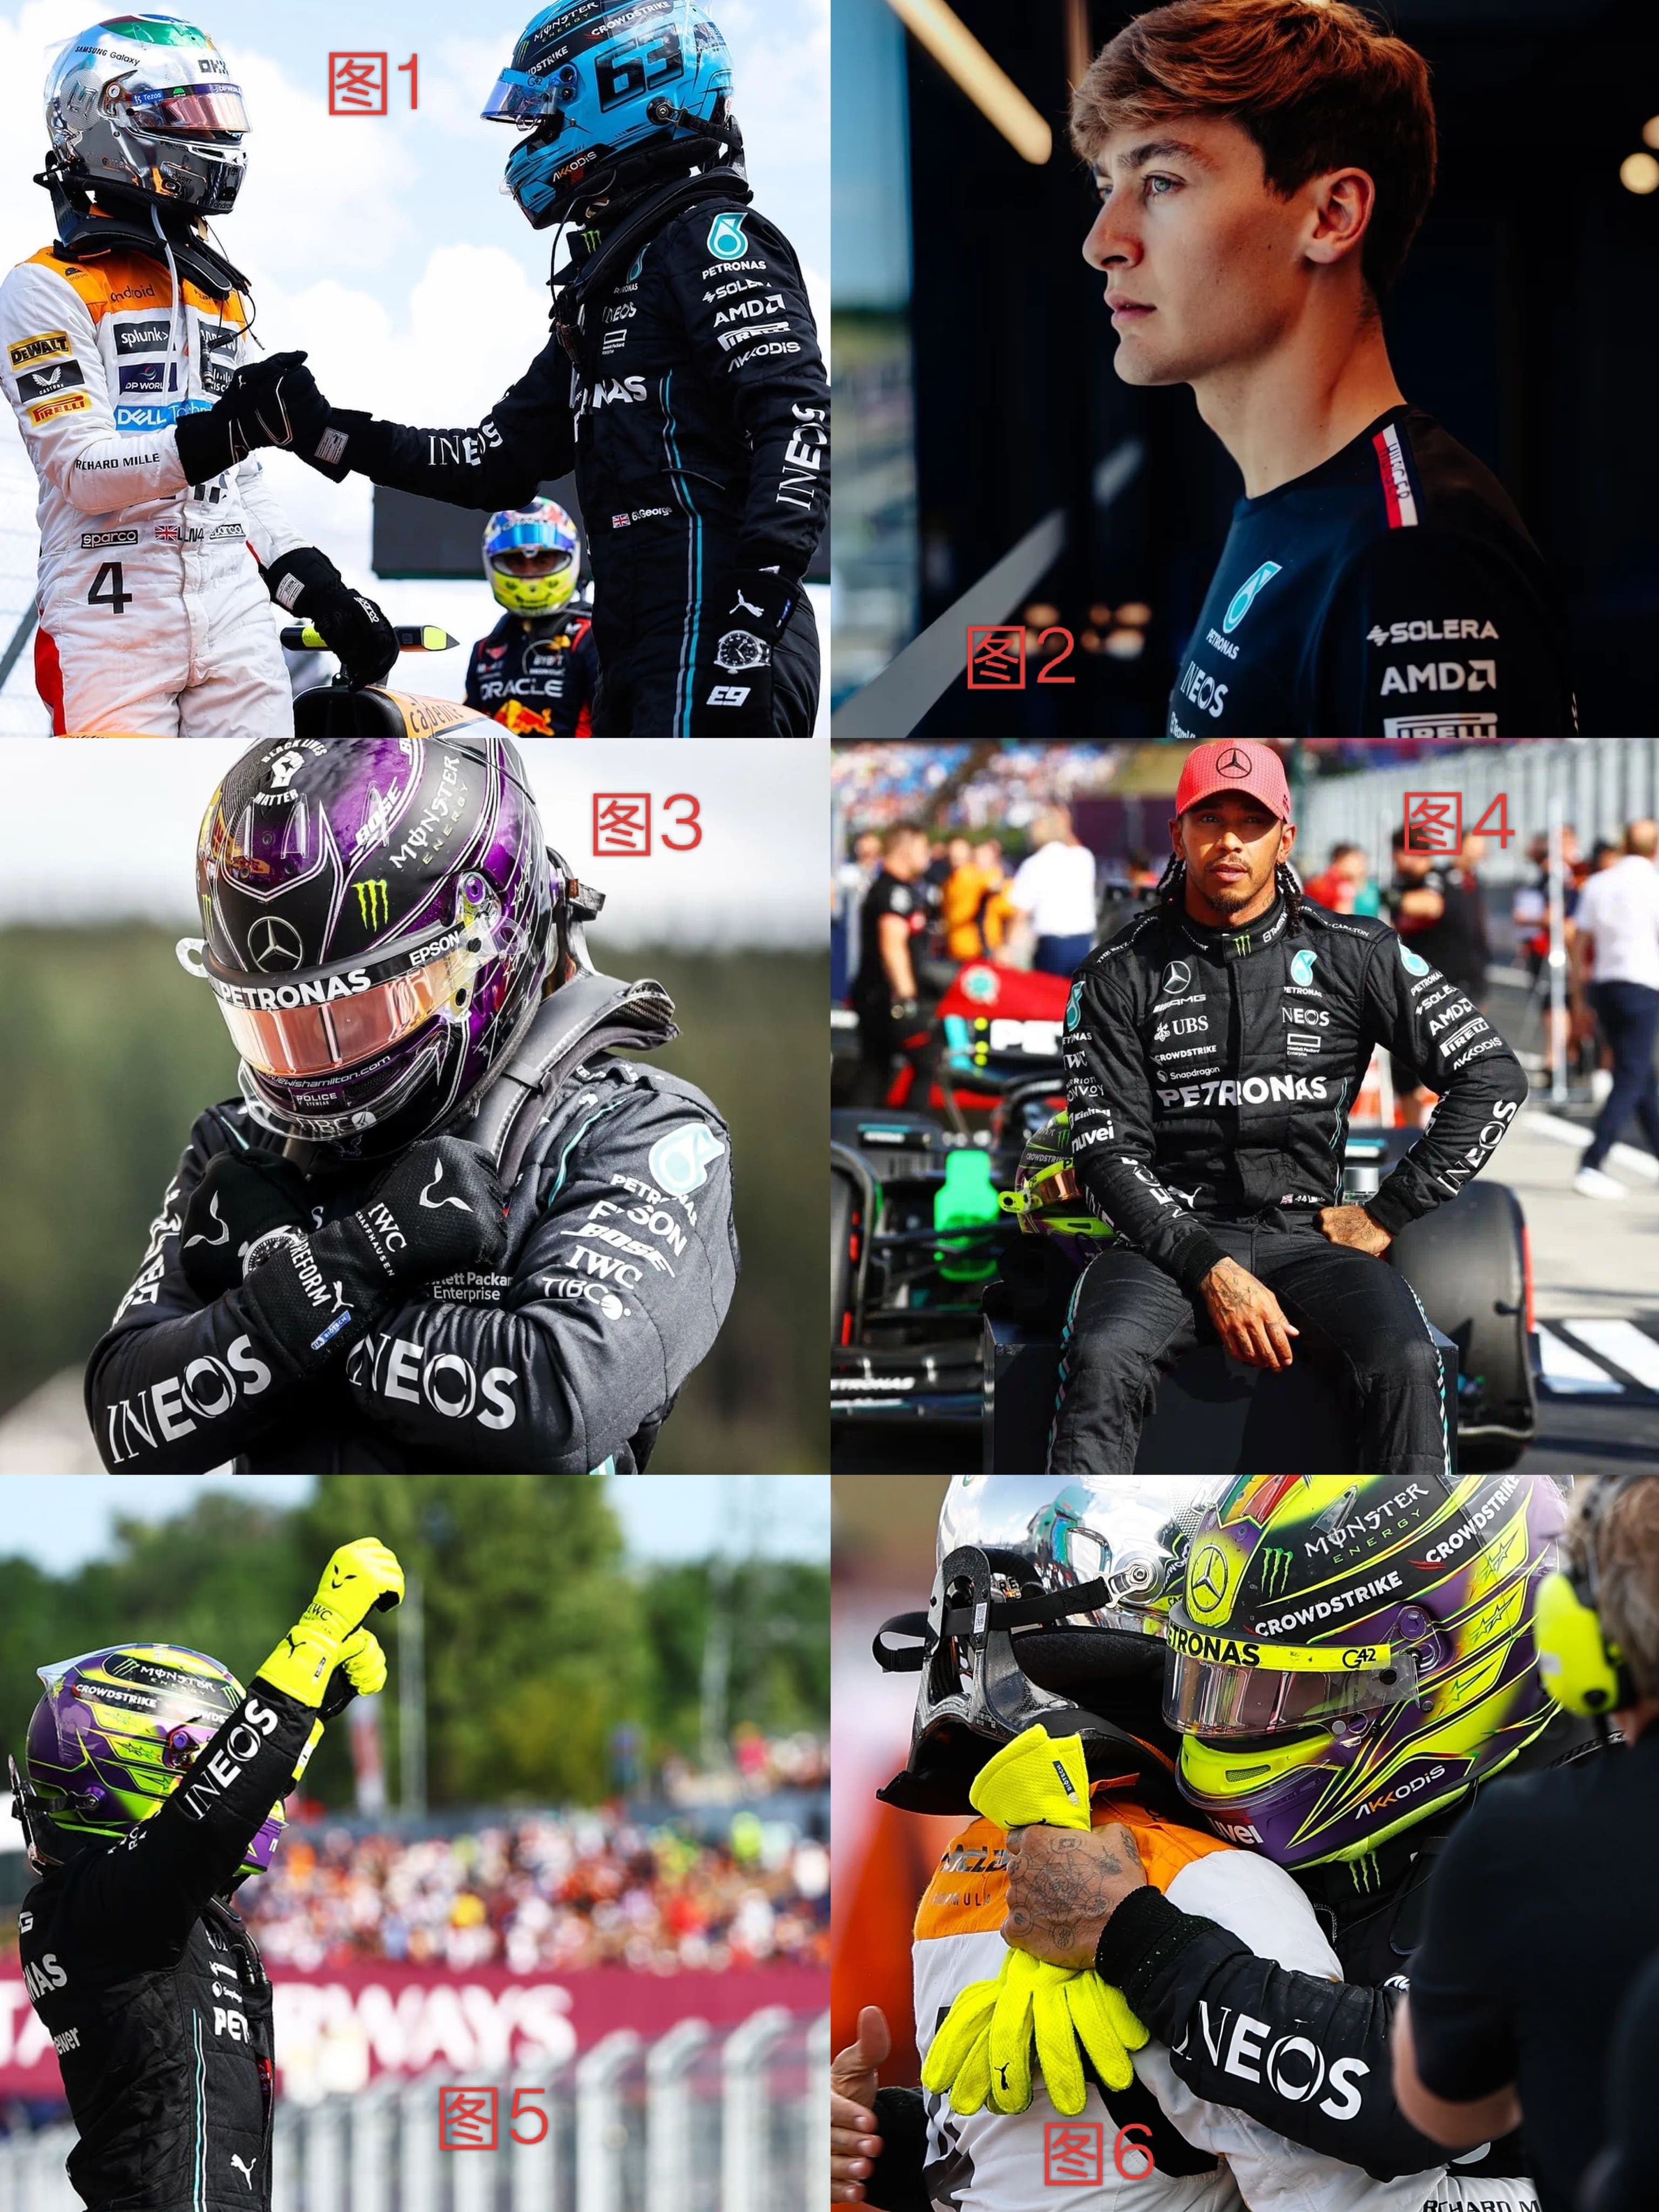
对于上面这张图,你会怎么把它们分成两组呢?有什么依据呢?肯定会观察图片的一些共同点和不同点。
按照图片里有一个人还是多个人来区分:
- 一个人:图2、3、4、5
- 多个人:图1、6
按照图片里的人有没有戴赛车头盔来区分:
- 没戴头盔:图2、4
- 戴了头盔:图1、3、5、6
等等…
这些划分方式是没有对错之分的,都完成了分成两组的任务。
这就是无监督学习的核心:没有标准的答案(正确的标签),只要你能找到数据共同点并分类。
2.1.2. 无监督学习的优点与应用
无监督学习是一种机器学习方法,它在没有标签或监督信息的情况下,从数据中发现隐藏的模式或结构,自动进行分类或分群。
这种学习方法的优点在于:
-
算法不受监督信息(偏见)的约束,可能考虑到新的信息。 就以上文的例子来说,如果你告诉计算机按照图片里有一个人还是多个人来区分那它就不会去按照图片里的人有没有戴赛车头盔来区分,但其实确实也可以这么区分。也就是说他可以帮你找到一些额外的相似之处。
-
不需要标签数据,极大程度扩大数据样本。 监督式学习的每个数据你都需要有正确与否的标注,但是无监督学习不需要这些标注,意味着它可以接收更多的数据。
无监督学习的主要应用场景有:
- 聚类分析:将数据分成不同的组,使得同一组内的数据点相似,而不同组的数据点差异较大
- 关联规则:找到数据之间的关系
- 维度缩减:减少数据的维度,同时尽可能保留原始数据的重要信息
这其中运用最广的就是聚类分析,也是这章的重点。
2.1.3. 监督学习 vs. 无监督学习
监督学习
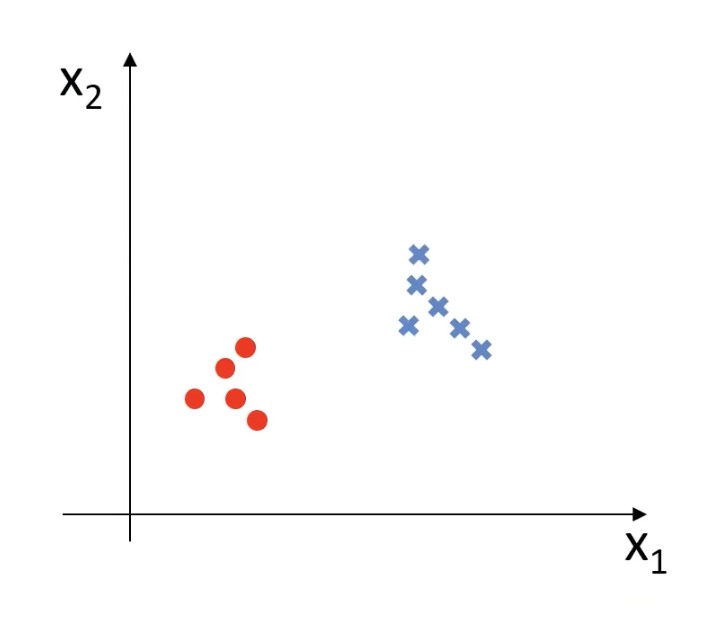
在监督学习中,每一个数据都是标记好的,也就是图中圆形和x的标注。
用数学式表达的话,监督学习的训练数据是: $$ {(x^{(1)}, y^{(1)}), (x^{(2)}, y^{(2)}), \dots, (x^{(m)}, y^{(m)})} $$
- 有输入
x还有对应的标签y
无监督学习
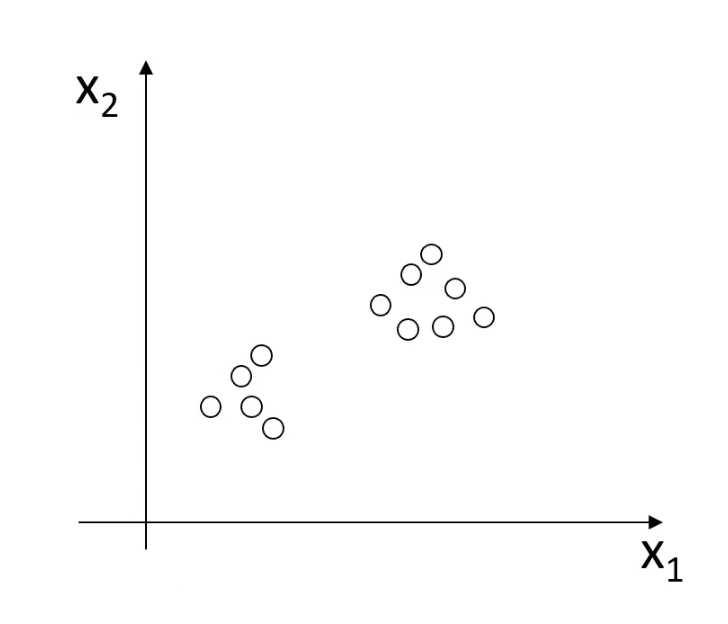
无监督学习没有标注,数据都是一个样,计算机需要自己去找其中的区别。
用数学式表达的话,无监督学习的训练数据是: $$ {x^{(1)}, x^{(2)}, \dots, x^{(m)}} $$
- 只有数据
x,没有标签y
2.1.4. 聚类分析
聚类分析又称为群分析,根据对象某些属性的相似度,将其自动化分为不同的类别。
它会用在以下几个领域:
- 商业领域:对客户进行划分
- 生物领域:基因聚类分析
- 新闻领域:把不同的新闻划分到不同点关键词下
下面我们来介绍一下聚类分析常用的算法:
1. KMeans聚类
- 根据数据与中心点距离划分类别
- 基于类别数据更新中心点
- 重复过程直到收敛
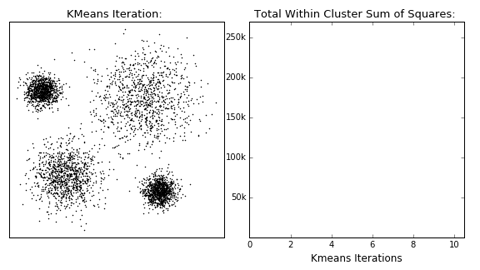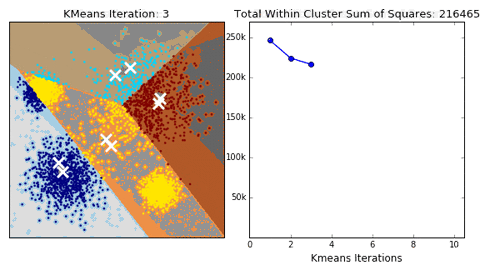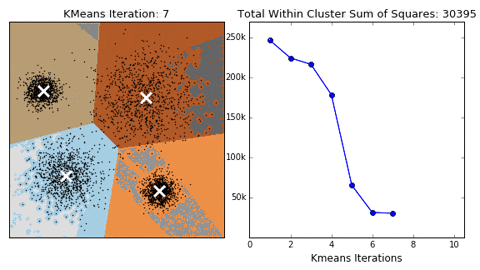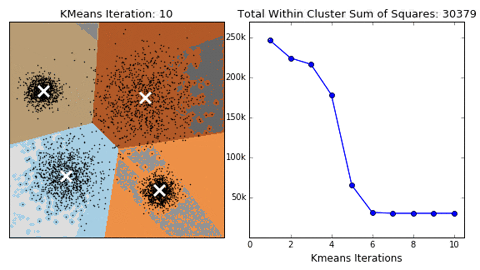
它的优点是:
- 实现简单、收敛快
它的缺点是:
- 需要指定类别数量
2. 均值漂移聚类(MeanShift)
- 在中心点一定区域检索数据点
- 更新中心
- 重复流程直到中心点稳定
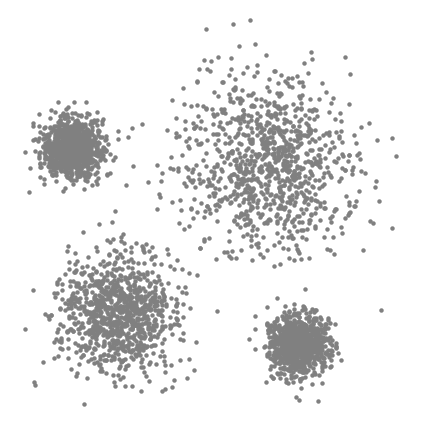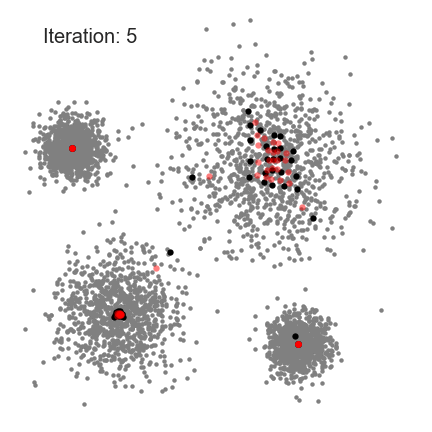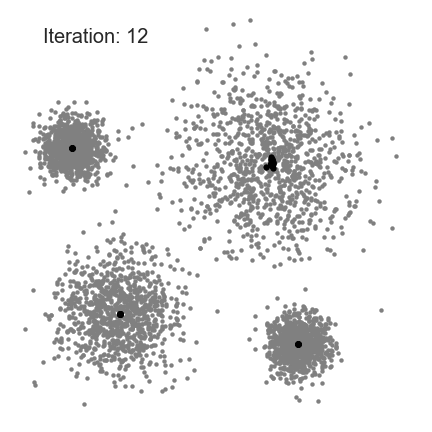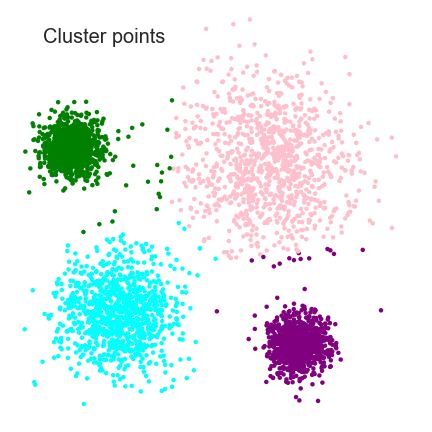
它的优点:
- 自动发现类别数量,不需要人工选择
它的缺点:
- 需要选择区域半径
3. DBScan算法(基于密度的空间聚类算法)
- 基于区域点密度筛选有效数据
- 基于有效数据向周边扩张,直到没有新点加入
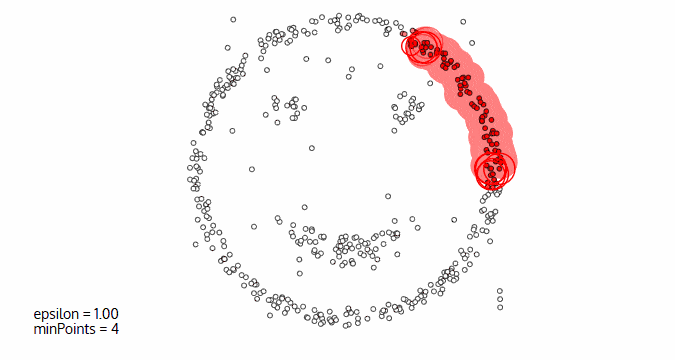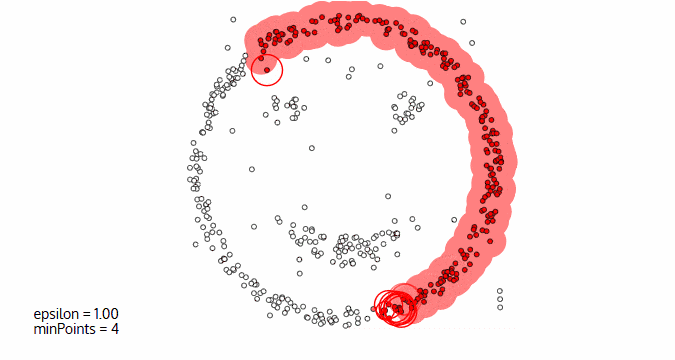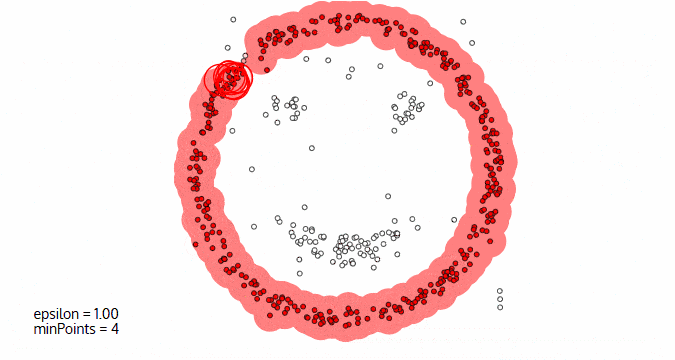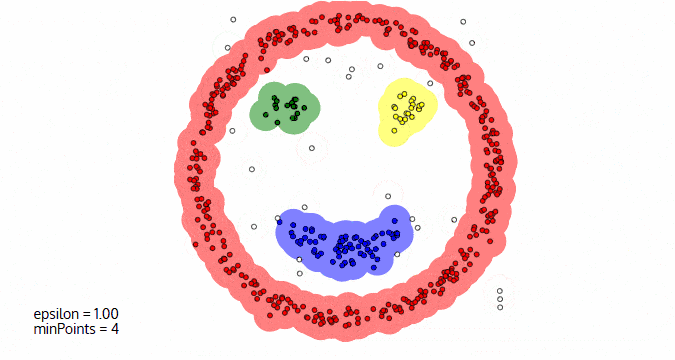
它的优点:
- 过滤噪音数据
- 不需要人为选择类别数量
它的缺点:
- 数据密度不同时影响结果
2.2. 聚类分析算法理论
2.2.1. K均值聚类(KMeans Analysis)
K均值算法是以空间中K个点为中心进行聚类,对最靠近他们的对象归类,是聚类算法中最为基础但也最为重要的算法。
数学原理
计算数据点与各簇中心点的距离: $$ {dist}(x_i, u_j^t) $$ 然后根据距离归类: $$ x_i \in u^t_{\text{nearest}} $$ 最后更新中心: $$ u_j^{t+1} = \frac{1}{k} \sum_{x_i \in S_j} x_i $$
- $S_j$: $t$ 时刻第 $j$ 个区域簇
- $k$: 包含在 $S_j$ 范围内点的个数
- $x_i$: 包含在 $S_j$ 范围内的点
- $u_j^t$: $t$ 状态下第 $j$ 区域中心
展开分析
我们来一步一步展开分析一下:
1. 计算数据点与各簇中心点的距离
$$ \text{dist}(x_i, u_j^t) $$ 这表示计算 数据点$x_i$与第$j$ 个簇中心 $u_j^t$ (注:$u_j^t$指的是第$j$个簇在第$t$轮迭代时的中心点)之间的距离。计算时一般都使用欧几里得距离: $$ \text{dist}(x_i, u_j^t) = \sqrt{\sum_{d} (x_{id} - u_{jd}^t)^2} $$
2. 根据距离归类
$$ x_i \in u^t_{\text{nearest}} $$ 这表示 将数据点$x_i$归类到最近的簇中心(即属于距离最近的$u_j^t$代表的簇)。
具体步骤是:
- 计算所有簇中心$u_j^t$与数据点$x_i$的距离。
- 找到最近的中心: $$ j^* = \arg\min_j \text{dist}(x_i, u_j^t) $$
- 将$x_i$归类到最近的簇,即属于$j^*$号簇。
3. 更新中心
$$ u_j^{t+1} = \frac{1}{k} \sum_{x_i \in S_j} x_i $$ 这一公式用于更新每个簇的中心点,通过计算该簇内所有点的均值来更新中心。
- $S_j$是第$j$个簇内的所有数据点集合。
- $k$是该簇内数据点的个数。
计算步骤:
- 找到第 j 个簇的所有数据点,即所有归入该簇的$x_i$。
- 计算这些点的均值,更新该簇的中心: $$ u_j^{t+1} = \frac{1}{k} \sum_{x_i \in S_j} x_i $$
- 重复以上步骤,直到收敛(即簇中心不再变化)。
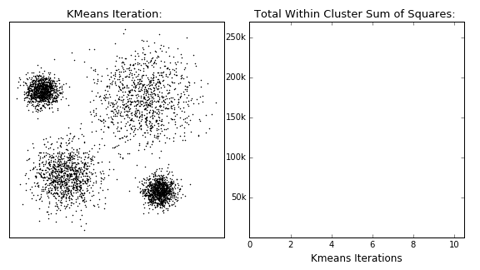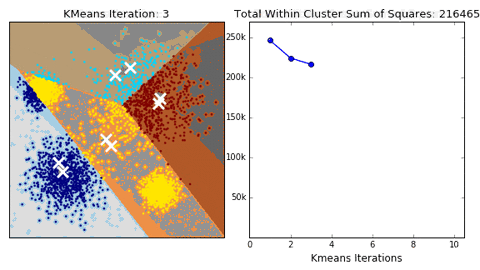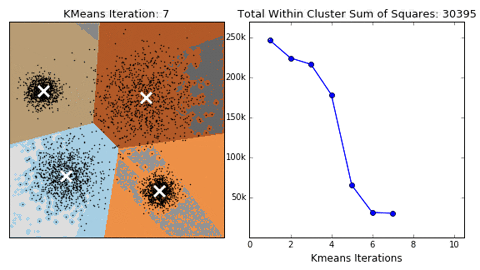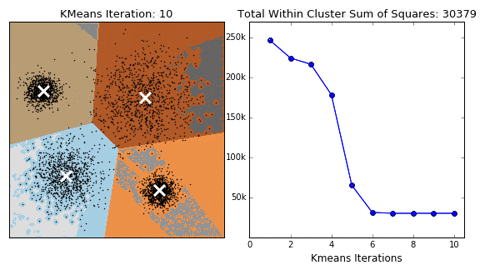
算法流程
- 选择聚类的个数$k$
- 确定聚类中心
- 根据点到聚类中心距离来确定各个点所属类别
- 根据各个类别数据更新聚类中心
- 重复以上步骤直到收敛(中心点不再变化时)
优缺点
优点:
- 原理简单,实现容易,收敛速度快
- 参数少,方便使用
缺点:
- 必须确定簇的数量
- 随机选择初始聚类中心会导致结果缺乏一致性
2.2.2. KMeans vs. KNN
KMeans的中文是K均值聚类,KNN的中文名是K近邻分类。这两者虽然名字很像,但是确是完全不同的两种算法。
有很多人容易搞混这两种算法,所以这里专门比较一下。

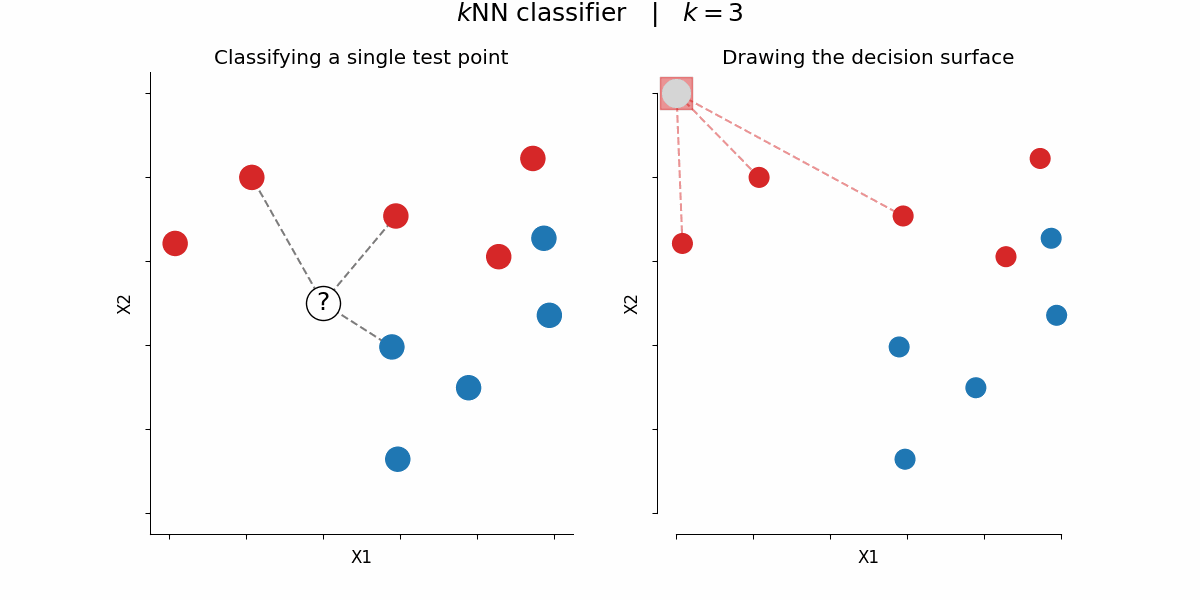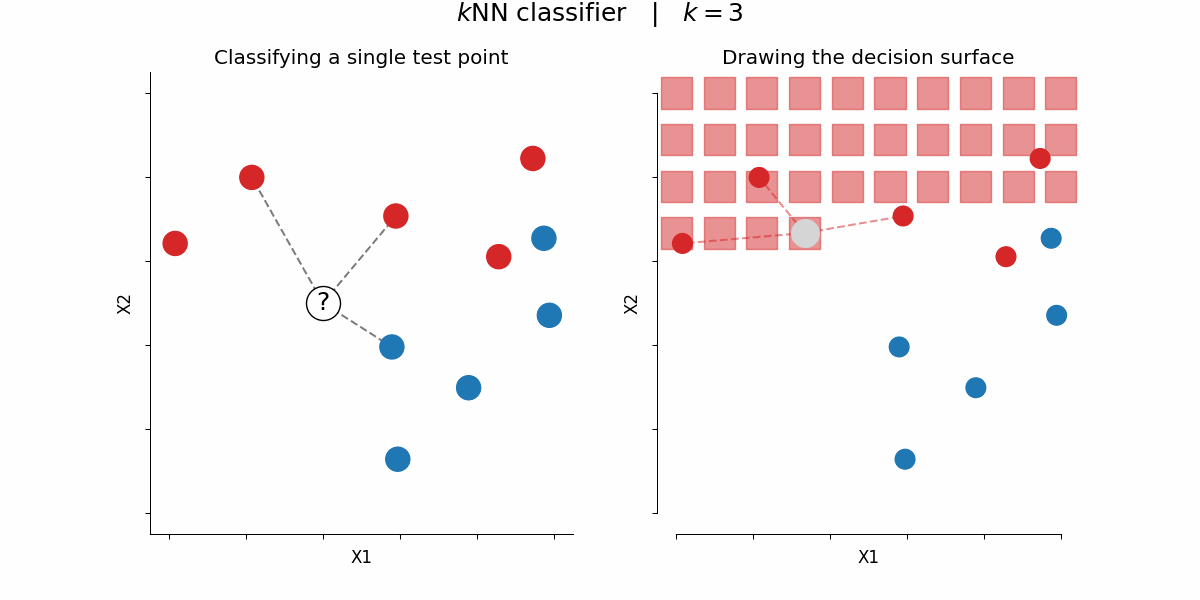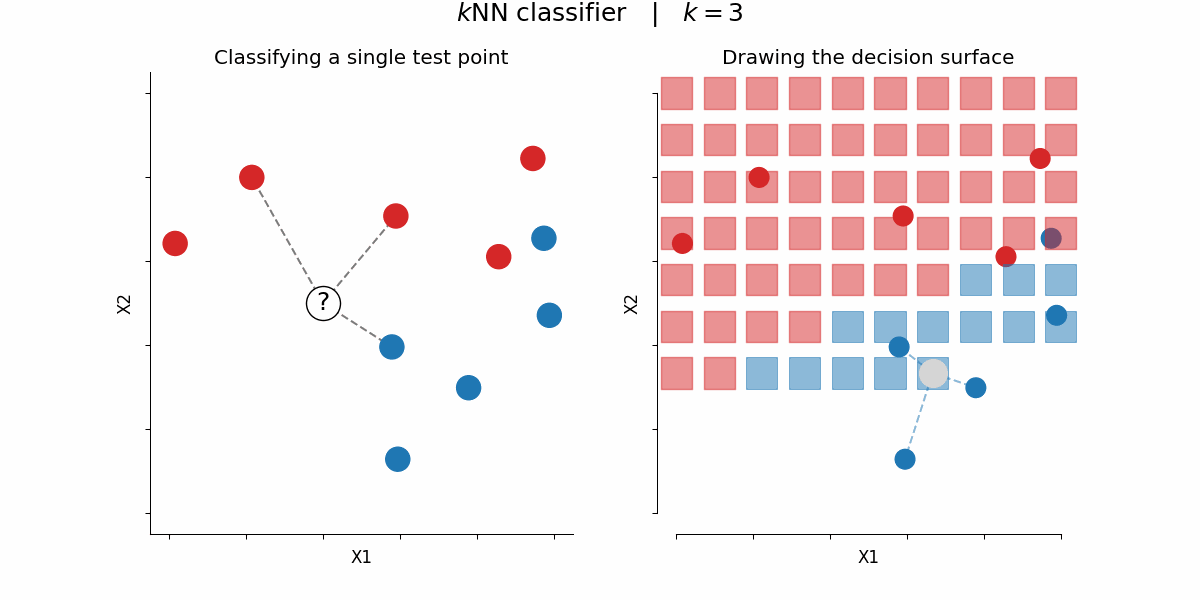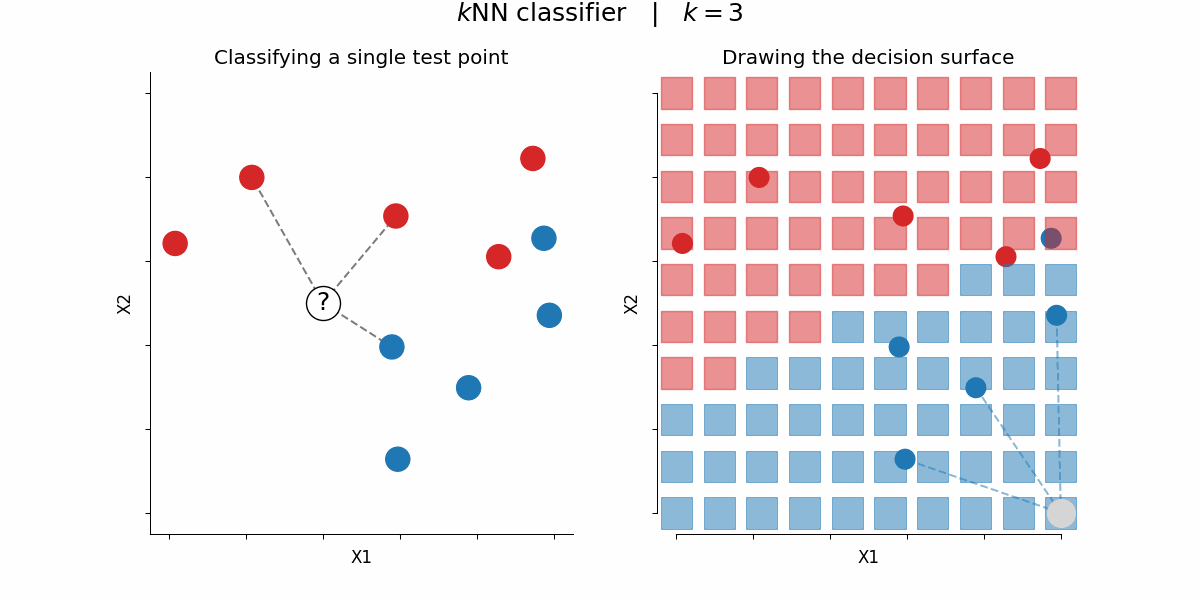
这幅图已经非常直观地展现了两者本质上的区别——KMeans是无监督学习,K近邻分类是监督学习。
在这里我们也介绍一下KNN:
给定一个训练数据集,对新的输入实例,在训练数据集中找到与该实例最邻近的K个实例,这K个实例的多数属于某个类,就把该输入实例分类到这个类中。
2.2.3. 均值漂移聚类(MeanShift)
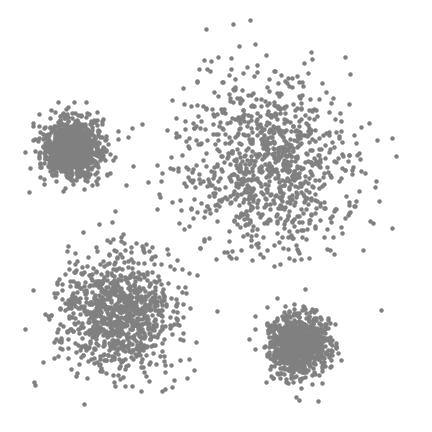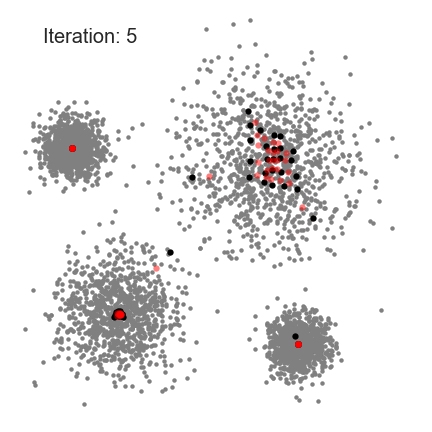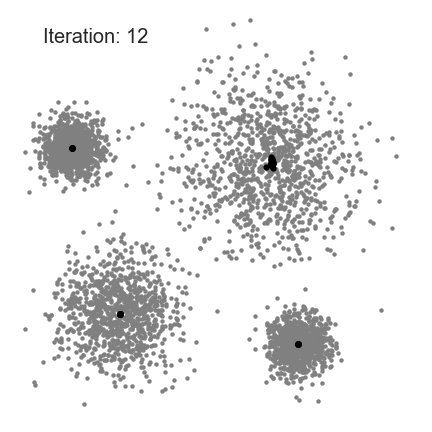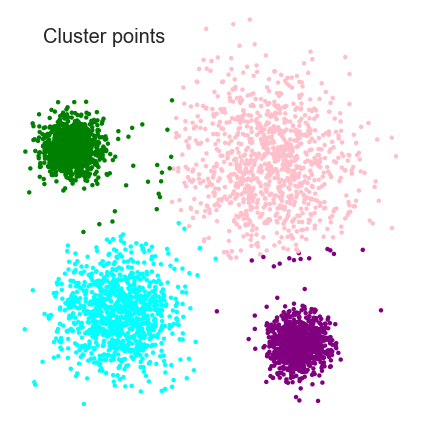
均值漂移算法是一种基于密度梯度上升的聚类算法(沿着密度上升方向寻找聚类中心点)
均值漂移算法相比K均值算法最大的优势就在于它不需要知道最终要分成几个簇。
数学原理
先均值偏移: $$ M(x) = \frac{1}{k} \sum_{x_i \in S_h} (x_i - u) $$
再更新中心: $$ u^{t+1} = u^t + M^t $$
其中:
- $S_h$: 以 $u$ 为中心点,半径为 $h$ 的高维球区域
- $k$: 包含在 $S_h$ 范围内点的个数
- $x_i$: 包含在 $S_h$ 范围内的点
- $M^t$: $t$ 状态下求得的均值偏移向量
- $u^t$: $t$ 状态下的中心
展开分析
接下来我们来展开分析一下:
1. 均值偏移计算
$$ M(x) = \frac{1}{k} \sum_{x_i \in S_h} (x_i - u) $$ 其中:
- $S_h$:以$u$为中心,半径为$h$的高维球区域(即邻域)
- $k$:邻域$S_h$内的点个数
- $x_i$:邻域$S_h$内的点
- $M(x)$:均值偏移向量,从当前中心指向邻域点均值(密度上升方向)
这个公式会:
- 计算邻域内所有点$x_i$相对当前中心点$u$的偏差 ($x_i - u$)
- 对所有偏差求均值,得到中心点的漂移方向$M(x)$
- 如果$M(x)$不为零,说明局部密度均值不在$u$处,需要沿$M(x)$方向调整$u$的位置
核心思想是:
- 计算 当前中心点$u$位置的偏移量$M(x)$
- 这个偏移量基于$u$周围的邻域点进行计算
2. 更新中心点
$$ u^{t+1} = u^t + M^t $$ 这一公式用于更新均值漂移的中心点:
- 当前中心点$u^t$沿着均值偏移量$M^t$方向移动,得到新的中心$u^{t+1}$
- 该迭代过程 不断调整中心点位置,直到收敛(即$M(x)$接近0)
算法流程
- 随机选择未分类的点作为中心点
- 找出离中心点距离在带宽之内的点,记作集合$S$
- 计算从中心点到集合$S$中每个元素的偏移向量$M$
- 中心点以向量$M$移动
- 重复步骤2-4直到收敛
- 重复以上所有步骤直到所有的点都被归类
- 分类:根据每个类对每个点的访问频率,取访问频率最大的那个类作为当前集的所属类
2.3. K均值聚类(KMeans Analysis)实战(基础)
2.3.1. 一些准备工作
接下来,请你确保你的Python环境中有pandas、matplotlib、scikit-learn和numpy这几个包,如果没有,请在终端输入指令以下载和安装:
pip install pandas matplotlib scikit-learn numpy
我把.csv数据文件放在GitCode上了,点击链接即可下载。
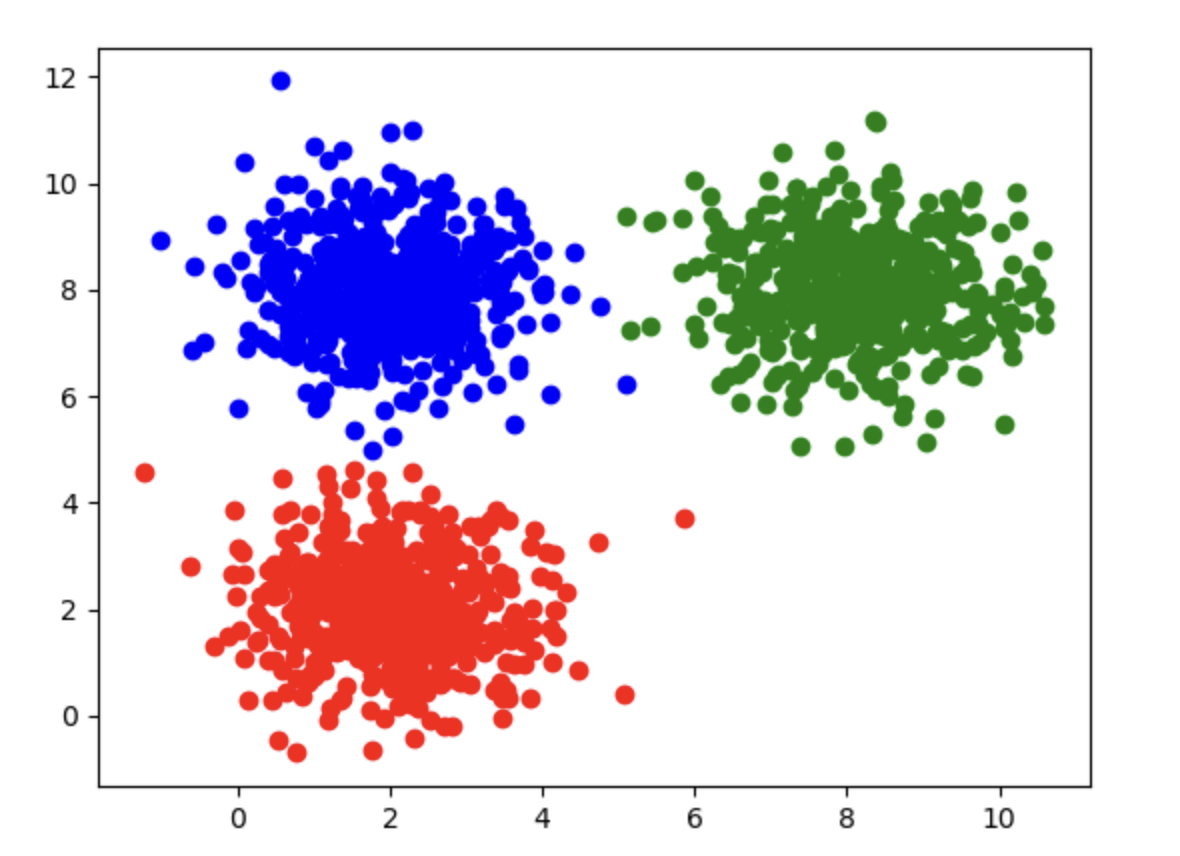
训练数据有3栏:x1, x2和label,x1和x2是两个输入变量,label是标签(0,1,2其中一个),这些数据会用来训练KMeans模型(当然不会给它label信息),数据最后会被分为3个簇,每个簇都有自己的label值。
下载好后把它移到你的Python项目文件夹里即可。
2.3.2. 写代码
Step 1: 读取数据
一样的使用pandas库来读取csv文件,顺便使用head方法来查看一下数据的前几项:
# 读取数据
import pandas as pd
data = pd.read_csv('KMeans_Data.csv')

print(data.head())
输出:
         x1        x2  label
0  2.496714  2.926178      0
1  1.861736  3.909417      0
2  2.647689  0.601432      0
3  3.523030  2.562969      0
4  1.765847  1.349357      0
我们还可以使用 1.8. 逻辑回归实战(基础) 中教过的画有分类的散点图方法来直观的看看数据:
# 可视化数据
import matplotlib.pyplot as plt
x1 = data.loc[:,"x1"]
x2 = data.loc[:,"x2"]
label = data.loc[:,"label"]

class0 = (label == 0)
class1 = (label == 1)
class2 = (label == 2)

plt.scatter(x1[class0],x2[class0],c='r')
plt.scatter(x1[class1],x2[class1],c='g')
plt.scatter(x1[class2],x2[class2],c='b')
plt.show()
图片输出:
Step 2: 给x和y赋值
我们要首先明确x和y代表什么:
x代表输入变量,也就是x1和x2y是label这一栏的数据
# 给x和y赋值
x = data.drop(['label'], axis=1)
y = data.loc[:,'label']
- 使用
drop函数丢弃指定的字段,保留其它字段。这里写的是'label',那就丢弃它,axis=1告诉程序丢弃的是'label'这一列而不是行。
Step 3: 训练模型
把数据喂给scikit-learn下的KMeans模型进行训练即可:
# 训练模型
from sklearn.cluster import KMeans
kmeans = KMeans(n_clusters=3, random_state=0)
kmeans.fit(x)
KMeans有两个参数:n_clusters决定最后归类为几个簇,我这里填的3最后就会归为3个簇random_state=0的作用是保证 KMeans模型每次运行时生成的中心初始化相同(sklearn 默认的init是'k-means++',其中的随机性仍由random_state控制)- 如果你将
random_state设置为其他值,例如random_state=42或random_state=1,算法逻辑不变,但初始中心可能不同,因此聚类结果也可能不同
Step 4: 获取聚类中心
通过cluster_centers_属性可以获得计算出的聚类中心:
# 获取聚类中心
centers = kmeans.cluster_centers_
print(centers)
输出:
[[8.10249937 8.0295763 ]
 [2.00635647 2.03776831]
 [1.98266327 8.03285096]]
Step 5: 可视化聚类中心
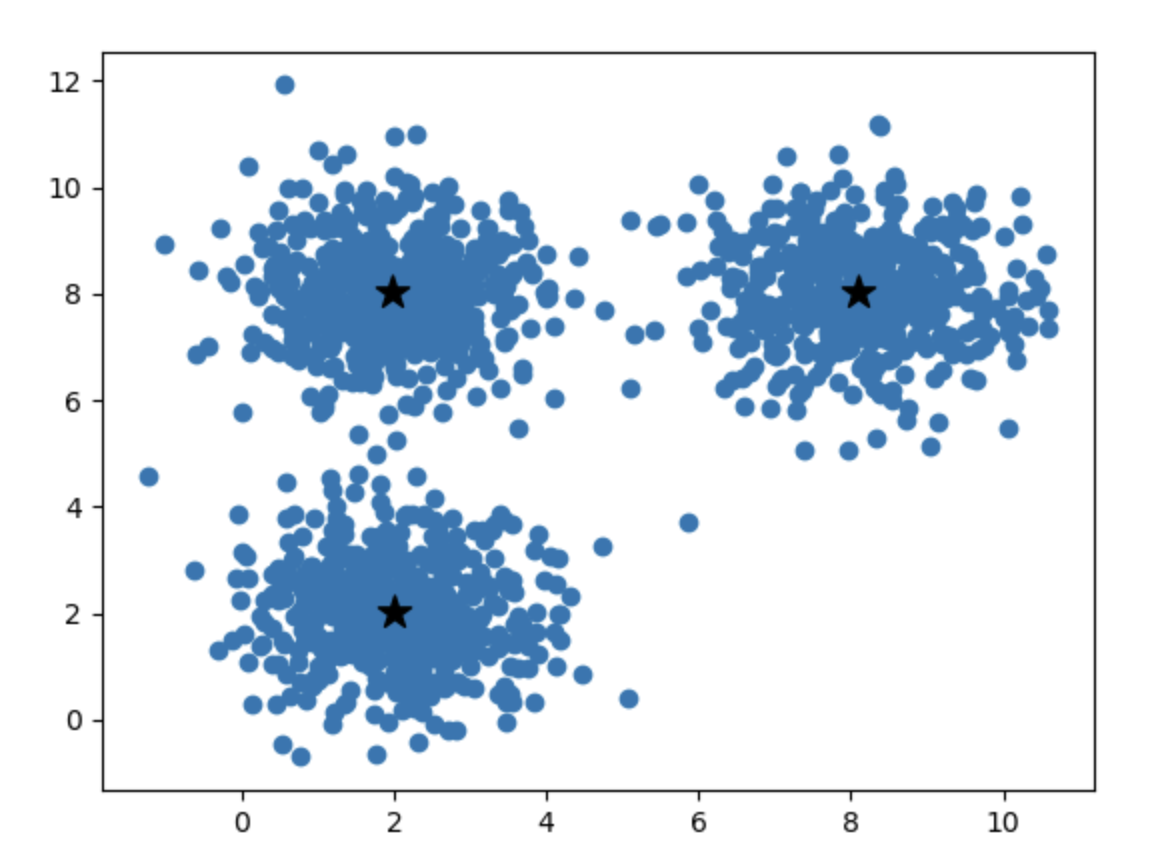
我们可以通过matplotlib来可视化聚类中心:
# 可视化聚类中心
import matplotlib.pyplot as plt

x1 = data.loc[:, "x1"]
x2 = data.loc[:, "x2"]
label = data.loc[:, "label"]

plt.scatter(x1, x2)

plt.scatter(centers[:, 0], centers[:, 1], c='k', marker='*', s=150)
plt.show()
输出图片:
Step 6: 获取预测值
既然已经完成分类了,那么我们可以随便找一个点看KMeans模型会给它分到哪一类:
# 一个小测
y_predict = kmeans.predict([[10, 10]])
print(y_predict)
输出:
[0]
KMeans给它分到了第0类,但是$(10,10)$是右上角的位置应该是label的第1类啊?为什么呢?
这是因为KMeans划分的0、1、2类与label的0、1、2类不一样。
KMeans模型本身不知道label,所以它的划分是随意的,虽然也会分为3类,但KMeans划分的0、1、2类不一定和label的0、1、2类一一对应。
在下一篇文章中我们会解决这个问题。
2.4. K均值聚类(KMeans Analysis)实战(进阶)
本文紧承上文 2.3. K均值聚类(KMeans Analysis)实战(基础) ,如果没有看请先看上一篇文章。
2.4.1. 获取预测值
我们得先获取预测值,然后用预测值与label的标签比较:
# 获取预测值
y_predict = kmeans.predict(x)
2.4.2. 与原数据对比与校正
获得了预测值以后我们就要根据label的值来对比计算准确率了:
# 计算准确率
from sklearn.metrics import accuracy_score
print(accuracy_score(y, y_predict))
输出:
0.332
但是为什么准确率这么低呢?看图明明分类分的挺好的。
这是因为我们还有一个问题没解决,其实在上一篇文章的末尾我就提到过:
KMeans划分的0、1、2类与label的0、1、2类不一样。KMeans模型本身不知道label,所以它的划分是随意的,虽然也会分为3类,但KMeans划分的0、1、2类不一定和label的0、1、2类一一对应。
这就导致了明明类分对了但是因为标签不同被视为错误。如何解决这个问题呢?一般来说我们可以通过数据的分布来分析:
label中散点数量最多的簇肯定对应预测结果中散点数量最多的簇,label中散点数量最少的簇肯定对应预测结果中散点数量最少的簇。
依此我们就可以把label的分类和模型的分类一一对应上。
那我们如何看数据的分布情况呢?pandas库提供了value_counts方法:
# 查看数据分布
print(pd.value_counts(y_predict))
print(pd.value_counts(y))
输出:
1    501
0    501
2    498
Name: count, dtype: int64
label
0    500
1    500
2    500
Name: count, dtype: int64
你会发现这些数据分布都太接近了,根本就分不出来。所以我们得放弃这个思路。
当然大部分时候这个思路都是有效的,只是我们这里情况特殊。
我们还可以通过画图来展现这个问题:
# 画图
import matplotlib.pyplot as plt
# 画原分类
fig1 = plt.subplot(1, 2, 1)
x1 = data.loc[:, "x1"]
x2 = data.loc[:, "x2"]
label = data.loc[:, "label"]

class0 = (label == 0)
class1 = (label == 1)
class2 = (label == 2)

fig1.scatter(x1[class0], x2[class0], c='r')
fig1.scatter(x1[class1], x2[class1], c='g')
fig1.scatter(x1[class2], x2[class2], c='b')

fig1.set_title("Actual Classification")

# 画模型的分类
fig2 = plt.subplot(1, 2, 2)
predicted_class0 = (y_predict == 0)
predicted_class1 = (y_predict == 1)
predicted_class2 = (y_predict == 2)

fig2.scatter(x1[predicted_class0], x2[predicted_class0], c='r')
fig2.scatter(x1[predicted_class1], x2[predicted_class1], c='g')
fig2.scatter(x1[predicted_class2], x2[predicted_class2], c='b')

fig2.scatter(centers[:, 0], centers[:, 1], c='black', s=100, marker='x', label='Centers')

fig2.set_title("KMeans Classification")

# 显示整个画布
plt.show()
图片输出:

可以看到,是红色和绿色的部分颠倒了,对应KMeans的0标签和1标签反了。所以我们只需要校正这部分即可:
# 校正标签
y_correct = []
for i in y_predict:
    if i == 0:
        y_correct.append(1)
    elif i == 1:
        y_correct.append(0)
    else:
        y_correct.append(2)
- 通过遍历并创建新的数组来校正标签。
- 如果原本是0,在新的数组里就是1;如果原本是1,在新的数组里就是0;其余不变,保持2。
2.4.3. 计算正确的正确率
这下的正确率就应该提高了:
# 计算正确率
from sklearn import metrics
print(metrics.accuracy_score(y, y_correct))
输出:
0.9986666666666667
这就对了。
2.5. 使用KNN与MeanShift实战
本文接续 2.3. K均值聚类(KMeans Analysis)实战(基础) 和 2.4. K均值聚类(KMeans Analysis)实战(进阶), 没看过的建议先看。
重要区分: KNN(KNeighborsClassifier)是有监督分类算法——训练时需要标签 y。MeanShift 是无监督聚类——不使用标签。把两者放在同一篇文章里是为了对照(另见 2.2),并不是因为 KNN 属于聚类方法。
2.5.1. 一些准备工作
接下来,请你确保你的Python环境中有pandas、matplotlib、scikit-learn和numpy这几个包,如果没有,请在终端输入指令以下载和安装:
pip install pandas matplotlib scikit-learn numpy
我把.csv数据文件放在GitCode上了,点击链接即可下载。
训练数据有3栏:x1、x2和label,x1和x2是两个输入变量,label是标签(0,1,2其中一个)。KNN 会同时使用特征和标签;MeanShift 只使用特征。这些数据在特征空间中形成三个自然分组。
下载好后把它移到你的Python项目文件夹里即可。
2.5.2. 用KNN做分类(有监督;不是聚类)
Step 1: 读取数据
一样的使用pandas库来读取csv文件,顺便使用head方法来查看一下数据的前几项:
# 读取数据
import pandas as pd
data = pd.read_csv('KMeans_Data.csv')

print(data.head())
输出:
         x1        x2  label
0  2.496714  2.926178      0
1  1.861736  3.909417      0
2  2.647689  0.601432      0
3  3.523030  2.562969      0
4  1.765847  1.349357      0
其散点分布如图所示:
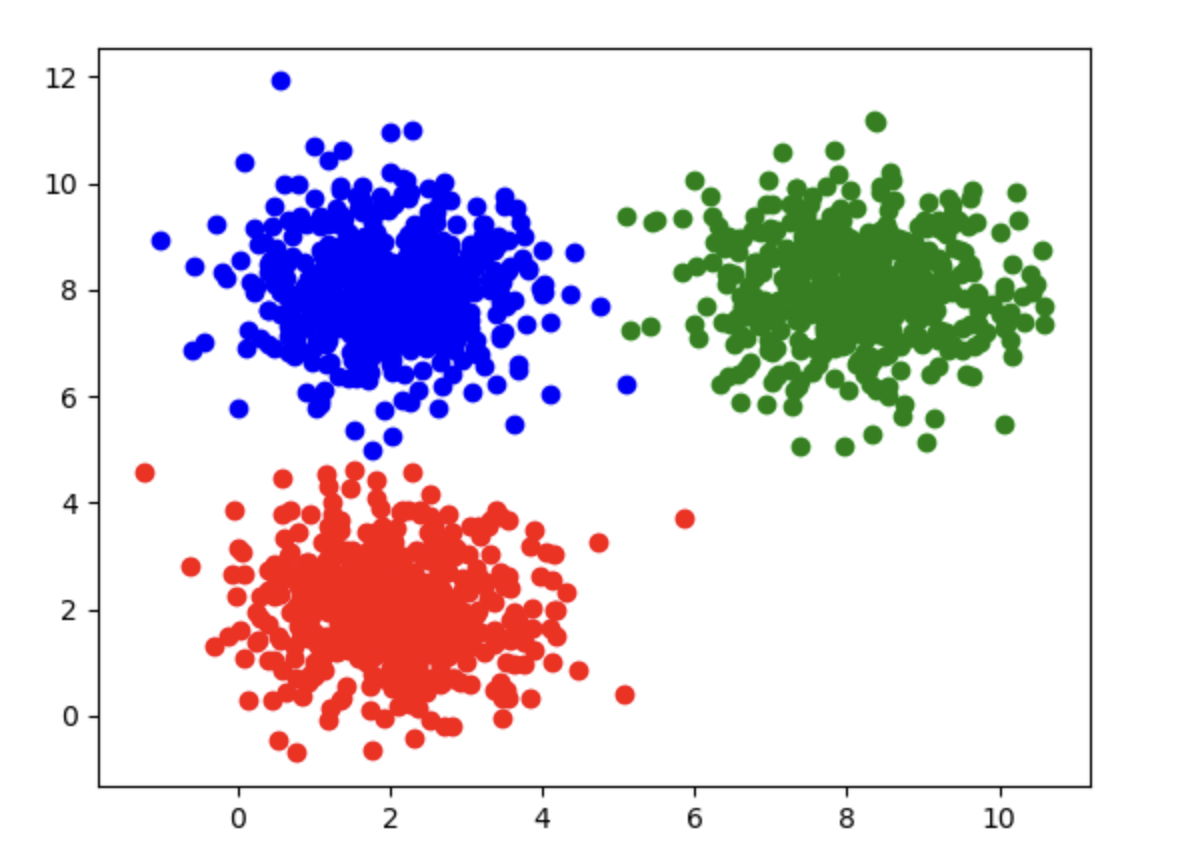
Step 2: 给x和y赋值
# 给x和y赋值
x = data.drop(['label'], axis=1)
y = data.loc[:,'label']
Step 3: 训练模型
把特征和标签喂给scikit-learn下的KNN分类器进行训练:
# 训练模型
from sklearn.neighbors import KNeighborsClassifier
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(x, y)
n_neighbors是KNN中指定的K值(详见 2.2. 聚类分析算法理论)- 与 KMeans/MeanShift 不同,KNN 训练时使用标签:
fit(x, y)
Step 4: 获取预测值
训练完成后,可以随便找一个点看KNN模型会给它分到哪一类:
# 一个小测
y_predict = knn.predict([[10, 10]])
print(y_predict)
输出:
[1]
Step 5: 计算准确率
# 计算准确率
from sklearn.metrics import accuracy_score
y_predict = knn.predict(x)
print(accuracy_score(y, y_predict))
输出:
1.0
因为 KNN 是有监督的,并且用 label 进行了训练,其预测类别 ID 在设计上就与 label 对齐(这里训练集准确率为 1.0)。这与 KMeans/MeanShift 不同:后者的簇编号是任意的,与 label 比较前可能需要重映射(见 2.4)。
2.5.3. MeanShift实现聚类分析
Step 1: 读取数据
与上文相同,这里不再重复。
Step 2: 给x和y赋值
与上文相同,这里不再重复。MeanShift 只需要 x;y 仅在后面评估时使用。
Step 3: 训练模型
把数据喂给scikit-learn下的MeanShift模型进行训练即可:
# 训练模型
from sklearn.cluster import MeanShift, estimate_bandwidth
bandwidth = estimate_bandwidth(x, quantile=0.3)

model = MeanShift(bandwidth=bandwidth)
model.fit(x)
estimate_bandwidth(x, quantile=0.3)用于根据数据估计带宽,再传入MeanShift(bandwidth=bandwidth)。quantile控制带宽大小(与 sklearn 在MeanShift(bandwidth=None)时默认估计带宽的方式一致)。也可以传入n_samples用子样本来估计(详见 2.2. 聚类分析算法理论)。
Step 4: 获取预测值
# 获取预测值
y_predict = model.predict(x)
Step 5: 计算准确率
# 计算准确率
from sklearn.metrics import accuracy_score
print(accuracy_score(y, y_predict))
输出:
0.9986666666666667
这说明我们的模型效果非常好,准确率非常接近百分百。
还是强调一下MeanShift模型本身不知道label,所以它的划分是随意的,虽然也会分为3类,但MeanShift划分的0、1、2类不一定和label的0、1、2类一一对应。
这里只是凑巧一一对应上了,如果你发现正确率异常的低,大概率是标签没对上。
如果你需要校正标签,详见 2.4. K均值聚类(KMeans Analysis)实战(进阶)。
3.1. 决策树理论(基础)
3.1.1. 常用的分类方法
在之前的文章中我们介绍了以下的这些分类方法:
- 逻辑回归:在知道标签的情况下来寻找决策边界
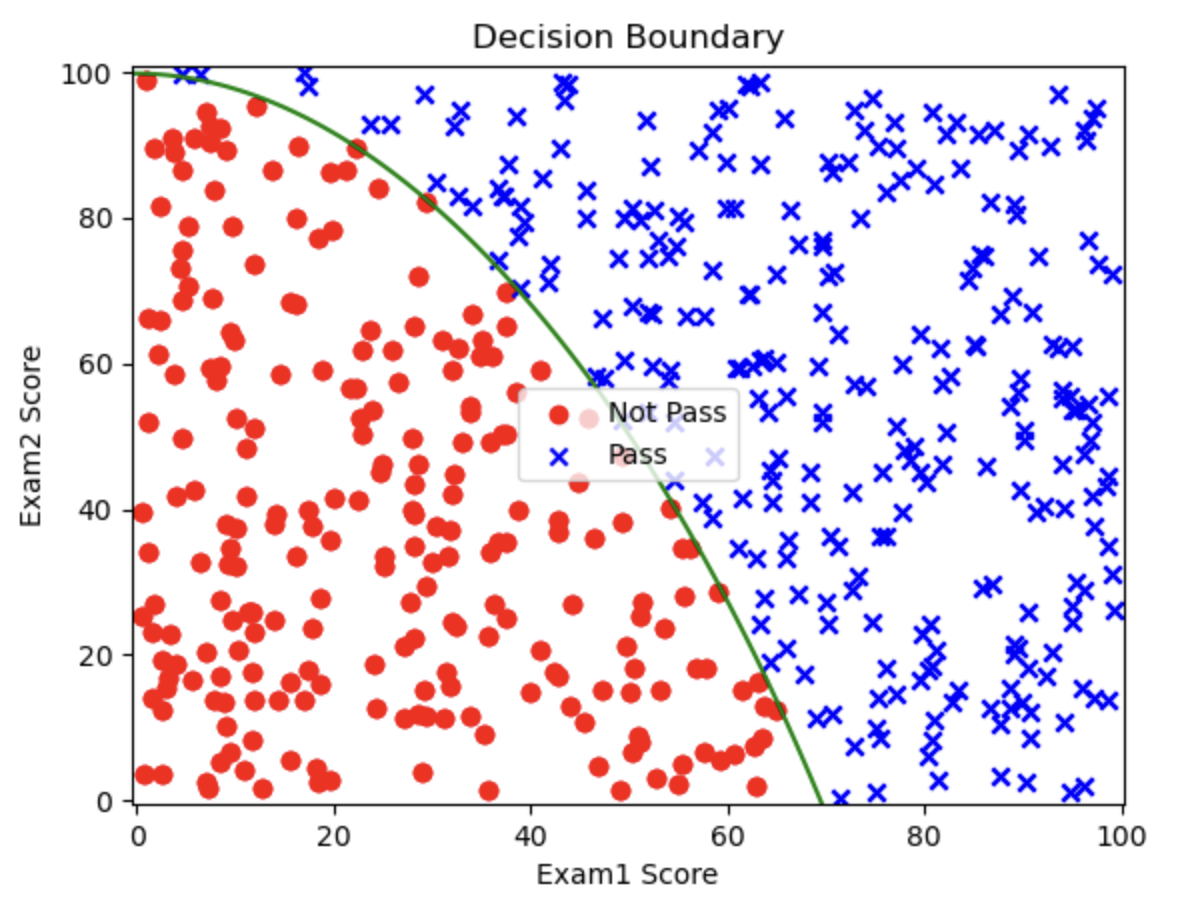
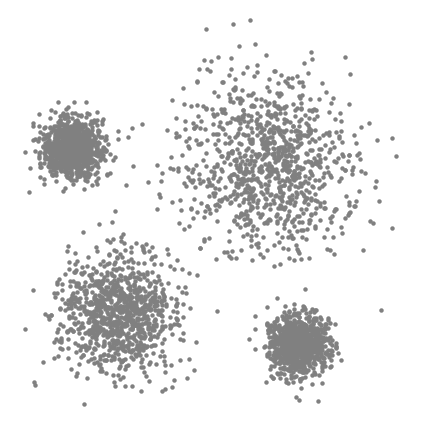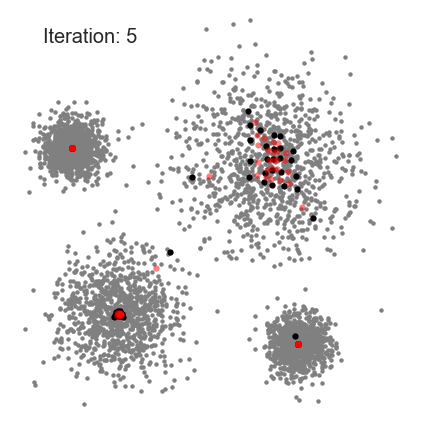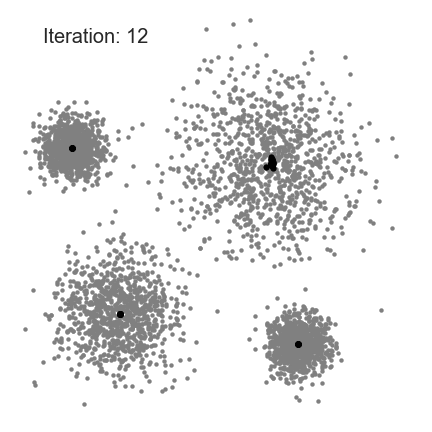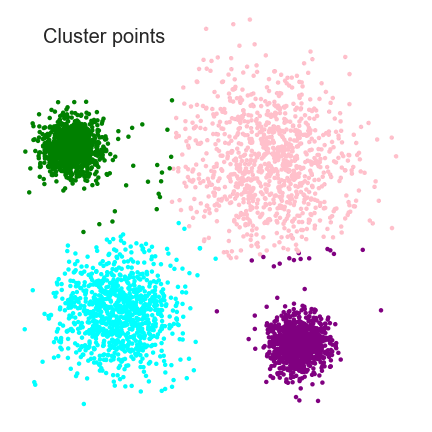
- KMeans和MeanShift:在不知道标签的情况下进行划分
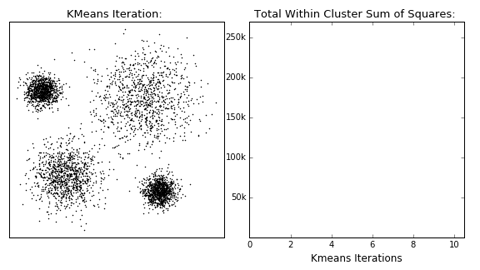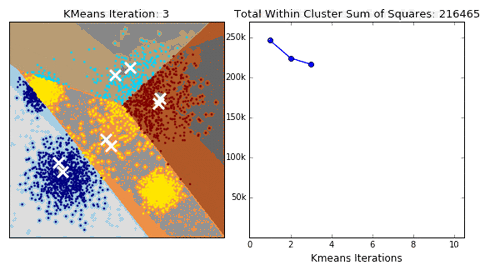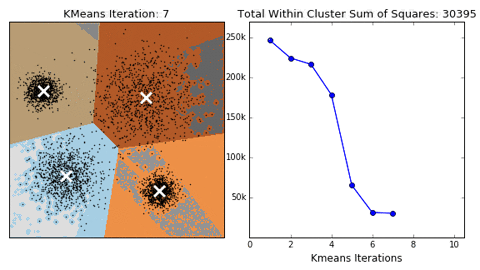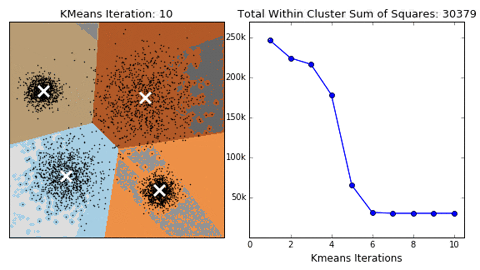
MeanShift:
- KNN:根据已知标签的近邻对新样本进行分类
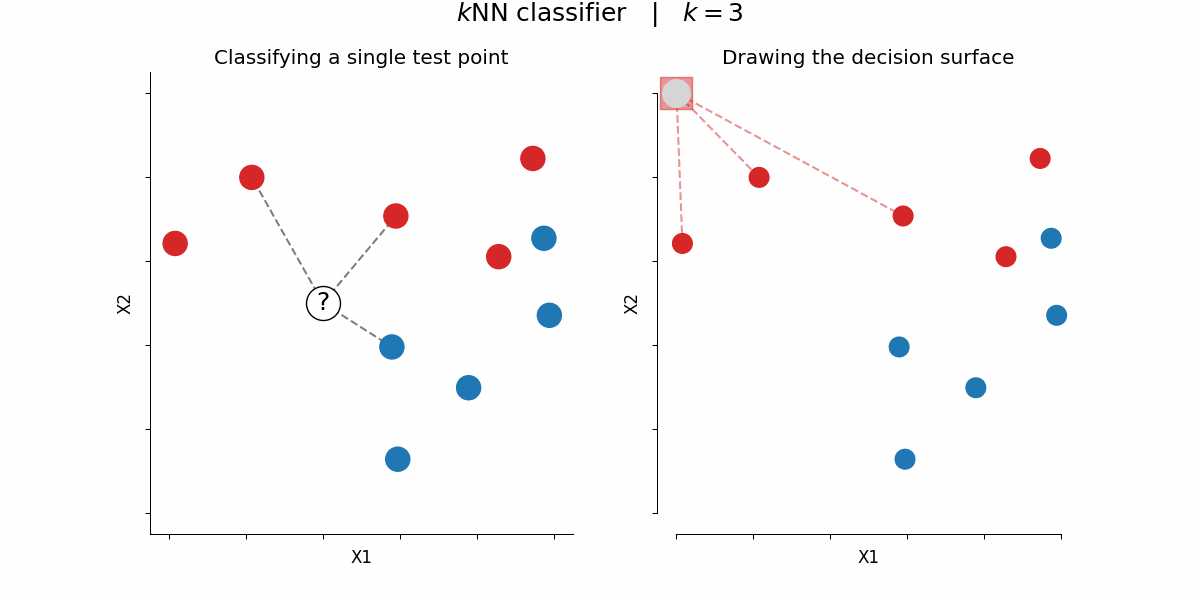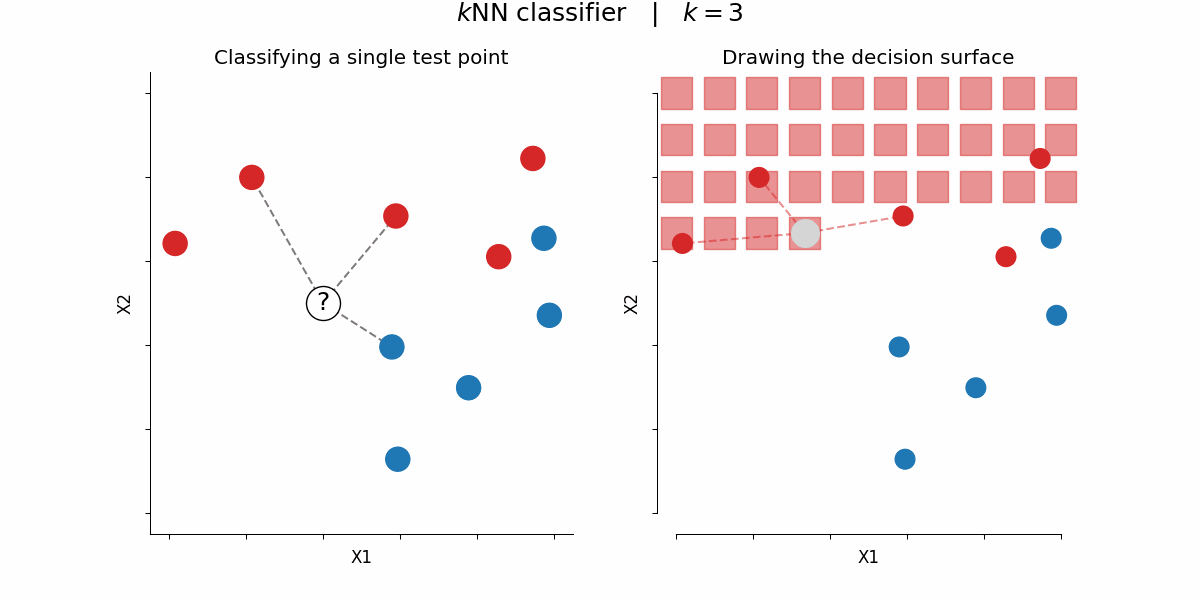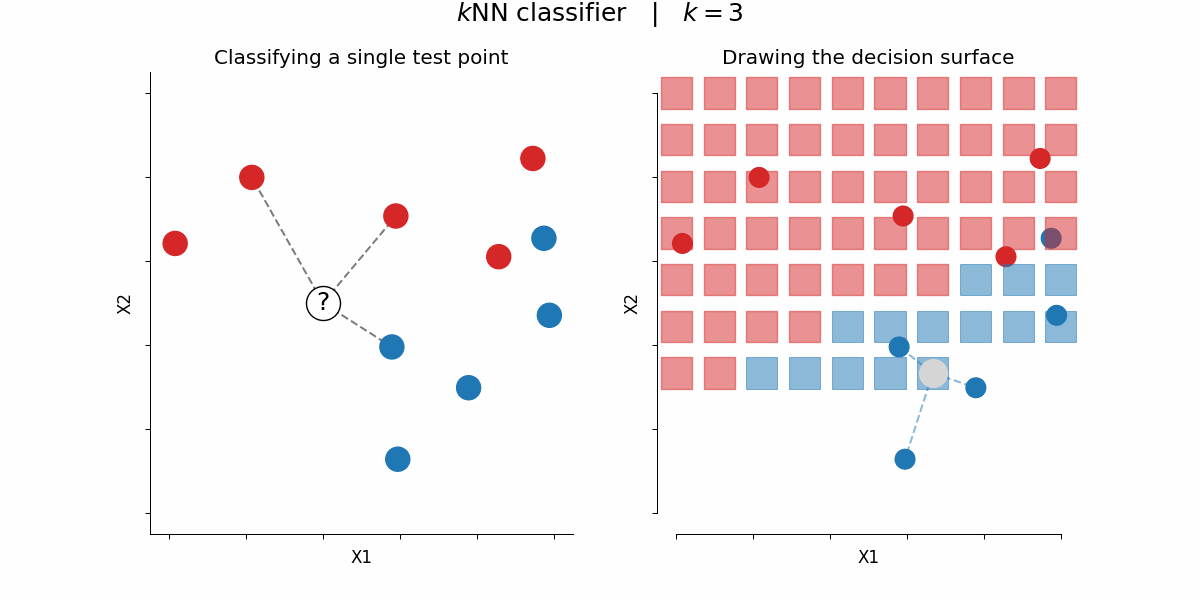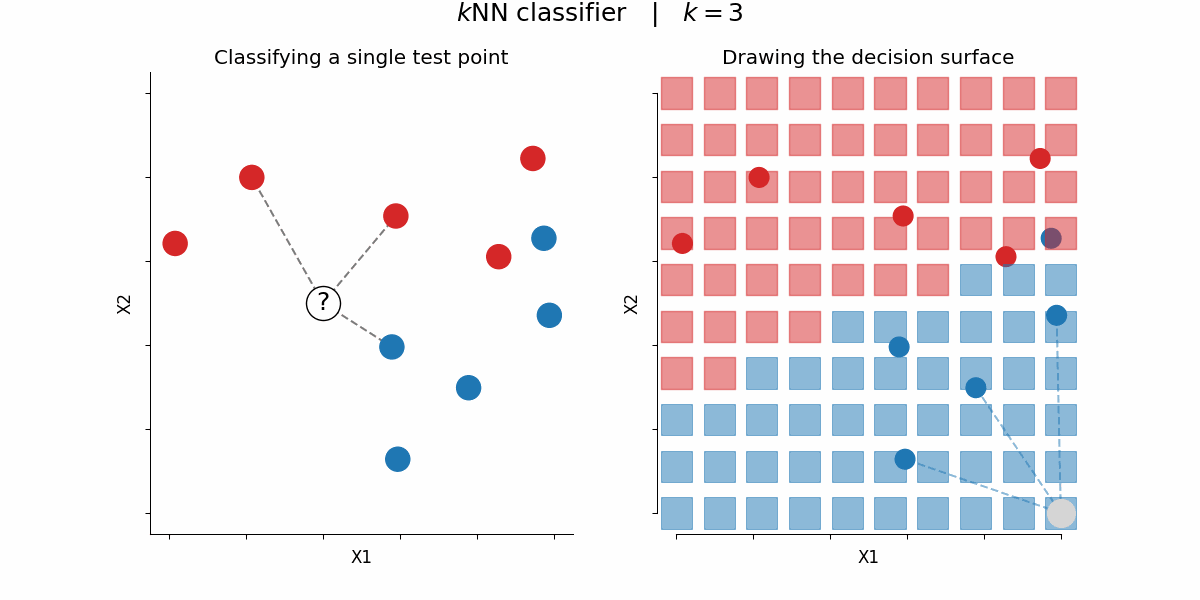
3.1.2. 新的分类方法:决策树
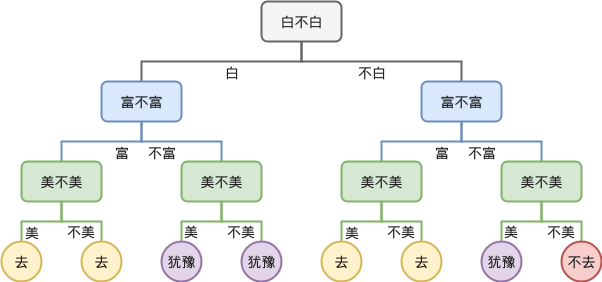
这里我们介绍一个新的分类方法:决策树。
它的特点在于会形成多层的“是否判断”:
3.1.3. 逻辑回归 vs. 决策树
我们用一个例子来了解一下决策树,顺便借此把它和逻辑回归做一个清晰的分析:
根据用户的学习动力、能力提升意愿、兴趣度、空余时间,判断其是否适合学习AI的课程。假设判断需要4个因素——学习,能力、兴趣、时间。
逻辑回归解法
使用逻辑回归来解决这个问题会需要先建立一个模型: $$ Z = w_1 \times 动力 + w_2 \times 时间 + w_3 \times 兴趣 + w_4 \times 能力 $$
- 其中$w_1$、$w_2$、$w_3$、$w_4$是权重参数
再搭配上逻辑回归的逻辑(Sigmoid)函数: $$ P(x) = \frac{1}{1 + e^{-x}} $$ 即可算出$P(x)$,也就是适合学习某个课程的概率。
决策树解法
而使用决策树会使用到如下的框架:
graph TD;
    A[是否特别想了解或学习AI] -->|yes| B[适合]
    A -->|no| C[是否想提升能力]
    C -->|no| D[不适合]
    C -->|yes| E[是否对AI感兴趣]
    E -->|no| F[不适合]
    E -->|yes| G[每周有1小时学习时间]
    G -->|no| H[不适合]
    G -->|yes| I[适合]

    %% 定义样式
    classDef red fill:#D9534F,stroke:#000,color:#fff;
    classDef blue fill:#337AB7,stroke:#000,color:#fff;

    class B red;
    class I red;
    class D blue;
    class F blue;
    class H blue;
总结
逻辑回归的思路是把所有的因子都一次性都给模型,然后让它建立一个方程,预测出对应的概率。
决策树则是进行很多是否(if-else)的判断。
3.1.4. 决策树的定义
决策树是一种对实例进行分类的树形结构,通过多层判断区分目标所属类别。
其本质是通过多层判断,从训练数据集中归纳出一组分类规则。
它的优点在于:
- 计算量小,运算速度快
- 易于理解,可以清晰地查看各属性的重要性
它的缺点在于:
- 没有考虑到属性间的相关性
- 样本类别分布不均时,容易影响模型表现
3.1.5. 决策树求解核心问题
假设给定训练数据集:
$$ D = {(x_1, y_1), (x_2, y_2), …, (x_N, y_N)} $$
其中, $x_i = (x_i^{(1)}, x_i^{(2)}, …, x_i^{(m)})^T$ 为输入实例,$m$ 为特征个数,$y_i \in {1,2,3,…,K}$为类标记,$i = 1,2,…,N$,$N$ 为样本容量。
我们的目标是根据训练数据集结构创建一个决策树模型,使它能对实例进行正确的分类。
决策树求解的核心问题就在于特征选择。更具体地说是:每一个节点应该选用哪个特征。
节点之后会按所选特征的取值进行分叉,因此选择节点本身的特征是比较关键的。
3.1.6. 决策树求解举例
我们还是使用上文的那个简单例子:
根据用户的学习动力、能力提升意愿、兴趣度、空余时间,判断其是否适合学习AI的课程。假设判断需要4个因素——学习,能力、兴趣、时间。
数据如下:
| ID | 动力 | 想提升能力 | 有兴趣 | 时间 | 类别 |
|---|---|---|---|---|---|
| 1 | 一般 | 否 | 否 | 有 | 否 |
| 2 | 一般 | 否 | 是 | 无 | 否 |
| 3 | 很强 | 是 | 是 | 有 | 是 |
| 4 | 一般 | 否 | 否 | 有 | 否 |
| 5 | 一般 | 否 | 否 | 无 | 否 |
| 6 | 一般 | 是 | 否 | 无 | 否 |
| 7 | 一般 | 是 | 是 | 有 | 是 |
| 8 | 一般 | 是 | 是 | 有 | 是 |
| 9 | 很强 | 是 | 是 | 有 | 是 |
| 10 | 很弱 | 否 | 否 | 无 | 否 |
这些数据有些因子有3种分支,有的只有2种:
graph TD;

    A(动力) --> B[很强]

    A --> C[一般]

    A --> D[很弱]
graph TD;

    A(时间) --> B[有]

    A --> C[无]
…
建立决策树我们就得决定是以哪个因子作为顶点,这点非常重要,因为不同的特征决定不同的决策树:是以动力呢?还是以时间呢?亦或者是以其它因子呢?
我们一般有3种方法:
- ID3(详见 3.2. 决策树理论(进阶))
- C4.5
- CART
3.2. 决策树理论(进阶):ID3算法、信息熵原理、信息增益
本文承接 3.1. 决策树理论(基础),没看过的建议先看前文。
3.2.1. ID3算法数学原理
ID3方法利用信息熵原理选择信息增益最大的属性作为分类属性,递归地拓展决策树的分支,完成决策树的构造。
信息熵(entropy)是度量随机变量不确定性的指标。熵越大,变量的不确定性就越大。假定当前样本集合$D$中第$k$类样本所占的比例为$p_k$,则$D$的信息熵为: $$ \text{Ent}(D) = - \sum_{k=1}^{|y|} p_k \log_2 p_k $$ $Ent(D)$的值越小,变量的不确定性越小。$p_k=1$时,就只有一种情况,代表没有不确定性,所以熵就是$Ent(D) = 0$。
根据信息熵,可以计算以属性$a$进行样本划分带来的信息增益: $$ \text{Gain}(D, a) = \text{Ent}(D) - \sum_{v=1}^{V} \frac{D^v}{D} \text{Ent}(D^v) $$
- $V$为根据属性$a$划分出的类别数
- $D$为当前样本总数
- $D^v$为类别$v$样本数,也就是属性$a$取值$v$时的子数据集。
其中:
-
$\text{Ent}(D)$是划分前的信息熵,在划分前,数据集$D$可能包含多个类别
-
$\sum_{v=1}^{V} \frac{D^v}{D} \text{Ent}(D^v)$是划分后的信息熵:
- 通过属性$a$进行划分后,$D$被分割成多个子集$D^1$, $D^2$, $\dots$, $D^V$,每个子集有各自的信息熵$\text{Ent}(D^v)$
- 计算时,每个子集的信息熵按其占总数据集的比例$\frac{D^v}{D}$进行加权求和
假如我们有以下数据:
| ID | 动力 | 想提升能力 | 有兴趣 | 时间 | 类别 |
|---|---|---|---|---|---|
| 1 | 一般 | 否 | 否 | 有 | 否 |
| 2 | 一般 | 否 | 是 | 无 | 否 |
| 3 | 很强 | 是 | 是 | 有 | 是 |
| 4 | 一般 | 否 | 否 | 有 | 否 |
| 5 | 一般 | 否 | 否 | 无 | 否 |
| 6 | 一般 | 是 | 否 | 无 | 否 |
| 7 | 一般 | 是 | 是 | 有 | 是 |
| 8 | 一般 | 是 | 是 | 有 | 是 |
| 9 | 很强 | 是 | 是 | 有 | 是 |
| 10 | 很弱 | 否 | 否 | 无 | 否 |
假如我们要算动力的信息增益:
- 属性$a$就是动力
- 类别数$V$就是3(动力有一般、很强、很弱三个类别)
- 样本总数$D$就是10
3.2.2. 举例计算
使用ID3的目标就是划分后样本分布不确定性尽可能小,即划分后信息熵小,信息增益大。
我们就使用上文表格里的数据来计算该使用哪一个因子作为顶点节点。
为了判断属性,我们得计算每一个属性下对应的信息增益。
先计算进行属性划分之前的信息熵,套用公式:
- 总共有两个类别——“是”和“否”
- “否”一共有6
- 所以$p_1 = 6/10$,$p_2 = 4/10$
代入公式: $$ \text{Ent}(D) = - \left( \frac{6}{10} \log_2 \frac{6}{10} + \frac{4}{10} \log_2 \frac{4}{10} \right) \approx 0.971 $$ 这是属性划分之前的信息熵,接下来计算划分之后的,这里我们取兴趣这个属性为例:
属性有两种划分——“是”和“否”,那我们就分别计算“是”和“否”对应的信息熵然后乘上比例再求和:
“否”有5个,且每当兴趣为“否”时最后的类别一栏的值就是“否”,没有其它可能性,就代表$Ent(D_1) = 0$。
“是”有5个,且当兴趣为“是”时最后的类别一栏的值有1个是“否”,4个是“是”,也就是$p_1 = 1/5$,$p_2 = 4/5$,代入计算$Ent(D_2)$: $$ \text{Ent}(D_2) = - \left( \frac{1}{5} \log_2 \frac{1}{5} + \frac{4}{5} \log_2 \frac{4}{5} \right) \approx 0.722 $$ 有了这些信息就可以计算划分后的信息熵: $$ \sum_{v=1}^{V} \frac{D^v}{D} \text{Ent}(D^v) = \frac{5}{10} \times Ent(D_1) + \frac{5}{10} \times Ent(D_2) $$ 最后的结果是: $$ \sum_{v=1}^{V} \frac{D^v}{D} \text{Ent}(D^v) \approx 0.361 $$
再把这个结果带入计算信息增益的函数即可: $$ Gain = Ent(D) - \sum_{v=1}^{V} \frac{D^v}{D} \text{Ent}(D^v) \approx 0.971 - 0.361 = 0.61 $$ 我们把其他也算出来,方法同上,我就只展示结果不展示过程了:
| 动力 | 能力 | 兴趣 | 时间 | |
|---|---|---|---|---|
| Ent | 0.60 | 0.36 | 0.36 | 0.55 |
| Gain | 0.37 | 0.61 | 0.61 | 0.42 |
兴趣和能力划分后的信息增益并列最大(划分后的纯度相同)。二者都可以作为根节点;这里我们取兴趣作为第一个节点。
3.2.3. 最终效果
我们可以看一下决策树算法最后算出来的效果:
graph TD;
    A["兴趣 ≤ 0.5 entropy = 0.971 samples = 10 value = [6, 4] class = 不合适"] --> B["entropy = 0.0 samples = 5 value = [5, 0] class = 不合适"]
    A --> C["时间 ≤ 0.5 entropy = 0.722 samples = 5 value = [1, 4] class = 合适"]
    C --> D["entropy = 0.0 samples = 1 value = [1, 0] class = 不合适"]
    C --> E["entropy = 0.0 samples = 4 value = [0, 4] class = 合适"]
可以看到,原本有4个属性,但是这里只是用了2个属性就把所有可能性划分出来了(基于表格提供的数据)。
3.3. 异常检测(Anomaly Detection)理论:概率密度、正态分布
3.3.1.什么是异常检测?
我们来举一个现实生活中的例子:
银行是如何判断信用卡的消费是不是被盗刷的呢?有2个很重要的因素就是交易金额的大小和交易时间的早晚,那些交易金额异常的大且交易时间异常的晚的消费会被识别为有盗刷嫌疑。
图中的蓝点代表正常的消费,红点代表有盗刷嫌疑的消费。我们就可以通过异常检测来找出有盗刷嫌疑的消费并进行阻止。
更多的案例:
- 劣质产品检测(工业)
- 缺陷基因检测(医疗)
- ……
3.3.2. 一维异常检测的数学原理
整体思路
异常检测就是根据输入数据,对不符合预期模式的数据进行识别。
假设我们有一个一维的数据集: $$ { x^{(1)}, x^{(2)}, \dots, x^{(m)} } $$ 它在一维中的分布如下:
我们需要找到异常点得先画出概率密度,如下:
左右的概率密度比较低,中间的概率密度高。当有些数据出现在密度小于$\epsilon$(决策阈值)的时候,就认为这个数据是异常的。
概率密度
概率密度函数是一个描述随机变量在某个确定的取值点附近的可能性的函数。
其中x轴对应可能的数据点或某一个事件,$p(x)$是概率密度(本身并不是概率)。
如果我们要算区间$(x_1,x_2)$的概率,就是概率密度求积分: $$ P(x_1, x_2) = \int_{x_1}^{x_2} p(x) ,dx $$
正态分布(高斯分布)
正态分布(高斯分布)的概率密度函数是: $$ p(x) = \frac{1}{\sigma \sqrt{2\pi}} e^{-\frac{(x - \mu)^2}{2\sigma^2}} $$ 其中:
- $p(x)$:在正态分布下,随机变量$x$取值在某个位置的概率密度
- $\mu$(均值,Mean):决定正态分布的中心位置,表示数据的平均值
- $\sigma$(标准差,Standard Deviation):衡量数据的离散程度,决定正态分布的宽度,值越大,曲线越平缓;值越小,曲线越陡峭
- $\sigma^2$(方差,Variance):标准差的平方,衡量数据分布的离散程度
- $\sqrt{2\pi}$:归一化常数,确保概率密度函数的总面积为1
$\mu$(数据均值)和$\sigma$(标准差)的计算公式是: $$ \mu = \frac{1}{m} \sum_{i=1}^{m} x^{(i)}, \quad
\sigma^2 = \frac{1}{m} \sum_{i=1}^{m} (x^{(i)} - \mu)^2 $$ 正态分布(高斯分布)的图形如下:
这是一条对称分布的曲线,以均值$\mu$作为对称轴。两侧的$\sigma$越小代表数据越集中,在图像上就会形成一个更窄的峰。
计算流程
- 计算数据均值$\mu$和标准差$\sigma$
- 计算对应的高斯分布概率函数: $$ p(x) = \frac{1}{\sigma \sqrt{2\pi}} e^{-\frac{(x - \mu)^2}{2\sigma^2}} $$
- 根据数据点的概率密度进行判断:如果该点对应的密度小于决策阈值$\epsilon$,那么就把该点视为异常点。
举例计算
我们举个小例子:
| $x_1$ | $x_2$ | $x_3$ | $x_4$ |
|---|---|---|---|
| -1 | 0 | 1 | 2 |
我们先来算数据均值$\mu$: $$ \mu = \frac{1}{m} \sum_{i=1}^{m} x^{(i)} = \frac{(-1) + 0 + 1 + 2}{4} = \frac{2}{4} = 0.5 $$ 再算标准差$\sigma$: $$ \sigma^2= \frac{1}{4} \left[ (-1 - 0.5)^2 + (0 - 0.5)^2 + (1 - 0.5)^2 + (2 - 0.5)^2 \right] = 1.25 $$ 带入概率密度函数(这里我们只展示$x_1$的计算过程,其他的算法一样):
-
计算前导因子: $$ \frac{1}{\sigma \sqrt{2\pi}} = \frac{1}{1.118 \times \sqrt{2\pi}} = \frac{1}{1.118 \times 2.506} = \frac{1}{2.801} \approx 0.3571 $$
-
计算指数部分: $$ -\frac{(x - \mu)^2}{2\sigma^2} = -\frac{(-1 - 0.5)^2}{2 \times (1.118)^2} = -\frac{(-1.5)^2}{2 \times 1.25} = -\frac{2.25}{2.5} = -0.9 e^{-0.9} \approx 0.4066 $$
-
计算最终的概率密度: $$ p(-1) = 0.3571 \times 0.4066 \approx 0.1451 $$
3.3.3. 高维异常检测的数学原理
但是在实际场景中我们的数据往往是高于一维的: $$ \left{ \begin{array}{cccc} x_1^{(1)}, & x_1^{(2)}, & \dots, & x_1^{(m)} \ \vdots & \vdots & \ddots & \vdots \ x_n^{(1)}, & x_n^{(2)}, & \dots, & x_n^{(m)} \end{array} \right} $$ 这个时候该如何计算呢?
其实核心思路和一维是一样的:
- 我们先计算出数据均值$\mu_1, \mu_2, \dots, \mu_n$和标准差$\sigma_1, \sigma_2, \dots, \sigma_n$,公式同上: $$ \mu = \frac{1}{m} \sum_{i=1}^{m} x^{(i)}, \quad \sigma^2 = \frac{1}{m} \sum_{i=1}^{m} (x^{(i)} - \mu)^2 $$
- 计算好了这些以后就能计算出对应维度下的概率密度函数$p(x_1),\dots,p(x_n)$,把它们相乘就得到高维下的总概率密度函数: $$ p(x) = \prod_{j=1}^{n} p(x_j; \mu_j, \sigma_j^2) = \prod_{j=1}^{n} \frac{1}{\sigma_j \sqrt{2\pi}} e^{-\frac{(x_j - \mu_j)^2}{2\sigma_j^2}} $$
- 最后用高维下的总概率密度来和决策阈值$\epsilon$做比较,小于阈值的部分就是异常数据: $$ p(x) < \epsilon $$
3.4. 主成分分析(Principal Component Analysis)理论
3.4.1. 数据降维(Dimensionality Reduction)
数据降维指的是把数据从高维度转为低维度,在这个过程中尽可能保证最后创建出的模型的精度。
具体是怎么样的我们通过一个例子来讲解:
通过美国1929-1938年各年经济数据,预测国民收入与支出。具体的数据包括17个指标:雇主补贴、消费资料和生产资料、纯公共支出、净增库存、股息、利息、外贸平衡等…
如果按照标准的做法我们需要为每一个指标都进行一次建模,但这对于当时的计算机能力来说非常棘手。
所以当时的统计学家就使用了数据降维把数据降到了只剩3维:
- 总收入$F_1$
- 总收入变化率$F_2$
- 经济发展趋势$F_3$
仅仅通过这三个指标就达到了97.4%的预测精度,可以说非常厉害。
定义
数据降维是指在某些限定条件下,降低随机变量个数,得到一组“不相关”的主变量的过程。
其作用在于:
- 减少模型分析的数据量,提升处理效率,降低计算难度
- 实现数据的可视化
例子
我们先看一个从2维降到1维的例子:
原本这些散点都是二维数据,但是我们发现身高和体重之间有正相关性,所以我们可以把这些散点投影到一条直线上。用这个直线的解析式来代替身高和体重。
这条直线不叫身高也不叫体重,而是一个综合因子,是身高和体重的组合。然后我们把对应的数据点投影在上面。
3.4.2. 数据降维的实现:主成分分析(Principal Component Analysis)
主成分分析(Principal Component Analysis,简称PCA)是数据降维技术中应用最多的方法。
使用主成分分析的目标是寻找$k(k<n)$ 维的新数据,使它们反映事物的主要特征。其核心是在信息损失尽可能小的情况下,降低数据维度。
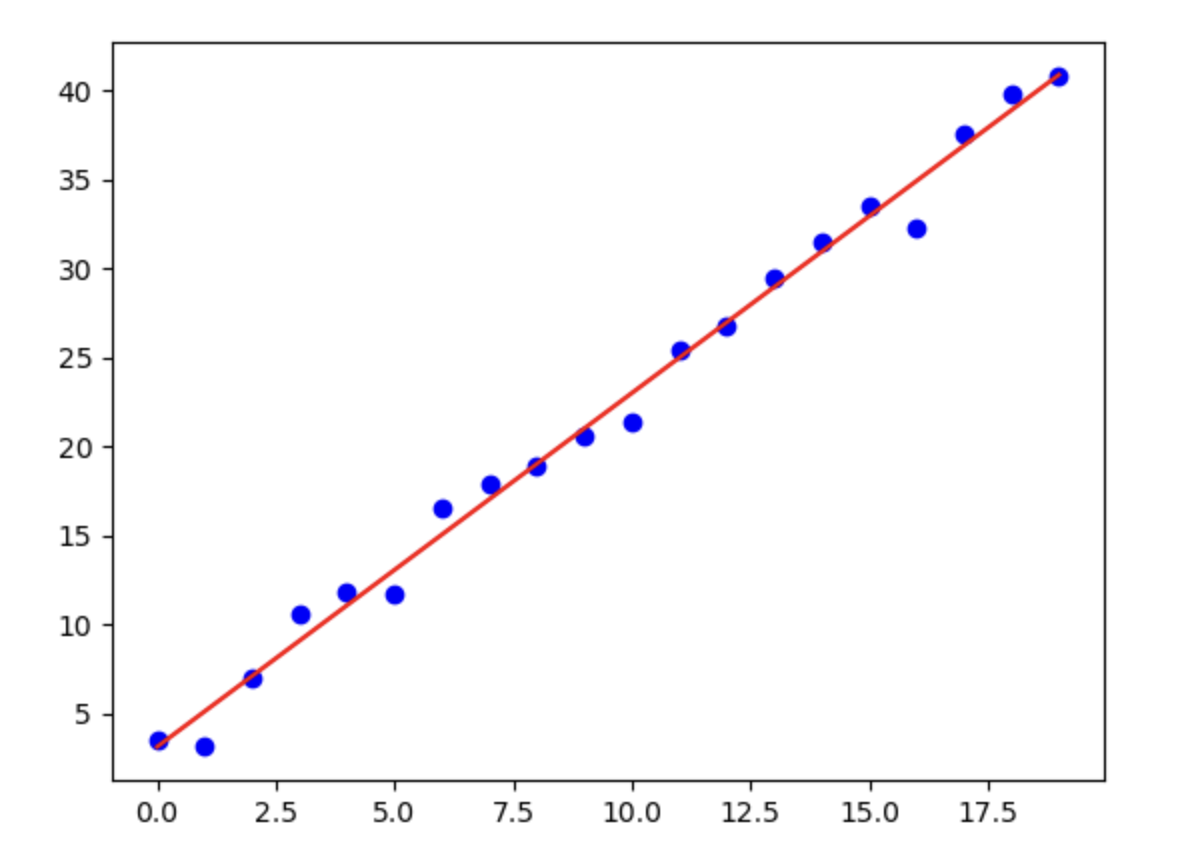
而在降维过程中损失的信息就是散点和直线的偏差值之和。也就是说,散点到直线的距离$\delta$之和要尽可能小。
从三维降二维就是投影到向量$u_1$和$u_2$形成的平面,保持所有散点到这个平面的偏差值最小:
从$n$维降到$k$维就是投影到$u_1, u_2, \dots, u_k$形成的空间,保持所有散点到这个空间的偏差值最小。
那怎么样保证投影的空间能保留最主要的信息呢?
我们之前讲到了当数据的维度很高时,每个维度之间会有很多的相关性。降维到最后你会希望每一个维度里的数据相关性最少,如果多个维度的特征高度相关,就意味着数据中的信息是冗余的,可以用更少的维度来表示相同的信息,就得继续使用PCA。
那么如何实现降维到最后你会希望每一个维度里的数据不要有太多的相关性呢?
我们需要使投影后数据的方差最大,因为方差越大数据也越分散。
计算过程是:
- 原始数据预处理:也就是标准化,因为不同维度的量纲不一定一样。我们先把数据进行一次变换,保证均值$\mu = 0$, 标准差$\sigma = 1$
- 计算协方差矩阵特征向量、及数据在各特征向量投影后的方差
- 按投影方差(特征值)对主成分方向排序:保留方差最大的$k$个方向,丢弃低方差方向(信息较少),最后降到$k$维
- 选取这$k$维特征向量,计算数据在其形成空间的投影
PCA vs. 线性回归
PCA在2维转1维时会涉及散点到线的拟合,这时候很多人会把它和线性回归搞混,但实际上它们背后的数学方法完全不一样:
| 比较项 | PCA(降维) | 线性回归(预测) |
|---|---|---|
| 目标 | 发现数据中最大方差的方向,进行降维 | 预测因变量 ($y$) |
| 方法 | 计算数据的协方差矩阵,找到最大主成分方向 | 通过最小二乘法(OLS)拟合回归直线 |
| 是否有因变量(标签) | 无监督学习 | 有监督学习 |
| 拟合方式 | 使数据点沿最大方差方向投影 | 使预测值 ($\hat{y}$)尽可能接近实际值 ($y$) |
| 直线的方向 | 主成分方向,最大化数据分布的方差 | 最优回归直线,最小化预测误差 |
| 损失函数 | 最大化数据的方差 | 最小化均方误差(MSE) |
| 适用场景 | 降维、特征提取,无因变量 | 预测、回归分析,有因变量 |
3.5. 决策树实战:基于Iris数据集
本文紧承 3.1. 决策树理论(基础) 和 3.2. 决策树理论(进阶),没看过的建议先看理论分析。
3.5.1. Iris数据集
这一章所讲的技术在实战时大部分都使用Iris数据集。Iris鸢尾花数据集是一个非常经典的数据集,在统计学和机器学习领域都经常被用作示例。
下面所示的这个花叫做鸢尾花:
- Petal指的是花瓣
- Sepal指的是花萼
这个数据集总共会有三种共150条记录,每类各50个数据。每条记录都有4项特征:
- 花萼长度(Sepal Length)
- 花萼宽度(Sepal Width)
- 花瓣长度(Petal Length)
- 花瓣宽度(Petal Width)
我们会通过花萼和花瓣的这4个特征来对花进行分类:
- iris-setosa(在数据集中的标签是0)
- iris-versicolour(在数据集中的标签是1)
- iris-virginica(在数据集中的标签是2)
以下是Iris数据集里的部分数据:
| 花萼长度 | 花萼宽度 | 花瓣长度 | 花瓣宽度 | 属种 |
|---|---|---|---|---|
| 5.1 | 3.5 | 1.4 | 0.2 | setosa |
| 4.9 | 3.0 | 1.4 | 0.2 | setosa |
| 4.7 | 3.2 | 1.3 | 0.2 | setosa |
| 4.6 | 3.1 | 1.5 | 0.2 | setosa |
| 5.0 | 3.6 | 1.4 | 0.2 | setosa |
| 5.4 | 3.9 | 1.7 | 0.4 | setosa |
| 4.6 | 3.4 | 1.4 | 0.3 | setosa |
| 5.0 | 3.4 | 1.5 | 0.2 | setosa |
3.5.2. 实战前的准备工作
接下来,请你确保你的Python环境中有pandas、matplotlib、scikit-learn和numpy这几个包,如果没有,请在终端输入指令以下载和安装:
pip install pandas matplotlib scikit-learn numpy
Iris数据集在scikit-learn中内置有,不需要额外安装。
3.5.3. 读取数据及赋值操作
我们可以使用sklearn.datasets的load_iris来加载,顺便把x和y赋值:
# 加载数据集
from sklearn.datasets import load_iris
iris = load_iris()
x, y = iris.data, iris.target
3.5.4. 建立决策树
拆分训练数据
接下来我们需要对训练数据进行拆分,一部分用作训练,一部分用作测试:
# 划分测试集和训练集
from sklearn.model_selection import train_test_split
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2)
train_test_split函数可以让我们轻易地拆分数据test_size=0.2告诉程序80%数据用于训练,20%用于测试
导入模型
首先我们要建立决策树模型,并使用训练集进行训练:
# 训练决策树
from sklearn import tree
clf = tree.DecisionTreeClassifier(criterion='entropy', min_samples_leaf=5)
clf.fit(x_train, y_train)
criterion的不同值让我们可以选择分裂时的不纯度度量,这里我填的是'entropy'(信息增益),思路与ID3算法一致(详见 3.2. 决策树理论(进阶))。需要注意的是,sklearn对连续特征仍使用二分阈值分裂,因此这并不是纯粹的类别型ID3实现。min_samples_leaf让我们得以决定叶子节点所需的最小样本数,如果某分裂所生成的子节点中的样本数少于指定的min_samples_leaf值,那么这次分裂将不会发生。 选择一个合适的值非常重要,因为如果值太小会导致过拟合(不具有普适性),值太大会导致划分不全。
可视化决策树
接下来我们来可视化决策树:
# 可视化决策树
import matplotlib.pyplot as plt
f_names = ['sepal length', 'sepal width', 'petal length', 'petal width']
c_names = ['setosa', 'versicolor', 'virginica']
tree.plot_tree(clf, filled=True, feature_names=f_names, class_names=c_names)
plt.show()
filled=True:
- 指定决策树节点是否填充颜色
- 如果设置为
True,每个节点的填充颜色将反映数据的分类比例或类别 - 颜色深浅可以帮助直观地表示决策树中的输出类别或信息增益
feature_names=f_names:
- 定义决策树中显示的特征名称。
- 代码中设置的值为
f_names = ['sepal length', 'sepal width', 'petal length', 'petal width'],对应于鸢尾花数据集特征的名称 - 这些名称将显示在决策树节点中,帮助理解特征在分类决策中的作用
class_names=c_names:
- 定义决策树中显示的类别名称
- 代码中设置的值为
c_names = ['setosa', 'versicolor', 'virginica'],对应于鸢尾花数据集的三种类别名称 - 这些名称将显示在叶子节点中,指示决策树预测的结果类别
plot_tree是基于matplotlib动态绘图的,显示图像得使用plt.show()
图片输出:
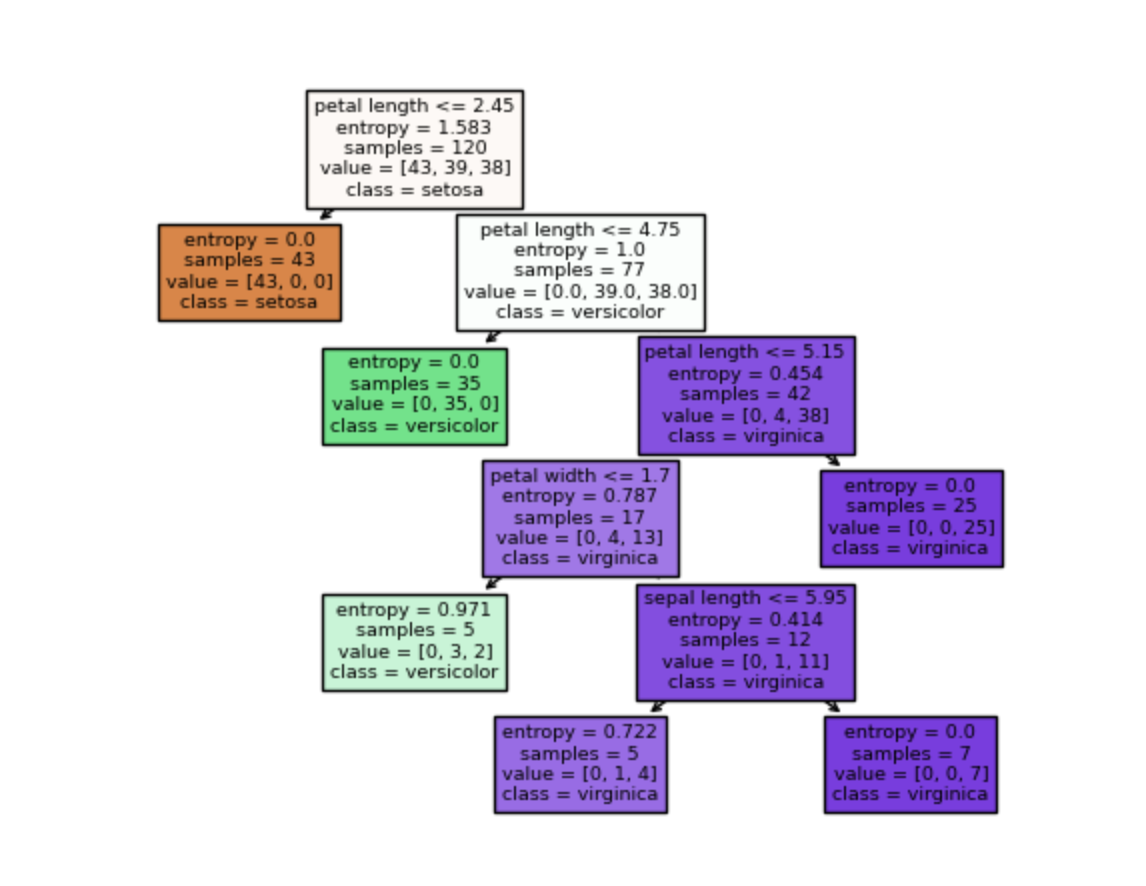
计算准确率
我们接下来会把测试集的数据传给训练好的决策树,把决策树的分类和标签做比较:
# 计算模型在测试集上的准确率
accuracy = clf.score(x_test, y_test)
print(f"测试集准确率: {accuracy:.2f}")
输出:
测试集准确率: 0.93
3.6. 异常检测实战
本文紧承 3.3. 异常检测(Anomaly Detection)理论,没看过的建议先看理论分析。
3.6.1. 实战前的准备工作
接下来,请你确保你的Python环境中有pandas、matplotlib、scikit-learn和numpy这几个包,如果没有,请在终端输入指令以下载和安装:
pip install pandas matplotlib scikit-learn numpy scipy
我把数据放到了GitCode上,可以点击链接去下载和查看。文件一共有3栏:x1, x2和label,x1和x2是输入变量,label是标签,要么是0要么是1。如果是正常点就是1,否则就是0。
下载下来后把这个文件放到你的Python项目文件夹里即可。
3.6.2. 建立异常检测数据模型
Step 1: 读取数据
使用pandas库来读取.csv文件:
# 导入数据
import pandas as pd
data = pd.read_csv('error_detection_data.csv')

print(data.head())
输出:
         x1        x2  label
0 -1.630353 -4.839381      1
1  4.995439  2.821713      1
2 -0.942488 -3.756172      1
3 -2.795116  2.975474      1
4  2.624829  1.159119      1
Step 2: 输入数据可视化
我们使用matplotlib来对输入的数据进行可视化:
# 可视化数据
x1 = data.loc[:, 'x1']
x2 = data.loc[:, 'x2']
y = data.loc[:, 'label']


import matplotlib.pyplot as plt
plt.scatter(x1, x2, c=y)
plt.show()
输出图片:
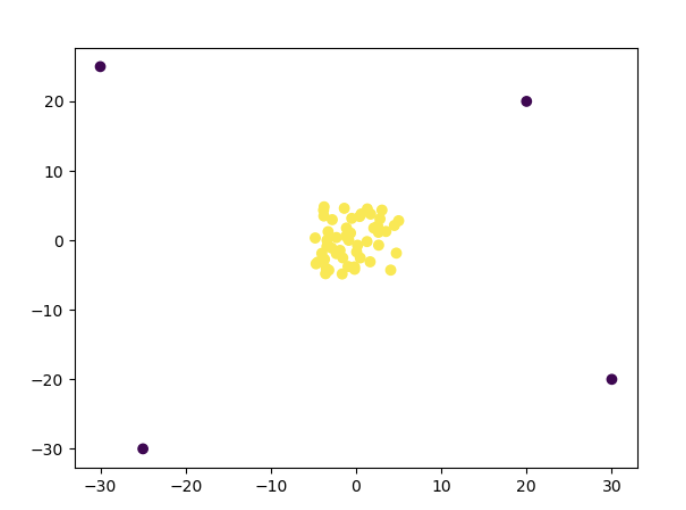
可以很明显地看到,四角各有一个错误点。
不止如此,我们还可以使用hist方法来画数据的分布情况:
plt.hist(x1, bins=100, color='red')
plt.hist(x2, bins=100, color='blue')
plt.show()
bins这个参数用于控制生成的图有多少个区间,我填的100就会生成100个区间
输出图片:
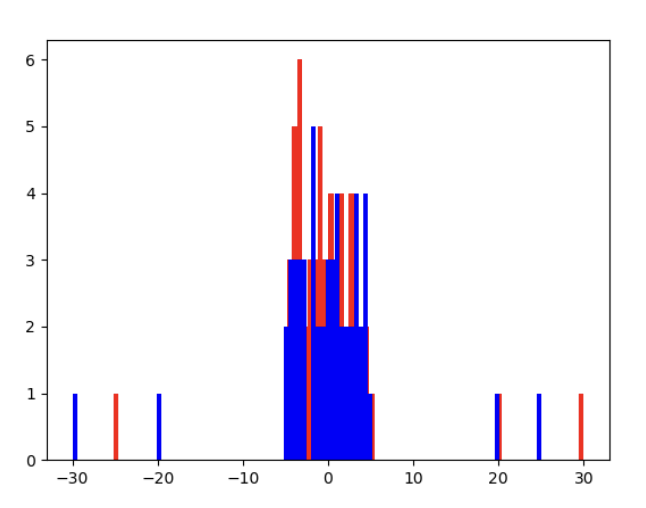
- 红色是
x1 - 蓝色是
x2
Step 3: 概率密度函数计算
为了查找异常点,我们得计算正态分布的概率密度函数。正态分布的公式是: $$ p(x) = \frac{1}{\sigma \sqrt{2\pi}} e^{-\frac{(x - \mu)^2}{2\sigma^2}} $$ 其中的参数只有两个:
- $\mu$(均值,Mean):决定正态分布的中心位置,表示数据的平均值
- $\sigma$(标准差,Standard Deviation):衡量数据的离散程度,决定正态分布的宽度,值越大,曲线越平缓;值越小,曲线越陡峭
我们得先计算这两个参数。幸运的是Python提供了函数,不需要我们手动写代码:
# 计算数据均值和标准差
x1_mean = x1.mean()
x2_mean = x2.mean()
x1_std = x1.std()
x2_std = x2.std()
然后使用scipy下的norm模块来计算高斯分布并用matplotlib画出来:
# 画正态分布
from scipy.stats import norm
import numpy as np
x1_range = np.linspace(x1.min(), x1.max(), 100)
normal1 = norm.pdf(x1_range, x1_mean, x1_std)
x2_range = np.linspace(x2.min(), x2.max(), 100)
normal2 = norm.pdf(x2_range, x2_mean, x2_std)

import matplotlib.pyplot as plt

# 绘制正态分布曲线
plt.figure(figsize=(10, 5))

# 第一条正态分布曲线
plt.plot(x1_range, normal1, label='x1 Normal Distribution', color='blue')

# 第二条正态分布曲线
plt.plot(x2_range, normal2, label='x2 Normal Distribution', color='red')

# 添加图例
plt.legend()

# 设置标题和标签
plt.title("Gaussian Distribution of x1 and x2")
plt.xlabel("Value")
plt.ylabel("Probability Density")

# 显示图像
plt.show()
norm.pdf函数用于计算正态分布的概率密度函数,它的后两个参数就是均值和标准差,第一个参数是数据的x轴。所以我们需要使用np.linspace来创建一个数值序列作为x轴np.linspace的第一个数据是x的最小值,代表数值序列开始的值;第二个数值是x的最大值,数值序列结束的值;最后一个参数用于控制要生成的数值个数
输出图片:
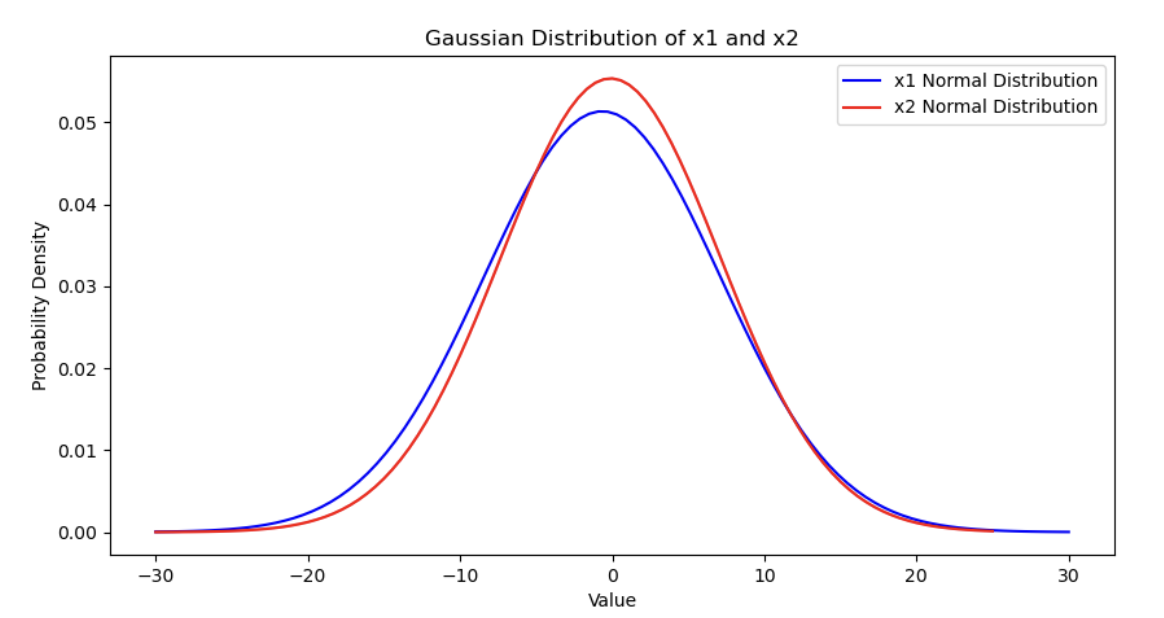
Step 4: 训练异常检测模型
我们把sklearn下异常检测的模型导入进来,然后把数据喂给它:
# 训练异常检测模型
x = data.drop('label', axis=1)
from sklearn.covariance import EllipticEnvelope
model = EllipticEnvelope()
model.fit(x)
Step 5: 可视化预测出的错误点
# 可视化异常数据
import matplotlib.pyplot as plt
plt.scatter(x['x1'], x['x2'], c=model.predict(x))
plt.show()
输出图片:
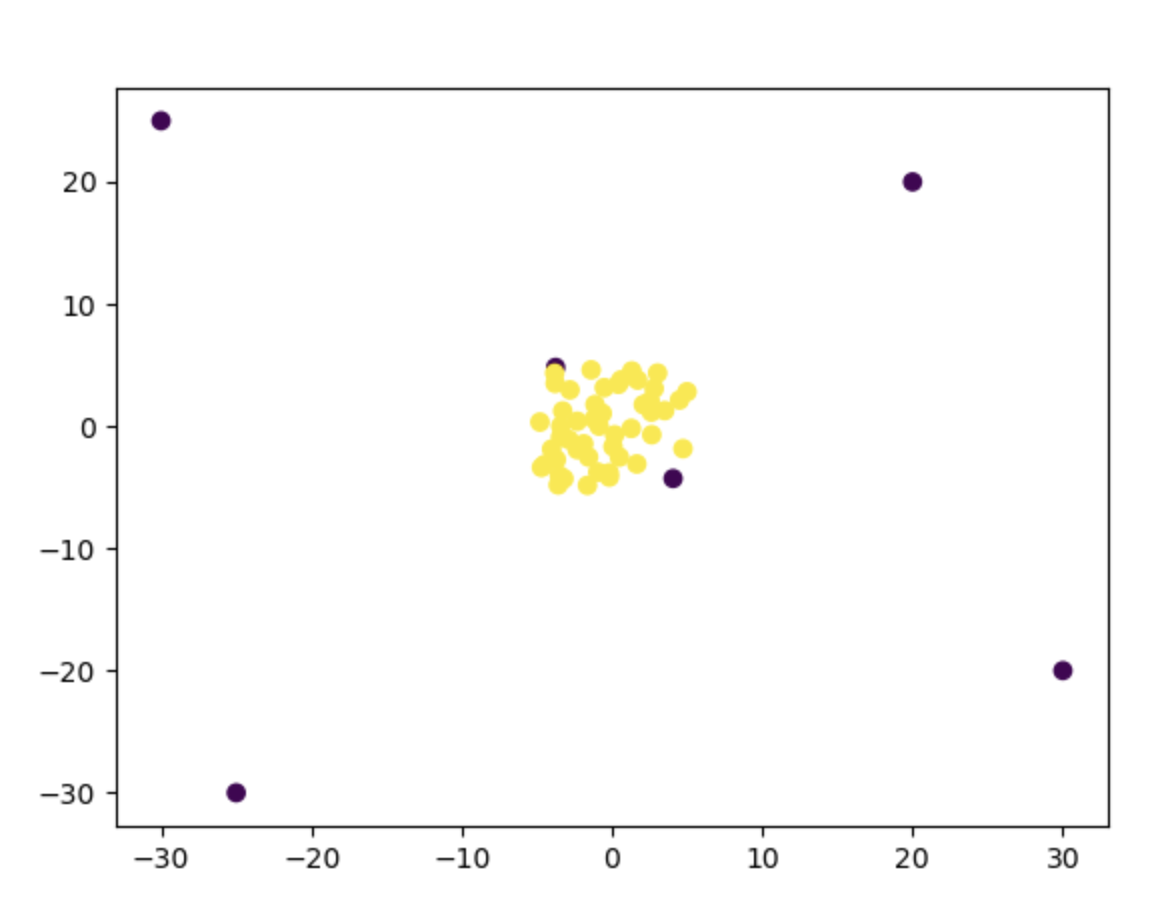
Step 6: 计算正确率
EllipticEnvelope.predict 对正常点(inlier)返回 1,对异常点(outlier)返回 -1。评分前需要把 CSV 标签映射到这一约定:
# 计算正确率
# CSV 标签:1 = 正常,0 = 异常 → sklearn:1 = inlier,-1 = outlier
y = data.loc[:, 'label'].replace({1: 1, 0: -1})
print(model.score(x, y))
若不做映射,把 predict 的结果(1/-1)直接和 CSV 标签(1/0)比较会低估正确率。映射之后,分数才反映预测的正常/异常是否与标签一致。
3.7. 主成分分析(PCA)实战
本文紧承 3.4. 主成分分析(PCA)理论, 没看过的建议先看。
3.7.1. 一些准备工作
接下来,请你确保你的Python环境中有pandas、matplotlib、scikit-learn和numpy这几个包,如果没有,请在终端输入指令以下载和安装:
pip install pandas matplotlib scikit-learn numpy
Iris数据集在scikit-learn中内置有,不需要额外安装。
3.7.2. 读取数据集
Iris数据集内置在sklearn里了,我们可以通过sklearn来引入:
# 加载Iris数据集
from sklearn import datasets
iris = datasets.load_iris()
X = iris.data  # 4维特征
y = iris.target  # 目标分类
Iris数据集在 3.5. 决策树实战 中就讲过,这里我再简单介绍一下:
这个数据集总共会有三种共150条记录,每类各50个数据。每条记录都有4项特征:
- 花萼长度(Sepal Length)
- 花萼宽度(Sepal Width)
- 花瓣长度(Petal Length)
- 花瓣宽度(Petal Width)
我们会通过花萼和花瓣的这4个特征来对花进行分类:
- iris-setosa(在数据集中的标签是0)
- iris-versicolour(在数据集中的标签是1)
- iris-virginica(在数据集中的标签是2)
以下是Iris数据集里的部分数据:
| 花萼长度 | 花萼宽度 | 花瓣长度 | 花瓣宽度 | 属种 |
|---|---|---|---|---|
| 5.1 | 3.5 | 1.4 | 0.2 | setosa |
| 4.9 | 3.0 | 1.4 | 0.2 | setosa |
| 4.7 | 3.2 | 1.3 | 0.2 | setosa |
| 4.6 | 3.1 | 1.5 | 0.2 | setosa |
| 5.0 | 3.6 | 1.4 | 0.2 | setosa |
| 5.4 | 3.9 | 1.7 | 0.4 | setosa |
| 4.6 | 3.4 | 1.4 | 0.3 | setosa |
| 5.0 | 3.4 | 1.5 | 0.2 | setosa |
3.7.3. 数据标准化
我先把主成分分析的所有步骤都粘在这里:
- 原始数据预处理:也就是标准化,因为不同维度的量纲不一定一样。我们先把数据进行一次变换,保证均值$\mu = 0$, 标准差$\sigma = 1$
- 计算协方差矩阵特征向量、及数据在各特征向量投影后的方差
- 按投影方差(特征值)对主成分方向排序:保留方差最大的$k$个方向,丢弃低方差方向(信息较少),最后降到$k$维
- 选取这$k$维特征向量,计算数据在其形成空间的投影
首先就进行标准化,库提供了fit_transform函数来处理:
# 数据标准化
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
3.7.4. 数据降维
然后我们通过:
# 进行PCA降维到2维
from sklearn.decomposition import PCA
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X_scaled)
n_components的值可以控制降维后的维度数量.fit_transform方法可以进行降维
3.7.5. 降维之后的数据可视化
使用matplotlib进行数据可视化:
# 可视化降维后的数据
import matplotlib.pyplot as plt
plt.figure(figsize=(8, 6))
colors = ['red', 'green', 'blue']
labels = iris.target_names
for i in range(len(colors)):
    plt.scatter(X_pca[y == i, 0], X_pca[y == i, 1], color=colors[i], label=labels[i], alpha=0.7, edgecolors='k')

plt.xlabel('Principal Component 1')
plt.ylabel('Principal Component 2')
plt.title('PCA of Iris Dataset')
plt.legend()
plt.grid()
plt.show()
图片输出:
从这幅图中可以看出,降维之后的数据仍保持清晰结构,不同标签的散点还是能够大概分开的。
3.7.6. 组合变量的查看
刚刚表格的两个轴就被替换为了两个组合变量,那我们如何确定是哪两个因子合成了一个轴呢?我们可以查看主成分载荷(Principal Component Loadings),即PCA的特征向量(Components)。这些载荷表示每个原始特征在主成分上的贡献。
在sklearn中,可以使用pca.components_属性获取:
import pandas as pd

# 获取主成分载荷矩阵
loadings = pca.components_

# 创建一个DataFrame,查看每个原始特征在新主成分上的权重
feature_names = iris.feature_names
pc_loadings = pd.DataFrame(loadings, columns=feature_names, index=['PC1', 'PC2'])

print("Principal Component Loadings:")
print(pc_loadings)
输出:
Principal Component Loadings:
     sepal length (cm)  sepal width (cm)  petal length (cm)  petal width (cm)
PC1           0.521066         -0.269347           0.580413          0.564857
PC2           0.377418          0.923296           0.024492          0.066942
- 每一行(PC1, PC2)对应一个主成分
- 每一列(原始特征)表示该特征在主成分上的贡献系数
- 数值的绝对值越大,表示该特征对该主成分的贡献越大
- 正负号表示该特征在该主成分上的方向(正相关或负相关)
据此可以解读出:
- 第一主成分 (PC1)主要由petal length (0.580) 和petal width (0.564) 决定,因为两者对于PC1的贡献最大
- 第二主成分 (PC2)sepal width (0.923) 对 PC2 贡献最大,远高于其他特征。sepal length (0.377) 也有一定贡献,但远不及sepal width。
3.7.7. 降维损失分析
解释方差(Explained Variance)
PCA的每个主成分都保留了数据的一部分方差信息。可以查看解释方差比例(explained variance ratio) 来评估降维损失:
import numpy as np

explained_variance_ratio = pca.explained_variance_ratio_
print("Explained variance ratio:", explained_variance_ratio)
print("Total variance retained:", np.sum(explained_variance_ratio))
explained_variance_ratio_表示每个主成分解释的方差比例np.sum(explained_variance_ratio_)表示保留的总方差比例,越接近 1,说明损失越小
输出:
Explained variance ratio: [0.72962445 0.22850762]
Total variance retained: 0.9581320720000165
重构误差(Reconstruction Error)
PCA进行降维后,可以将数据从低维空间逆变换(inverse_transform) 回原始空间,然后计算均方误差(MSE) 以评估损失:
X_reconstructed = pca.inverse_transform(X_pca)  # 逆变换回原始空间
reconstruction_error = np.mean((X_scaled - X_reconstructed) ** 2)
print("Reconstruction Error (MSE):", reconstruction_error)
- 误差越小,说明降维保留的信息越多
输出:
Reconstruction Error (MSE): 0.0418679279999836
4.1. 过拟合(overfitting)与欠拟合(underfitting)
4.1.1. 什么是过拟合、欠拟合
举个例子:
我们获得了某个地区在某段时间下的温度数据,但是不是连续的,而是散点的形式。我们的目标是通过这些散点来找到这段时间内的温度变化曲线
.png)
- 左图能够大致表现出温度变化的趋势,但是与散点数据的偏差很大,就是欠拟合
- 中间的图能够很好的表现出温度变化的过程,并且与散点数据的偏差不大,这是理想的拟合
- 右图拟合出的曲线与散点数据的偏差值最小,但是起伏、斜率和波动很多,这在正常的气候变化中是不可能发生的,这条曲线也因此失去了通用性,这就是过拟合。
4.1.2. 过拟合和欠拟合的本质
其本质是模型不合适,导致其无法对数据实现有效的预测。
具体来说:
| 训练数据 | 预测数据 | |
|---|---|---|
| 欠拟合 | 不准确 | 不准确 |
| 过拟合 | 准确 | 不准确 |
| 好模型 | 准确 | 准确 |
欠拟合不论是训练数据还是预测出的数据都不准确;好模型就是都准确;过拟合会让训练数据的正确率大于等于好模型,造成过拟合的结果更好的假象,但是一旦用过拟合的模型去预测数据准确率就会低下,因为过拟合的模型失去了通用性。
欠拟合非常好判断,但是过拟合不容易判断,这篇文章的重点就在于解决过拟合问题。
4.1.3. 过拟合出现的原因和解决方案
原因:
- 模型结构过于复杂(维度过高)
- 使用了过多的属性,训练数据包含了干扰项信息
解决方案:
- 简化模型结构(使用低阶模型,比如线性模型,但也不要低到欠拟合)
- 对数据进行预处理,保留主成分信息(PCA降维)
- 在训练模型时,增加正则化项(regularization)
前面两个解决方案都在之前的文章中介绍过了,我们着重介绍正则化项。
4.1.4. 正则化项
我们先回忆一下在线性回归理论中提到的计算损失的均方误差(Mean Squared Error, MSE)代价函数: $$ J = \frac{1}{2m} \sum_{i=1}^{m} (y’i - y_i)^2 = \frac{1}{2m} \sum{i=1}^{m} (a x_i + b - y_i)^2 $$ 我们要做的就是为它增加正则化处理项: $$ J = \frac{1}{2m} \sum_{i=1}^{m} (g(\theta, x_i) - y_i)^2 + \frac{\lambda}{2m} \sum_{j=1}^{n} \theta_j^2 $$ 在$\lambda$足够大的情况下,可以约束$\theta$的取值,由此有效控制各个属性数据的影响。
下图展示了在不同$\lambda$数值下$\theta$对结果的影响:

可以看到$\lambda$越大$\theta$的影响值越小,越趋近0。
4.2. 数据分离与混淆矩阵
4.2.1. 数据分离
我们在上一篇文章讲到了过拟合的问题——过拟合能使训练数据的准确率更高,但是却失去了通用性,这也就回归到了机器学习的本质:
机器学习的本质是用训练数据来更好地预测新数据,而不是保证训练数据的准确性尽可能高。
那如果我没有新数据呢?这时候就得从训练数据里剥离出一部分作为测试数据。这就是数据分离。
具体来说分为以下几步:
- 把数据分为训练集(一般来说70%)和测试集(一般来说30%)
- 使用训练集进行模型训练
- 使用测试集进行预测,评估表现
举个例子,假如我们有以下数据:
| 特征1 | 特征2 | 结果 |
|---|---|---|
| 1 | 2 | 2 |
| 3 | 4 | 12 |
| 5 | 6 | 30 |
| 7 | 8 | 56 |
| 9 | 10 | 90 |
大致分成:
| 数据类型 | 特征1 | 特征2 | 结果 |
|---|---|---|---|
| 训练数据 | 1 | 2 | 2 |
| 训练数据 | 3 | 4 | 12 |
| 训练数据 | 7 | 8 | 56 |
| 测试数据 | 5 | 6 | 30 |
| 测试数据 | 9 | 10 | 90 |
其实我们在 3.5. 决策树实战 中提到过数据分离的方法:
# 划分测试集和训练集
from sklearn.model_selection import train_test_split
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2)
train_test_split函数可以让我们轻易地拆分数据test_size=0.2告诉程序80%数据用于训练,20%用于测试- 其实
train_test_split还有一个参数是random_state,输入不同的取值即可对数据进行不同的随机划分
4.2.2. 混淆矩阵(Confusion Matrix)
使用准确率评估模型的缺点
我们先来看看使用准确率来评估模型的例子:
假如说有1000个数据,其中900个是1,100个是0。然后这里有两个模型的预测结果:
- 模型1:850个1,150个0,准确率90%
- 模型2:所有结果都是1(1000个1),准确率90%
模型1和2有相同的准确率,但是明显模型2的预测是无效的,我们把这种称为准确率悖论(accuracy paradox)。
准确率可以方便的用于衡量模型的整体预测效果,但无法反应细节信息,具体表现在:
- 没有体现数据预测的实际分布情况(0、1本身的分布比例)
- 没有体现模型错误预测的类型
混淆矩阵的定义
混淆矩阵,又称为误差矩阵,用于衡量分类算法的准确程度。
| 实际\预测 | 0 | 1 |
|---|---|---|
| 0 | True Negative (TN) | False Positive (FP) |
| 1 | False Negative (FN) | True Positive (TP) |
- True Positives (TP):预测准确、实际为正样本的数量(实际为1,预测为1)
- True Negatives (TN):预测准确、实际为负样本的数量(实际为0,预测为0)
- False Positives (FP):预测错误、实际为负样本的数量(实际为0,预测为1)
- False Negatives (FN):预测错误、实际为正样本的数量(实际为1,预测为0)
通过混淆矩阵,我们可以计算更多的指标来评估模型:
| 指标 | 公式 | 定义 |
|---|---|---|
| 准确率 (Accuracy) | $\frac{TP + TN}{TP + TN + FP + FN}$ | 总样本中,预测正确的比例 |
| 误差率 (Misclassification Rate) | $\frac{FP + FN}{TP + TN + FP + FN}$ | 总样本中,预测错误的比例 |
| 召回率 (Recall) | $\frac{TP}{TP + FN}$ | 正样本中,预测正确的比例 |
| 特异度 (Specificity) | $\frac{TN}{TN + FP}$ | 负样本中,预测正确的比例 |
| 精确率 (Precision) | $\frac{TP}{TP + FP}$ | 预测结果为正的样本中,预测正确的比例 |
| F1 分数 (F1 Score) | $\frac{2 \times Precision \times Recall}{Precision + Recall}$ | 综合 Precision 和 Recall 的指标 |
混淆矩阵的优点
- 分类任务中,相比单一的预测准确率,混淆矩阵提供了更全面的模型评估信息(TP\TN\FP\FN)
- 通过混淆矩阵,我们可以计算出多样的模型表现衡量指标,从而更好地选择模型
哪个指标更关键?
衡量指标的选择取决于应用场景:
- 垃圾邮件检测(正样本为“垃圾邮件“):希望普通邮件(负样本)不要被判断为垃圾邮件(正样本),即:判断为垃圾邮件的样本都是判断正确的,需要关注精确率;还希望所有的垃圾邮件尽可能被判断出来,需要关注召回率。
- 异常交易检测(正样本为“异常交易”):希望异常交易尽可能都被找出来,避免漏检,需要关注召回率。
混淆矩阵代码
sklearn中提供了confusion_matrix来进行混淆矩阵的计算:
from sklearn.metrics import confusion_matrix
cm = confusion_matrix(y_test, y_test_predict)
TP = cm[1,1]
TN = cm[0,0]
FP = cm[0,1]
FN = cm[1,0]
TP指True Positive:预测准确、实际为正样本的数量(实际为1,预测为1)TN指True Negative:预测准确、实际为负样本的数量(实际为0,预测为0)FP指False Positive:预测错误、实际为负样本的数量(实际为0,预测为1)FN指False Negative:预测错误、实际为正样本的数量(实际为1,预测为0)
除此之外,我们还可以计算基于混淆矩阵的各项指标:
recall = TP / (TP + FN)
specificity = TN / (TN + FP)
precision = TP / (TP + FP)
f1 = 2 * precision * recall / (precision + recall)
recall是召回率:正样本中,预测正确的比例specificity是特异度:负样本中,预测正确的比例precision是精确率:预测结果为正的样本中,预测正确的比例f1是F1分数:综合 Precision 和 Recall 的指标
4.3. 模型优化
4.3.1. 实战中会遇到的问题
首先看一个例子:
根据检测数据$x_1$、$x_2$及其标签,判断$x_1 = 6$,$x_2 = 4$时所属的类别。
图像如下:
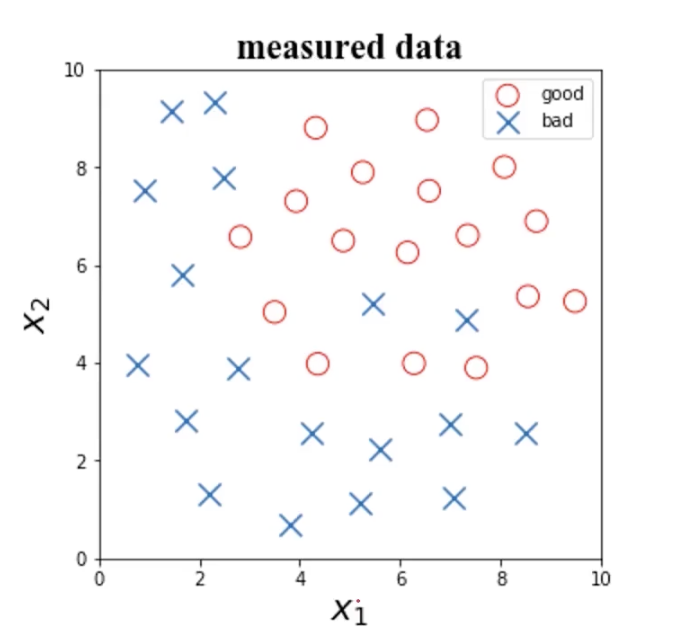
我们接下来就需要选择算法了,可选择的有:
- 逻辑回归(详见 1.6. 逻辑回归理论)
- KNN(详见 2.2. 聚类分析算法理论)
- 决策树(详见 3.1. 决策树理论)
- 神经网络(之后会讲)
选择完算法之后我们还会遇到一个问题:具体算法的核心结构/参数如何选择?
- 如果选择逻辑回归:边界函数用什么?用线性函数还是多项式?
- 如果选择KNN:核心参数
n_neighbors(指定的K值)取多少合适? - …
最后,如果模型表现不佳,具体表现为
- 训练数据准确率太低(欠拟合)
- 测试数据准确率下降明显(过拟合)
- 召回率/特异度/精确率低
这种情况下我该怎么办呢?
这些情况汇总下来就是一个问题:如何提高模型表现?
4.3.2. 数据决定上限
数据的质量决定了模型表现的上限。就算你用再强的模型/参数,只要你的数据质量差效果就好不起来。
建议在建模之前先检查数据的以下方面:
- 数据属性的意义,是否为无关数据
- 不同属性数据的数量级差异性如何
- 是否有异常数据
- 采集数据的方法是否合理,采集的数据是否有代表性
- 对于标签结果,要确保标签判定规则的一致性(统一标准)
| 对数据进行的操作 | 好处 |
|---|---|
| 删除不必要的属性 | 防止过拟合,节约运算时间 |
| 数据预处理:归一化、标准化 | 平衡数据影响,加快训练收敛 |
| 确定是否保留或过滤掉异常数据 | 提高实用性 |
| 尝试不同的模型,对比模型表现 | 帮助确定更合适的模型 |
以上文的例子来说,在我们获得数据之后,我们要考虑以下问题:
- 是否有需要剔除的异常数据?
- 数据量级差异如何?
- 是否需要降低数据维度?
对于检查异常数据这一部分,我们学过异常检测(详见 3.3. 异常检测(Anomaly Detection)理论),通过概率密度函数来找潜在的数据异常点。
对于数据量级差异的部分,我们要先看数据的分布,$x_1$的数据分布在0.77~9.49,$x_2$的数据分布在0.69~9.5。这两个变量的数据分布基本相同,可以不做归一化处理。
对于确认是否需要降低数据维度的部分,我们需要先对数据进行主成分分析(详见 3.4. 主成分分析(PCA)理论)。由于例子中的数据只有2个维度,所以就不需要进行主成分分析来降维了,具体的操作见 3.7. 主成分分析(PCA)实战。
4.3.3. 尝试不同的模型
不同的模型通常会有不同的效果,你可以计算准确率并可视化出来,这里的数据使用的是 1.9. 逻辑回归实战 中的,我把.csv数据文件放在GitCode上了,点击链接即可下载。
.png)
你也可以通过混淆矩阵来计算其它参数,根据其他指数来决定要使用哪个模型。衡量指标的选择取决于应用场景:
- 垃圾邮件检测(正样本为“垃圾邮件“):希望普通邮件(负样本)不要被判断为垃圾邮件(正样本),即:判断为垃圾邮件的样本都是判断正确的,需要关注精确率;还希望所有的垃圾邮件尽可能被判断出来,需要关注召回率。
- 异常交易检测(正样本为“异常交易”):希望异常交易尽可能都被找出来,避免漏检,需要关注召回率。
4.3.4. 其他调整
在确定了该使用什么模型之后,我们还需要对其他方面进行微调:
- 遍历核心参数组合,评估对应模型表现(比如:逻辑回归边界函数考虑多项式、KNN尝试不同的
n_neighbors值) - 扩大数据样本
- 增加或减少数据属性
- 对数据进行降维处理(主成分分析PCA)
- 对模型进行正则化处理,调整正则项$\lambda$的数值(详见 4.1. 过拟合(overfitting)与欠拟合(underfitting) )
来看看KNN的n_neighbors值对结果的影响:
.png)