4.1. 过拟合(overfitting)与欠拟合(underfitting)
4.1.1. 什么是过拟合、欠拟合
举个例子:
我们获得了某个地区在某段时间下的温度数据,但是不是连续的,而是散点的形式。我们的目标是通过这些散点来找到这段时间内的温度变化曲线
.png)
- 左图能够大致表现出温度变化的趋势,但是与散点数据的偏差很大,就是欠拟合
- 中间的图能够很好的表现出温度变化的过程,并且与散点数据的偏差不大,这是理想的拟合
- 右图拟合出的曲线与散点数据的偏差值最小,但是起伏、斜率和波动很多,这在正常的气候变化中是不可能发生的,这条曲线也因此失去了通用性,这就是过拟合。
4.1.2. 过拟合和欠拟合的本质
其本质是模型不合适,导致其无法对数据实现有效的预测。
具体来说:
| 训练数据 | 预测数据 | |
|---|---|---|
| 欠拟合 | 不准确 | 不准确 |
| 过拟合 | 准确 | 不准确 |
| 好模型 | 准确 | 准确 |
欠拟合不论是训练数据还是预测出的数据都不准确;好模型就是都准确;过拟合会让训练数据的正确率大于等于好模型,造成过拟合的结果更好的假象,但是一旦用过拟合的模型去预测数据准确率就会低下,因为过拟合的模型失去了通用性。
欠拟合非常好判断,但是过拟合不容易判断,这篇文章的重点就在于解决过拟合问题。
4.1.3. 过拟合出现的原因和解决方案
原因:
- 模型结构过于复杂(维度过高)
- 使用了过多的属性,训练数据包含了干扰项信息
解决方案:
- 简化模型结构(使用低阶模型,比如线性模型,但也不要低到欠拟合)
- 对数据进行预处理,保留主成分信息(PCA降维)
- 在训练模型时,增加正则化项(regularization)
前面两个解决方案都在之前的文章中介绍过了,我们着重介绍正则化项。
4.1.4. 正则化项
我们先回忆一下在线性回归理论中提到的计算损失的均方误差(Mean Squared Error, MSE)代价函数: $$ J = \frac{1}{2m} \sum_{i=1}^{m} (y’i - y_i)^2 = \frac{1}{2m} \sum{i=1}^{m} (a x_i + b - y_i)^2 $$ 我们要做的就是为它增加正则化处理项: $$ J = \frac{1}{2m} \sum_{i=1}^{m} (g(\theta, x_i) - y_i)^2 + \frac{\lambda}{2m} \sum_{j=1}^{n} \theta_j^2 $$ 在$\lambda$足够大的情况下,可以约束$\theta$的取值,由此有效控制各个属性数据的影响。
下图展示了在不同$\lambda$数值下$\theta$对结果的影响:
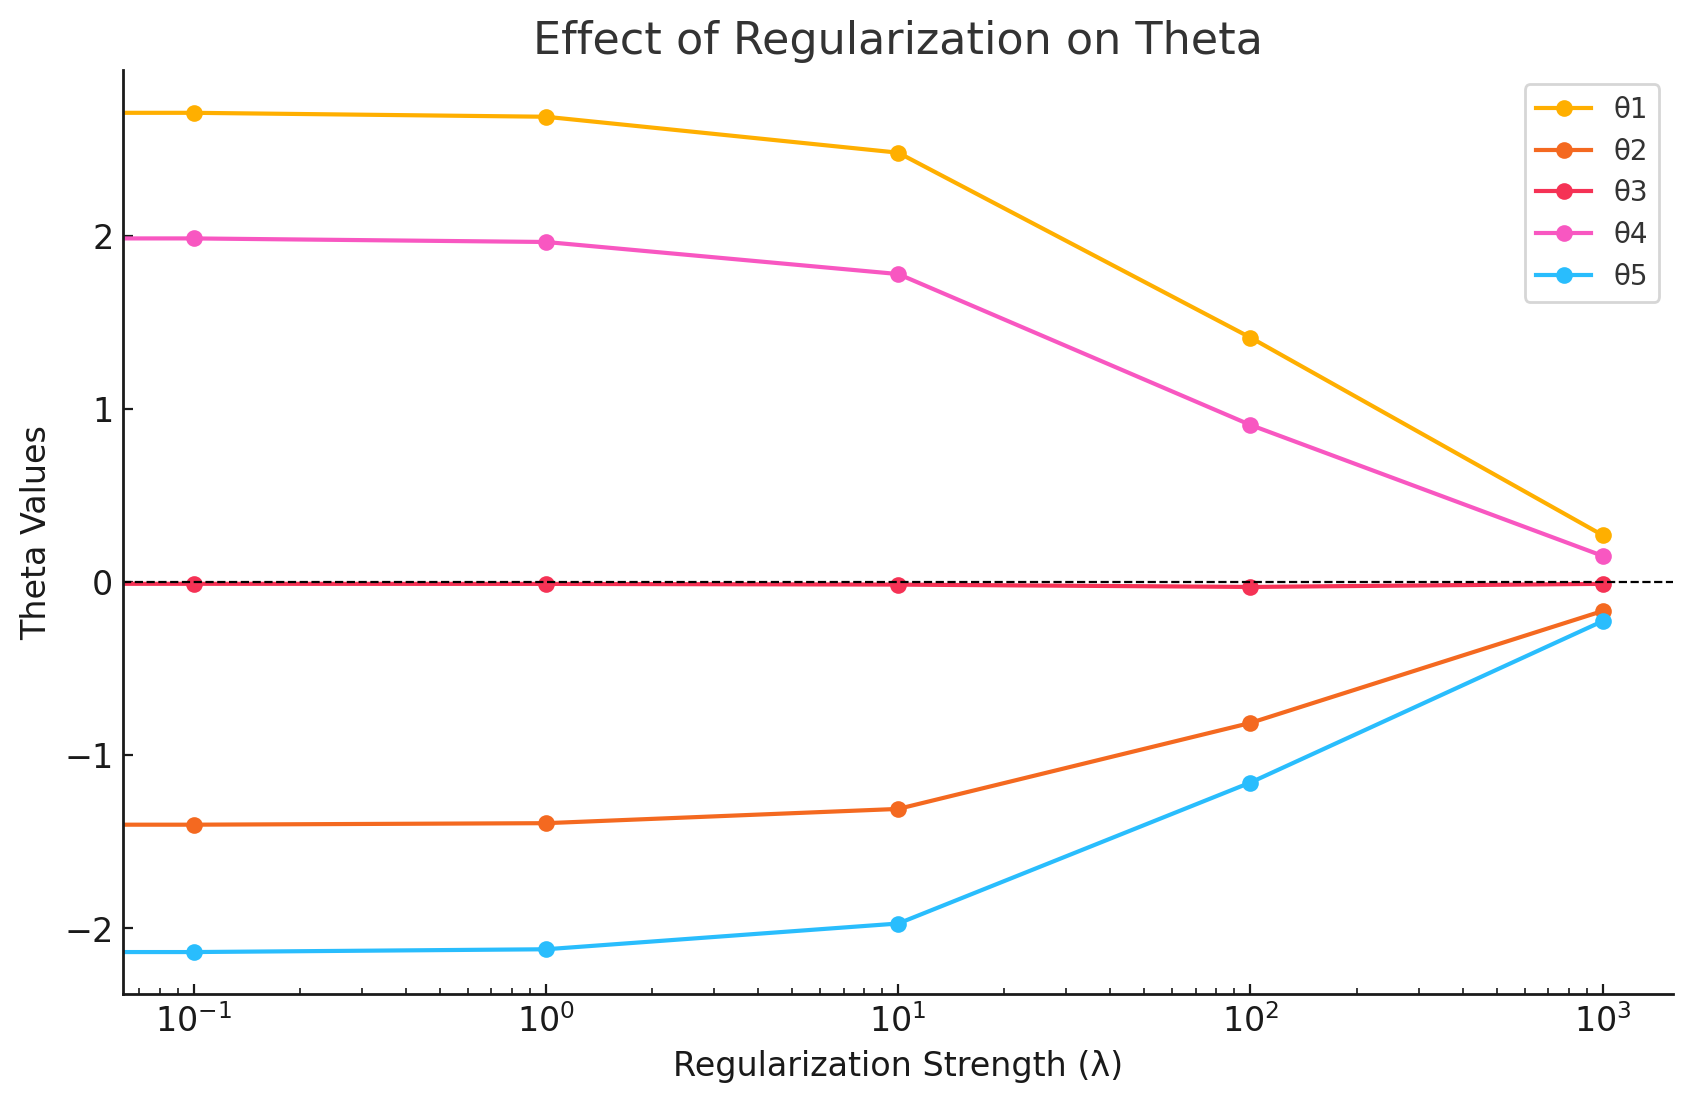
可以看到$\lambda$越大$\theta$的影响值越小,越趋近0。