3.6. 异常检测实战
本文紧承 3.3. 异常检测(Anomaly Detection)理论,没看过的建议先看理论分析。
3.6.1. 实战前的准备工作
接下来,请你确保你的Python环境中有pandas、matplotlib、scikit-learn和numpy这几个包,如果没有,请在终端输入指令以下载和安装:
pip install pandas matplotlib scikit-learn numpy scipy
我把数据放到了GitCode上,可以点击链接去下载和查看。文件一共有3栏:x1, x2和label,x1和x2是输入变量,label是标签,要么是0要么是1。如果是正常点就是1,否则就是0。
下载下来后把这个文件放到你的Python项目文件夹里即可。
3.6.2. 建立异常检测数据模型
Step 1: 读取数据
使用pandas库来读取.csv文件:
# 导入数据
import pandas as pd
data = pd.read_csv('error_detection_data.csv')

print(data.head())
输出:
         x1        x2  label
0 -1.630353 -4.839381      1
1  4.995439  2.821713      1
2 -0.942488 -3.756172      1
3 -2.795116  2.975474      1
4  2.624829  1.159119      1
Step 2: 输入数据可视化
我们使用matplotlib来对输入的数据进行可视化:
# 可视化数据
x1 = data.loc[:, 'x1']
x2 = data.loc[:, 'x2']
y = data.loc[:, 'label']


import matplotlib.pyplot as plt
plt.scatter(x1, x2, c=y)
plt.show()
输出图片:
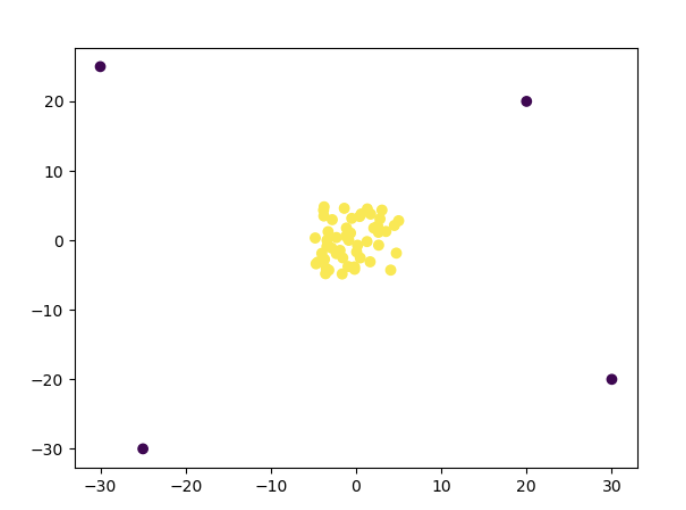
可以很明显地看到,四角各有一个错误点。
不止如此,我们还可以使用hist方法来画数据的分布情况:
plt.hist(x1, bins=100, color='red')
plt.hist(x2, bins=100, color='blue')
plt.show()
bins这个参数用于控制生成的图有多少个区间,我填的100就会生成100个区间
输出图片:
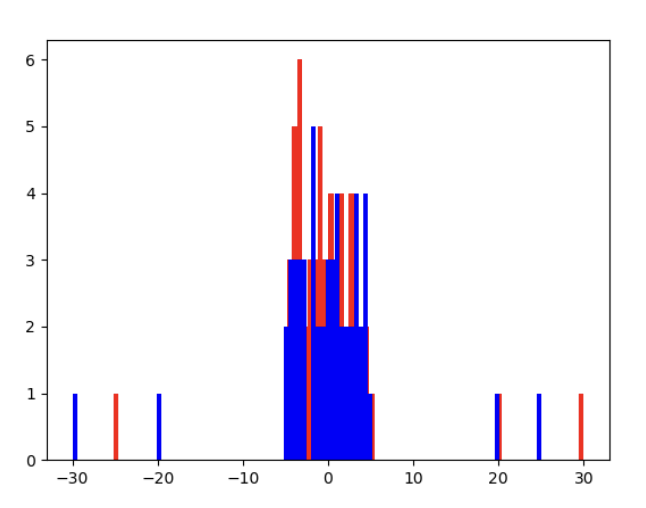
- 红色是
x1 - 蓝色是
x2
Step 3: 概率密度函数计算
为了查找异常点,我们得计算正态分布的概率密度函数。正态分布的公式是: $$ p(x) = \frac{1}{\sigma \sqrt{2\pi}} e^{-\frac{(x - \mu)^2}{2\sigma^2}} $$ 其中的参数只有两个:
- $\mu$(均值,Mean):决定正态分布的中心位置,表示数据的平均值
- $\sigma$(标准差,Standard Deviation):衡量数据的离散程度,决定正态分布的宽度,值越大,曲线越平缓;值越小,曲线越陡峭
我们得先计算这两个参数。幸运的是Python提供了函数,不需要我们手动写代码:
# 计算数据均值和标准差
x1_mean = x1.mean()
x2_mean = x2.mean()
x1_std = x1.std()
x2_std = x2.std()
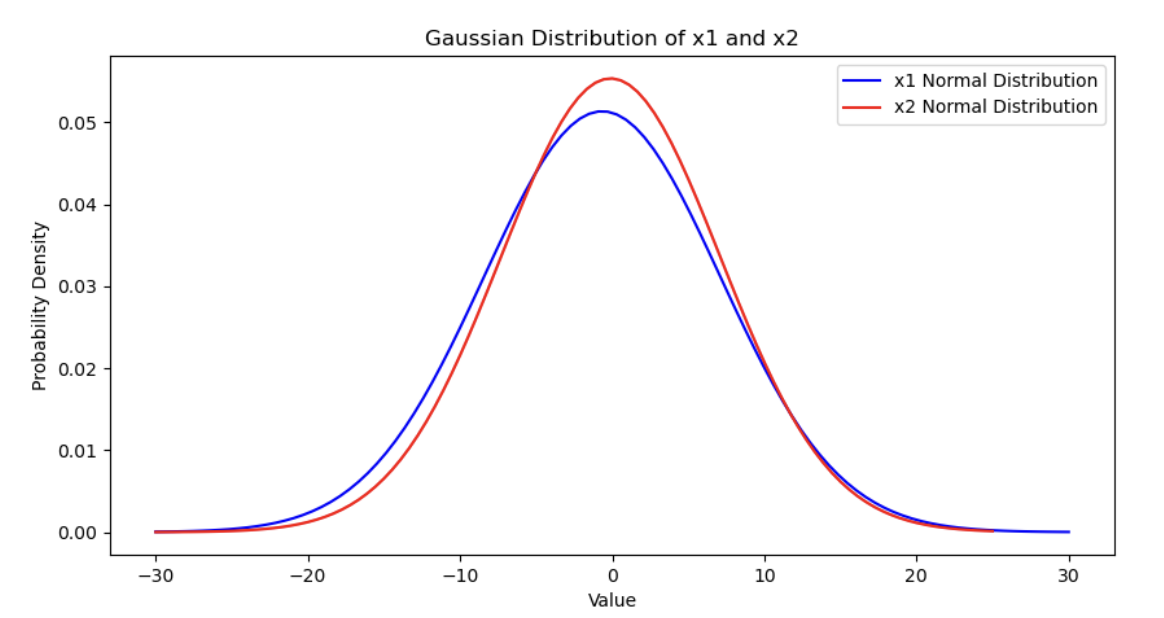
然后使用scipy下的norm模块来计算高斯分布并用matplotlib画出来:
# 画正态分布
from scipy.stats import norm
import numpy as np
x1_range = np.linspace(x1.min(), x1.max(), 100)
normal1 = norm.pdf(x1_range, x1_mean, x1_std)
x2_range = np.linspace(x2.min(), x2.max(), 100)
normal2 = norm.pdf(x2_range, x2_mean, x2_std)

import matplotlib.pyplot as plt

# 绘制正态分布曲线
plt.figure(figsize=(10, 5))

# 第一条正态分布曲线
plt.plot(x1_range, normal1, label='x1 Normal Distribution', color='blue')

# 第二条正态分布曲线
plt.plot(x2_range, normal2, label='x2 Normal Distribution', color='red')

# 添加图例
plt.legend()

# 设置标题和标签
plt.title("Gaussian Distribution of x1 and x2")
plt.xlabel("Value")
plt.ylabel("Probability Density")

# 显示图像
plt.show()
norm.pdf函数用于计算正态分布的概率密度函数,它的后两个参数就是均值和标准差,第一个参数是数据的x轴。所以我们需要使用np.linspace来创建一个数值序列作为x轴np.linspace的第一个数据是x的最小值,代表数值序列开始的值;第二个数值是x的最大值,数值序列结束的值;最后一个参数用于控制要生成的数值个数
输出图片:
Step 4: 训练异常检测模型
我们把sklearn下异常检测的模型导入进来,然后把数据喂给它:
# 训练异常检测模型
x = data.drop('label', axis=1)
from sklearn.covariance import EllipticEnvelope
model = EllipticEnvelope()
model.fit(x)
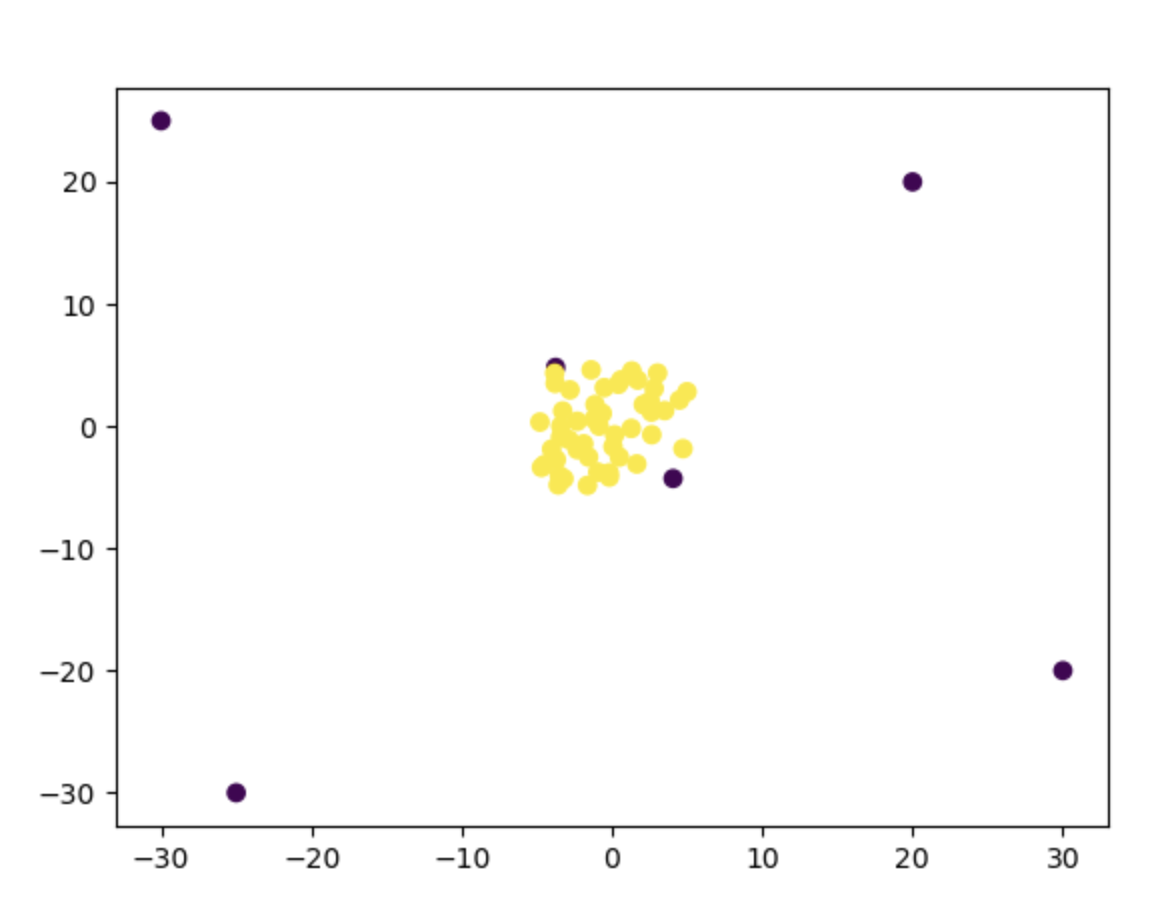
Step 5: 可视化预测出的错误点
# 可视化异常数据
import matplotlib.pyplot as plt
plt.scatter(x['x1'], x['x2'], c=model.predict(x))
plt.show()
输出图片:
Step 6: 计算正确率
EllipticEnvelope.predict 对正常点(inlier)返回 1,对异常点(outlier)返回 -1。评分前需要把 CSV 标签映射到这一约定:
# 计算正确率
# CSV 标签:1 = 正常,0 = 异常 → sklearn:1 = inlier,-1 = outlier
y = data.loc[:, 'label'].replace({1: 1, 0: -1})
print(model.score(x, y))
若不做映射,把 predict 的结果(1/-1)直接和 CSV 标签(1/0)比较会低估正确率。映射之后,分数才反映预测的正常/异常是否与标签一致。