1.3. 线性回归实战(基础)
1.3.1. Scikit-learn
Scikit-learn是Python语言中专门针对机器学习应用而发展出的开源框架(算法库)。同个这个算法库我们可以实现数据预处理、分类、回归、降维、模型选择等常用的机器学习算法。
有了这个模型,能将我们上一篇文章 1.2. 线性回归理论 中所讲的线性回归理论压缩到不到5行的代码量。你看过上文的数学阐述有多长就知道实现这点有多不容易了。
它的特点就是集成了机器学习中各类成熟的算法,容易安装和使用,样例丰富,教程和文档也很详细。
它的缺点是不支持Python以外的语言,不支持深度学习和强化学习。
1.3.2. 安装Scikit-learn
在MacOS上,打开终端;在Windows上,打开Anaconda Prompt或者Anaconda Powershell Prompt(注意:如果你把Anaconda下载在C盘那就得以管理员身份打开,不然有可能在后续的操作中报错)。输入如下指令:
pip install scikit-learn
1.3.2. 调用Scikit-learn求解线性回归问题
在上一篇文章 1.2. 线性回归理论 中我们就详细阐述过了线性回归问题的核心思路——寻找y = ax + b中的两个参数a和b。
这里我给大家提供一些数据:
x,y
0,3.4941499975136017
1,3.2195777812087623
2,7.020239126724705
3,10.561179685791949
4,11.829186585662265
5,11.75496874167899
6,16.58341895848982
7,17.851195579820043
8,18.938095976526668
9,20.573327586269645
10,21.402583214283524
11,25.383074825333473
12,26.80228829909171
13,29.477295234061874
14,31.491963327709488
15,33.52264335242398
16,32.243263034545826
17,37.49084903752127
18,39.72984009710374
19,40.75882117159081
把这些复制到一个.csv文件中,命名为data,然后放到Python项目的文件夹里即可
接下来,在这个Python项目的main.py中这么写(确保你已经安装好了pandas库,0.2. 下载、安装和试运行需要的包 中有教程):
import pandas as pd
from sklearn.linear_model import LinearRegression

# 读取数据
data = pd.read_csv('data.csv')
x = data.loc[:, ['x']]
y = data.loc[:, ['y']]

# 训练线性回归模型
Ir_model = LinearRegression()
Ir_model.fit(x, y)

# 获取回归系数和截距
a = Ir_model.coef_[0][0]  # 提取数值
b = Ir_model.intercept_[0]  # 提取数值
print('a = ', a)
print('b = ', b)
-
pd.read_csv('data.csv')读取data.csv文件,将其存储在类型为DataFrame的变量data中 -
x = data.loc[:, ['x']]取出x列,并保持其为 二维数组(DataFrame类型),因为scikit-learn要求输入X是二维结构 -
y = data.loc[:, ['y']]取出 y 列,作为目标变量(也是二维) -
Ir_model = LinearRegression()创建线性回归模型 -
Ir_model.fit(x, y):使用x和y这两个变量里的内容训练模型,让它找到最优的回归系数(coef_)和截距(intercept_) -
a = Ir_model.coef_[0][0]:Ir_model.coef_返回系数矩阵,因为scikit-learn允许多元回归(多个特征),但我们这里的数据拟合出来的线只有一元一次,也就是只会有一个系数,处于系数矩阵的[0][0]。我们这里用[0][0]取出具体数值(如果是多元回归,coef_会是一个数组) -
b = Ir_model.intercept_[0]:Ir_model.intercept_返回截距,因为scikit-learn允许多元回归(多个特征),所以截距的结果会存储在一个数组里。我们这里的数据是线性回归的,只有一元一次,也就是只会有一个截距,处于系数矩阵的[0]。同样用[0]提取具体数值。
输出:
a =  1.984261059610437
b =  3.155918014368453
我们还可以通过predict方法来看拟合出的曲线每个x点对应的y值:
# 预测
predictions = Ir_model.predict(x)
print(predictions)
输出:
[[ 3.15591801]
 [ 5.14017907]
 [ 7.12444013]
 [ 9.10870119]
 [11.09296225]
 [13.07722331]
 [15.06148437]
 [17.04574543]
 [19.03000649]
 [21.01426755]
 [22.99852861]
 [24.98278967]
 [26.96705073]
 [28.95131179]
 [30.93557285]
 [32.91983391]
 [34.90409497]
 [36.88835603]
 [38.87261709]
 [40.85687815]]
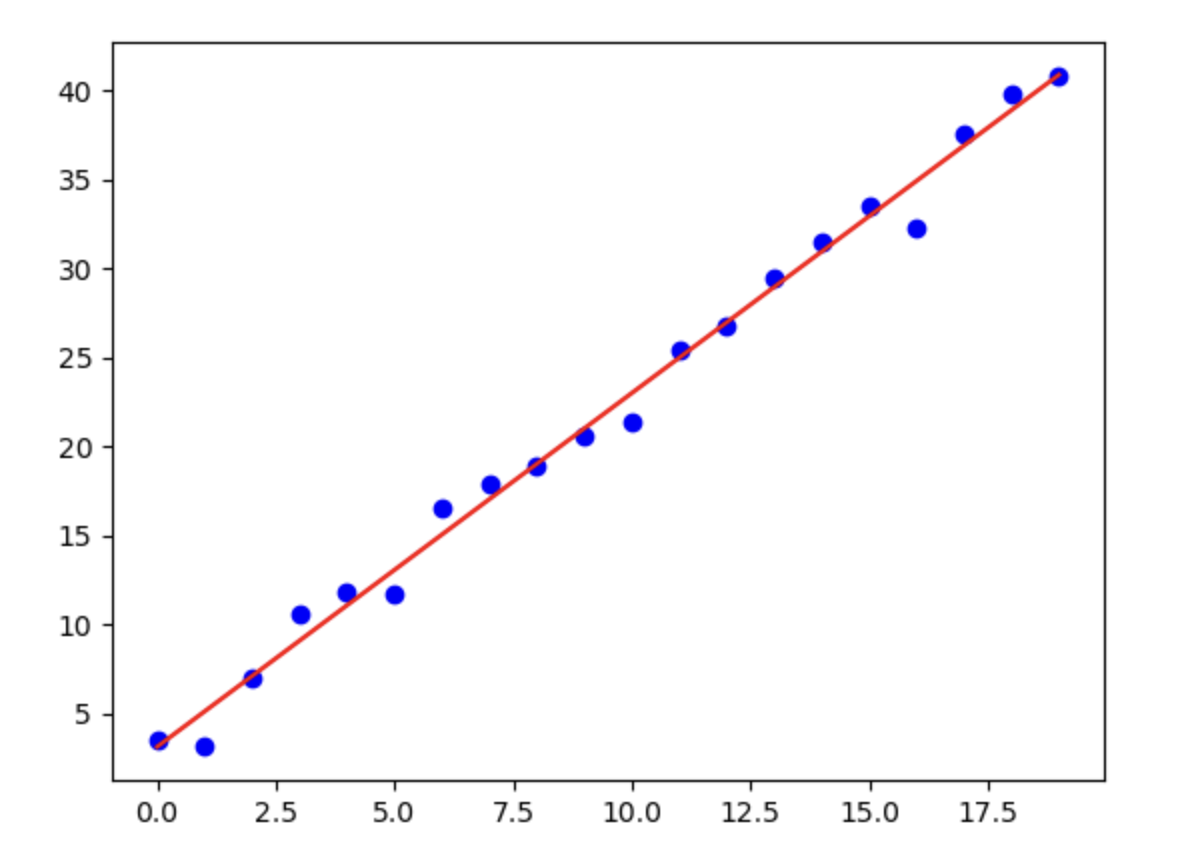
最后我们再用matplotlib对数据进行可视化:
import matplotlib.pyplot as plt

# ...中间的内容已省略

# 绘制散点图
plt.scatter(x, y, color='blue', label='数据点')

# 绘制回归直线
x_line = x.sort_values(by='x')  # 确保 x 排序
y_line = a * x_line + b  # 根据模型计算
plt.plot(x_line, y_line, color='red', label=f'回归线: y = {a:.2f}x + {b:.2f}')
plt.show()
生成的图长这样: