1.1. 多层感知器MLP(人工神经网络)介绍
1.1.1. 为什么需要多层感知器
我们之前学过很多机器学习的算法,为什么还要学这个多层感知器呢?
看个例子:
根据检测数据$x_1$、$x_2$及其标签,判断$x_1 = 0.7$、$x_2 = 0.6$时所属的类别
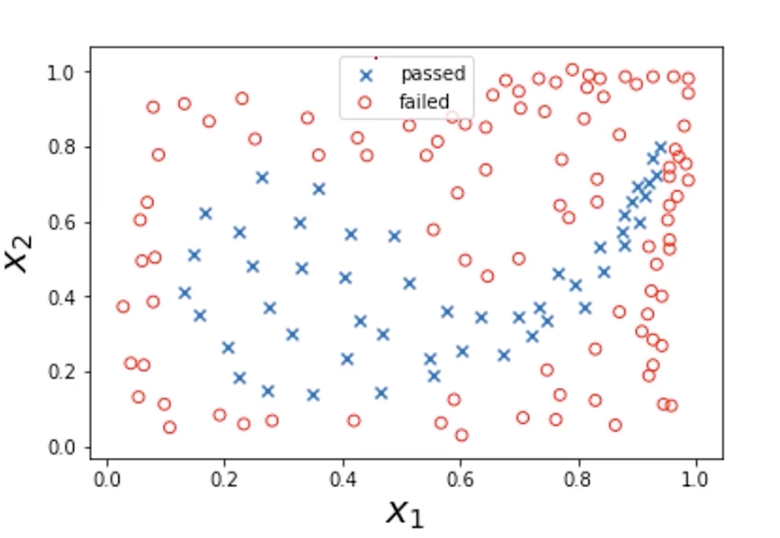
通常来说我们可以建立一个逻辑回归模型来找到决策边界。但是这里的边界明显非常复杂,使用逻辑回归需要生成指数和项数都非常多的多项式。
而现实中的实际数据只可能比这个更加复杂,而且因子也会更多。如果我们这个时候还是使用逻辑回归运算速度就会非常慢。
再举一个例子:
自动识别图片中的动物是猫还是狗
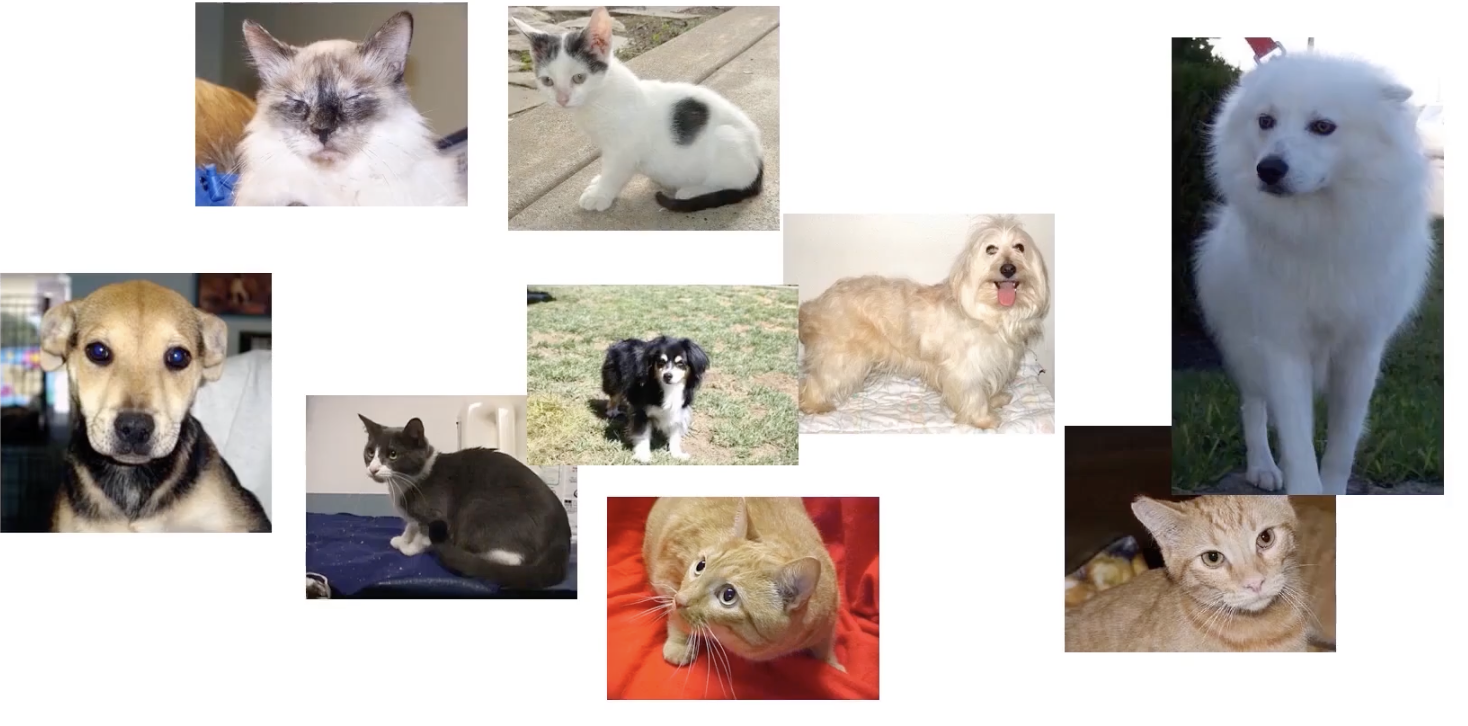
人能够非常直观地分辨出哪个是猫哪个是狗,但计算机不行,照片在计算机眼中只是一堆像素点。
我们先把任务进行简化,假如我就在每张图上取两个固定点$P_1$、$P_2$,得到这两个点的灰度值(Gray Scale),然后把这些数据放到平面直角坐标系中:

假如说红色的点代表猫,蓝色的叉代表狗,那么就让计算机通过逻辑回归找到分辨猫和狗的决策边界。这里由于我们简化了任务,所以决策边界看着不是很复杂,用逻辑回归也能完成。
但在实际的任务中我们会把一个照片的所有像素点的灰度数值给计算机。假如说这里有400x500大小的照片,那么就会有20万个散点数据。这时候用逻辑回归,模型的二次项数量($x_i \times x_j$)会超过百亿个($\frac{200000 \times 199999} {2}$)
这些传统机器学习无法很好处理的问题就需要MLP来处理了。
1.1.2. 多层感知器(人工神经网络)的核心
多层感知器(人工神经网络)的核心就在于像人一样思考。那么人是怎么思考的呢?
这里涉及到一点生物知识:
神经系统中最基础的结构和功能单位就是神经元。
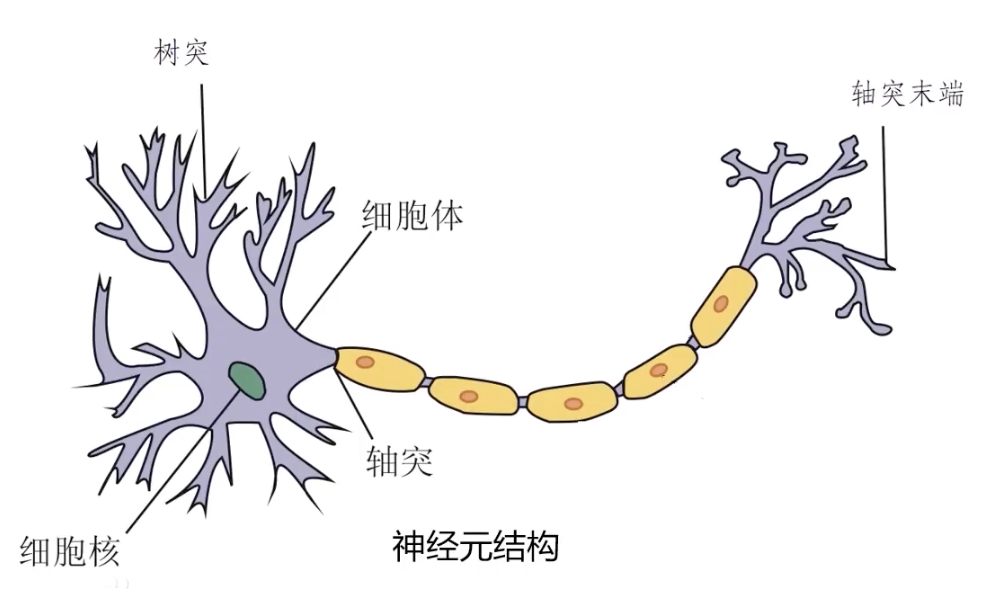
其中最核心的两个部分就是树突和轴突末端:
- 树突:接受上一个神经的轴突释放的化学物质(递质),使该神经产生电位差形成电流传递信息
- 轴突:释放递质给下一个神经元,实现信息传递
而多层感知器(人工神经网络)就是模仿这个基本结构:
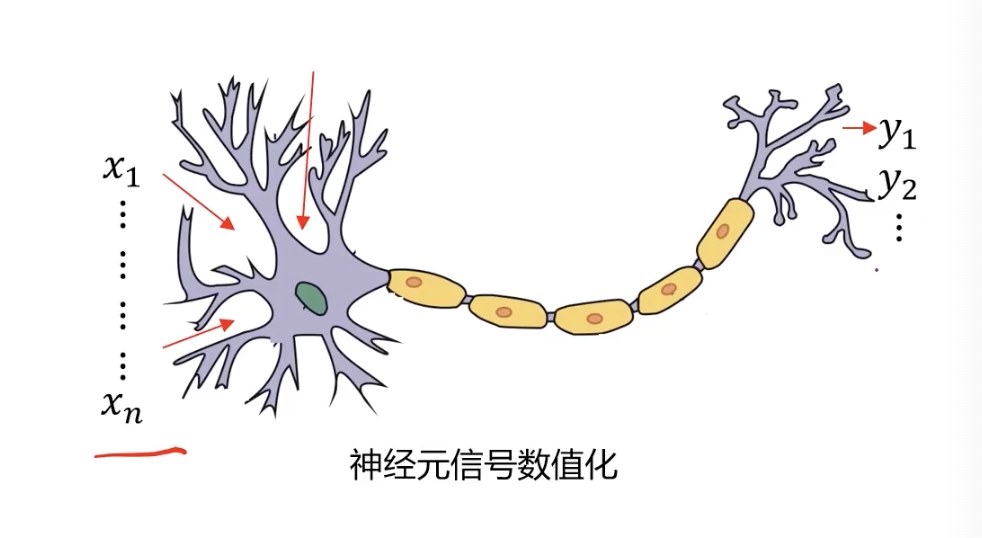
将数据传入这个“神经元”,经过某种处理(某个公式),输出新的数据。
其实这个流程与逻辑回归的架构非常像:
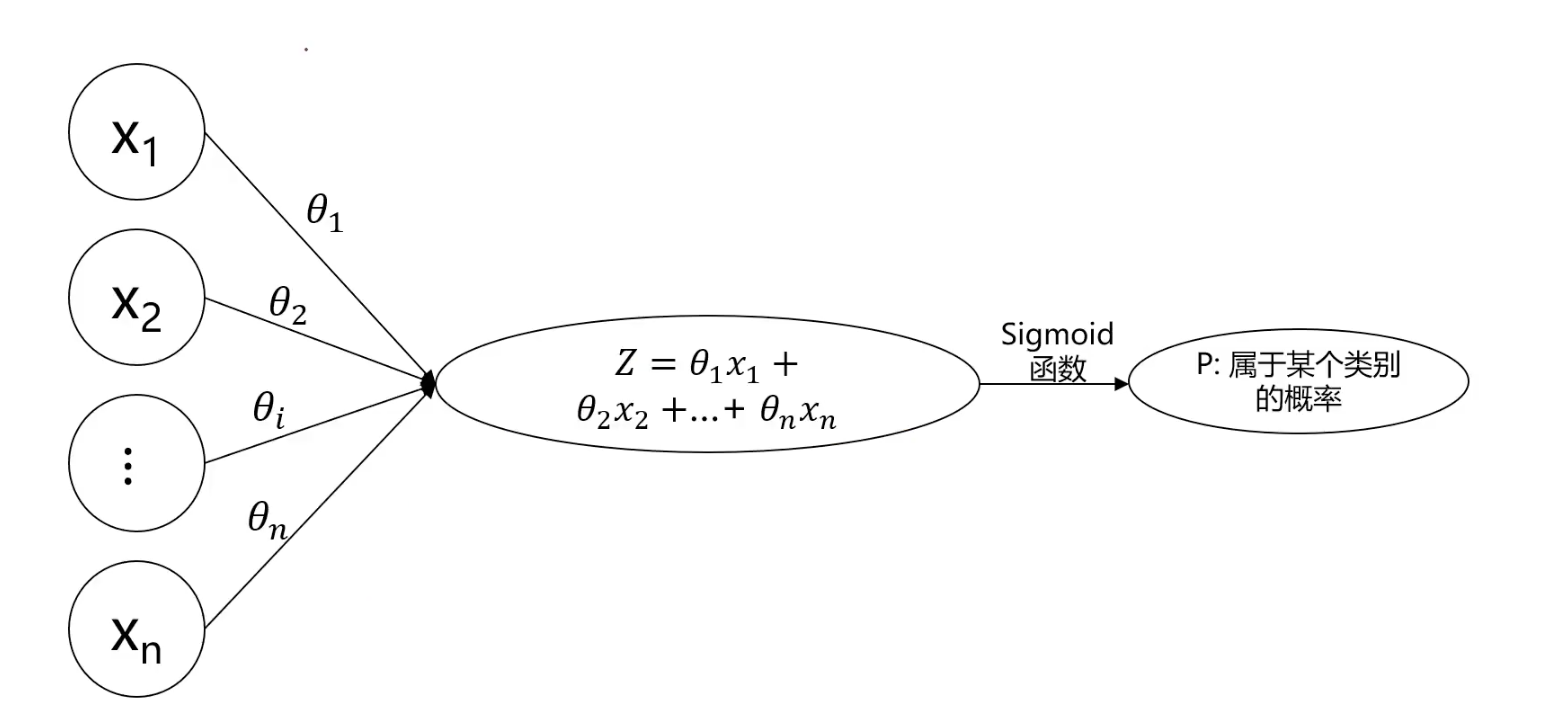
把输入数据经过公式处理得出$P$,而不同的$P$值就可以对应不同的情况。
人的大脑中有许多的神经元组成了神经网络,而多层感知器也正是依靠许多的“逻辑回归结构”叠加形成人工神经网络。
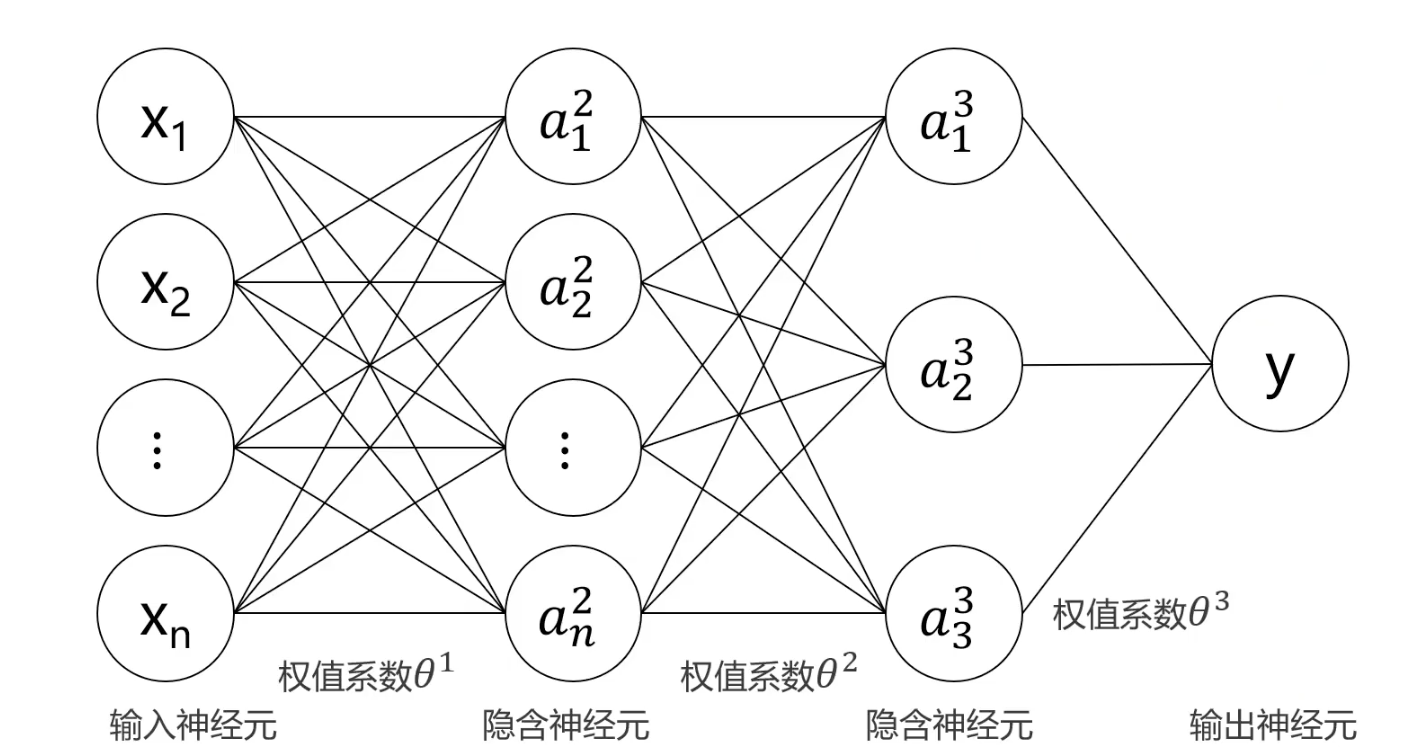
1.1.3. 多层感知器MLP数学表达式
输入神经元就是输入数据,输出神经元的值就确定了属于某个类别的概率。我们知道了每一个神经元节点都是一个逻辑回归模型,就可以推导出被夹在输入神经元和输出神经元中的这些隐含神经元,这里我们以$a_2^2$为例: $$ a_2^2 = g\left(\theta_{20}^{1} x_0 + \theta_{21}^{1} x_1 + \theta_{22}^{1} x_2 + \theta_{23}^{1} x_3 \right) $$
- $a_2^2$:表示第二层(隐藏层)第2个神经元的激活值(即输出)
- $g(\cdot)$:表示激活函数,例如Sigmoid、ReLU、tanh等。用于引入非线性,使模型能学习复杂关系
- $\theta_{ij}^{1}$:表示第一层到第二层之间的权重,这里的上标1表示这是第一层的权重矩阵(通常是输入层到隐藏层的权重)。例如,$\theta_{21}^{1}$代表从输入层第1个输入节点到隐藏层第2个神经元的权重。
- $x_0$, $x_1$, $x_2$, $x_3$ :表示输入值,其中$x_0$通常是偏置项,一般取值为1。
一些名词解释:
- Sigmoid、ReLU、tanh:一些计算非线性变化的公式。其中Sigmoid就是逻辑回归中采用的公式$P(x) = \frac{1}{1 + e^{-x}}$,ReLU和tanh我们会在之后涉及
- 偏置项就像是一个“自由调整的数”,它可以让神经元在没有输入(或输入为零)时仍然有一个非零的输出,用于调整神经元的激活值
我们只要一层一层地这么算每一个神经节点就能得到最终的$y$。
我们需要计算机做的就是根据分类好的数据反推权重。
1.2. 多层感知器MLP(人工神经网络)实现非线性分类理论
本文承接自上一篇文章 1.1. 多层感知器MLP(人工神经网络)介绍,建议先看上一篇文章。
1.2.1. MLP vs. 逻辑回归
MLP能做到的事逻辑回归也可以。逻辑回归的缺点在于需要增加高次项数据才可以完成非线性的分类,导致运行速度极慢。所以我们的目标就是在不增加高次项数据的情况下使用MLP完成分类。
1.2.2. 一个例子
我们来举个例子,假如我们的最终目标是对这些点进行分类:
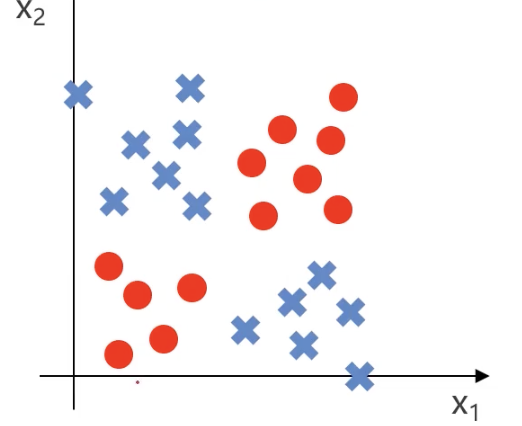
我们可以先简化模型——红色点出现在左下角和右上角,蓝色点出现在左上角和右下角:
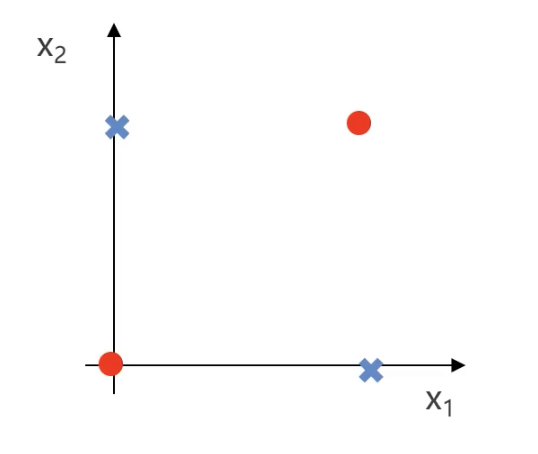
假设红色点值为1,蓝色点值为0,可以得到如下的真值表:
| X₁ | X₂ | y |
|---|---|---|
| 0 | 0 | 1 |
| 0 | 1 | 0 |
| 1 | 0 | 0 |
| 1 | 1 | 1 |
- $x_1$、$x_2$同为0或1时结果为1
- $x_1$、$x_2$不相等时结果为0
用专业的数学名词表达就是此时$y$为$x_1$和$x_2$的同或门($y: x_1 XNOR x_2$)。
1.2.3. 逻辑门
与门(AND)
上文所说的同或门就是逻辑门的一种,先讲一下与门($AND$)这个最基础的逻辑门:当$x_1$、$x_2$同时成立(为1)时结果才成立(为1),其余情况不成立(为0)。
假如我们有以下几个输入因子: $x_0 = 1$、$x_1$和$x_2$
- $x_0$通常是偏置项,一般取值为1。偏置项就像是一个“自由调整的数”,它可以让神经元在没有输入(或输入为零)时仍然有一个非零的输出,用于调整神经元的激活值
设每一个输入数据的权重分别是$\theta_{10}^1$、$\theta_{11}^1$、$\theta_{12}^1$,用权重乘以每个输入值后相加,再使用逻辑函数计算即可得到神经元的输出值: $$ y = h(\theta, x) = g\left(\theta_{10}^{1} + \theta_{11}^{1} x_1 + \theta_{12}^{1} x_2\right) $$
- $\theta_{ij}^{1}$:表示第一层到第二层之间的权重,这里的上标1表示这是第一层的权重矩阵(通常是输入层到隐藏层的权重)。例如,$\theta_{11}^{1}$代表从输入层第1个输入节点到隐藏层第1个神经元的权重。
其中: $$ g(x) = \frac{1}{1 + e^{-x}} $$
如果我们设定权重$\theta_{10}^1 = -20$、$\theta_{11}^1 = 15$、$\theta_{12}^1 = 15$,这个神经元就能实现与门。我们可以先把这些参数带入公式: $$ h(\theta, x) = g\left(-20 + 15x_1 + 15x_2\right) $$
我们把每种情况的值算出来:
| x₁ | x₂ | $h(\theta, x)$ | y |
|---|---|---|---|
| 0 | 0 | $g(-20)$ | 0 |
| 0 | 1 | $g(-5)$ | 0 |
| 1 | 0 | $g(-5)$ | 0 |
| 1 | 1 | $g(10)$ | 1 |
只有$x_1$和$x_2$都是1的时候$y$值才是1,这说明这个神经元实现了与门。
既不是$x_1$也不是$x_2$
接下来我们来个复杂一点的逻辑门:既不是$x_1$也不是$x_2$应该怎么表示呢?这句话中的“不是”代表非门(NOT),“也”代表与门(AND)。
所以它的逻辑门应该写成:$y$: $NOT(x_1)$ $AND$ $NOT(x_2)$
我们修改权重就能把上面的神经元改为输出既不是$x_1$也不是$x_2$的逻辑: $$ h(\theta, x) = g\left(5 - 10x_1 - 10x_2\right) $$
带数据进去算:
| x₁ | x₂ | $h(θ, x)$ | y |
|---|---|---|---|
| 0 | 0 | $g(5)$ | 1 |
| 0 | 1 | $g(-5)$ | 0 |
| 1 | 0 | $g(-5)$ | 0 |
| 1 | 1 | $g(-15)$ | 0 |
或门(OR)
如果我们想实现或门($y:$ $x_1$ $OR$ $x_2$):$x_1$、$x_2$中任意一个是1最后的结果就是1,可以这么写权重: $$ h(\theta, x) = g\left(-10 + 15x_1 + 15x_2\right) $$
带数据进去算:
| x₁ | x₂ | $h(θ, x)$ | y |
|---|---|---|---|
| 0 | 0 | $g(-10)$ | 0 |
| 0 | 1 | $g(5)$ | 1 |
| 1 | 0 | $g(5)$ | 1 |
| 1 | 1 | $g(20)$ | 1 |
1.2.4. 逻辑门与MLP
$y:$ $x_1$ $AND$ $x_2$
graph TD;
    A[1] -->| -20 | D[y]
    B[x₁] -->| 15 | D[y]
    C[x₂] -->| 15 | D[y]
$y$: $NOT(x_1)$ $AND$ $NOT(x_2)$
graph TD;
    A[1] -->| 5 | D[y]
    B[x₁] -->| -10 | D[y]
    C[x₂] -->| -10 | D[y]
$y:$ $x_1$ $OR$ $x_2$
graph TD;
    A[1] -->| -10 | D[y]
    B[x₁] -->| 15 | D[y]
    C[x₂] -->| 15 | D[y]
我们通过这些逻辑门的排列组合就能组成一个比较复杂的MLP模型从而实现最开始的同或门($y: x_1 XNOR x_2$)逻辑。
具体怎么做呢?逻辑是这样的:
graph TD;
    %% 输入层
    A[1] -->| 5 | B[a₁²]
    A[1] -->| -20 | C[a₂²]
    X1[x₁] -->| -10 | B[a₁²]
    X1[x₁] -->| 15 | C[a₂²]
    X2[x₂] -->| -10 | B[a₁²]
    X2[x₂] -->| 15 | C[a₂²]

    %% 隐藏层到输出层
    B[a₁²] -->| 15 | Y[y]
    C[a₂²] -->| 15 | Y[y]
    Bias2[1] -->| -10 | Y[y]
这么看你可能有点懵,我来逐步解释:
- $a_1^2$的值是$x_1$和$x_2$的既不是$x_1$也不是$x_2$的结果
- $a_2^2$的值是$x_1$和$x_2$的与门结果
- $y$值是$a_1^2$和$a_2^2$的或门结果
我们带数据进去看一下这样写能否实现同或门的效果:
| x₁ | x₂ | a₁² | a₂² | $h(θ, x)$ | y |
|---|---|---|---|---|---|
| 0 | 0 | 1 | 0 | $g(5)$ | 1 |
| 0 | 1 | 0 | 0 | $g(-10)$ | 0 |
| 1 | 0 | 0 | 0 | $g(-10)$ | 0 |
| 1 | 1 | 0 | 1 | $g(5)$ | 1 |
1.2.5. 解决问题
我们刚刚解决的是简化后的模型的分类问题:
那么机器会如何迭代到类似于这个同或门效果呢?我们只需要让模型不断迭代就能得到最终例子的分类:
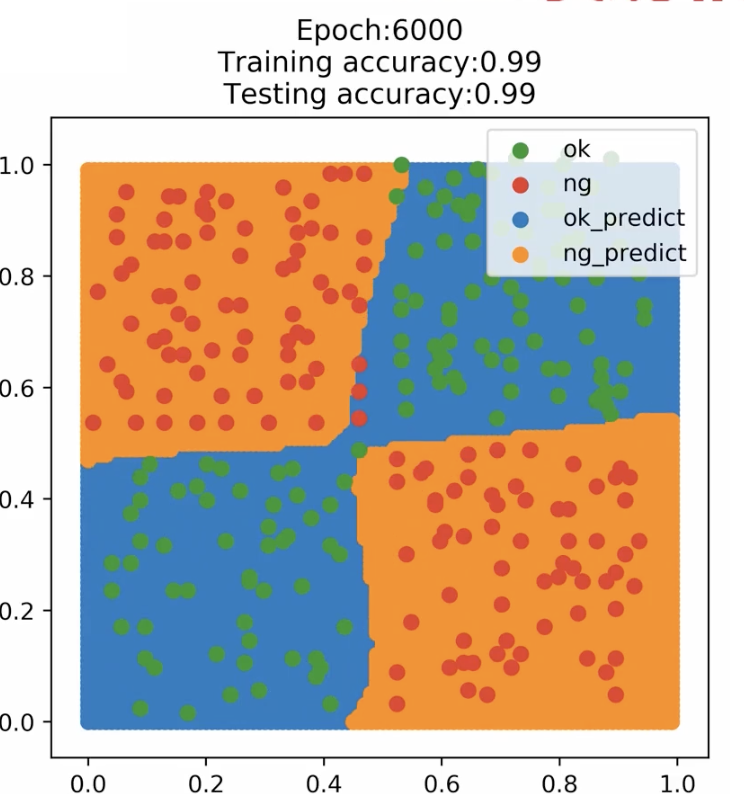
具体是怎么迭代的呢: (1) 随机初始化权重
- MLP(多层感知机)最开始的权重是随机初始化的,这意味着一开始的决策边界是随机的,不一定有任何实际意义。
(2) 前向传播计算输出
- 计算输入$x_1$,$x_2$经过隐藏层和激活函数后的输出。
- 计算MLP的最终预测值$y$。
- 与真实标签$y_{\text{true}}$进行比较,计算损失函数(比如交叉熵损失或均方误差)。
(3) 误差计算与反向传播
- 通过误差反向传播(Backpropagation) 计算各个权重对误差的贡献。
- 通过梯度下降(Gradient Descent) 或Adam进行参数更新,使模型的预测更接近真实标签。
(4) 经过几轮迭代:
- MLP 逐渐学习到哪些区域应该输出1,哪些区域应该输出0。
- 隐藏层神经元学习到基本特征,例如某些区域对应与门(AND),某些区域对应或门(OR),最终组合成XNOR模型。
- 训练过程中,决策边界逐渐向实际分类边界靠拢,最终形成类似非线性分隔面(如图中蓝色与橙色区域的边界)。
1.2.6. MLP实现多分类
现实生活中数据不一定只有两种情况,会有很多种,这时候就要求MLP实现多分类。
我们来回忆一下MLP的基本框架:
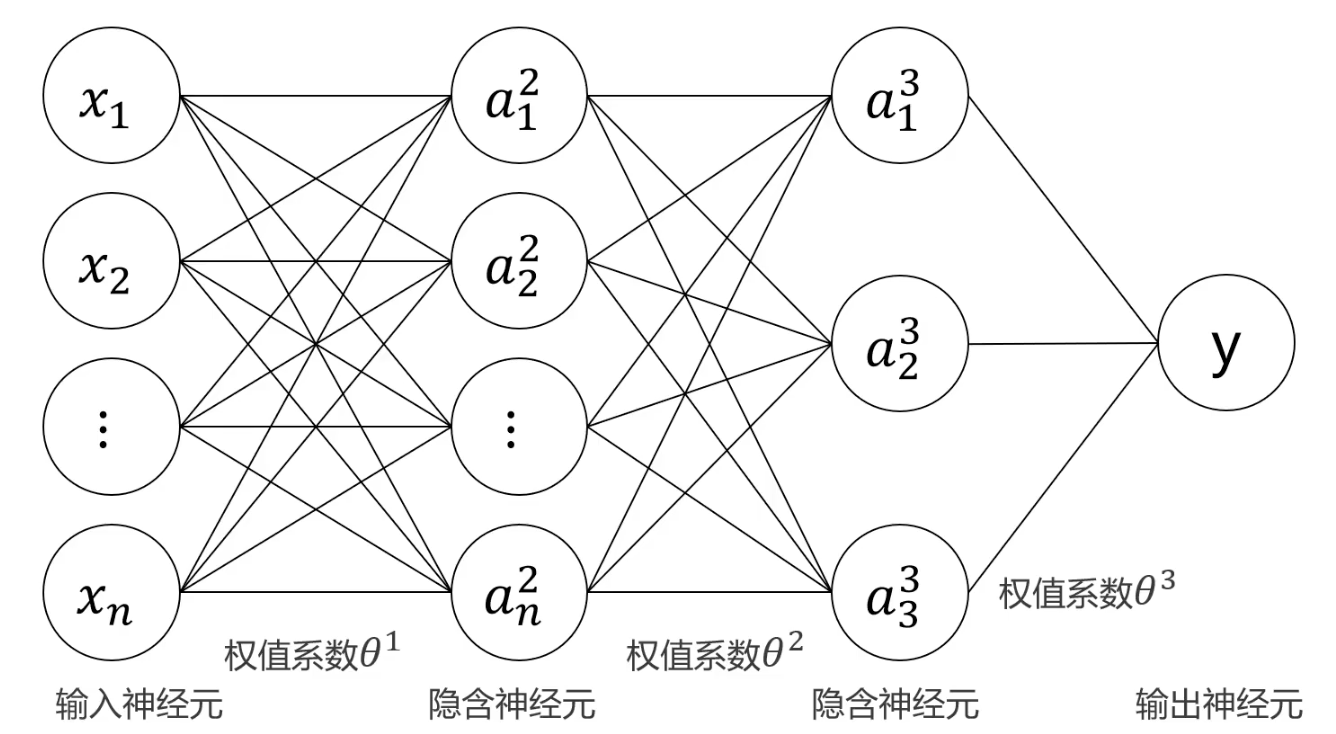
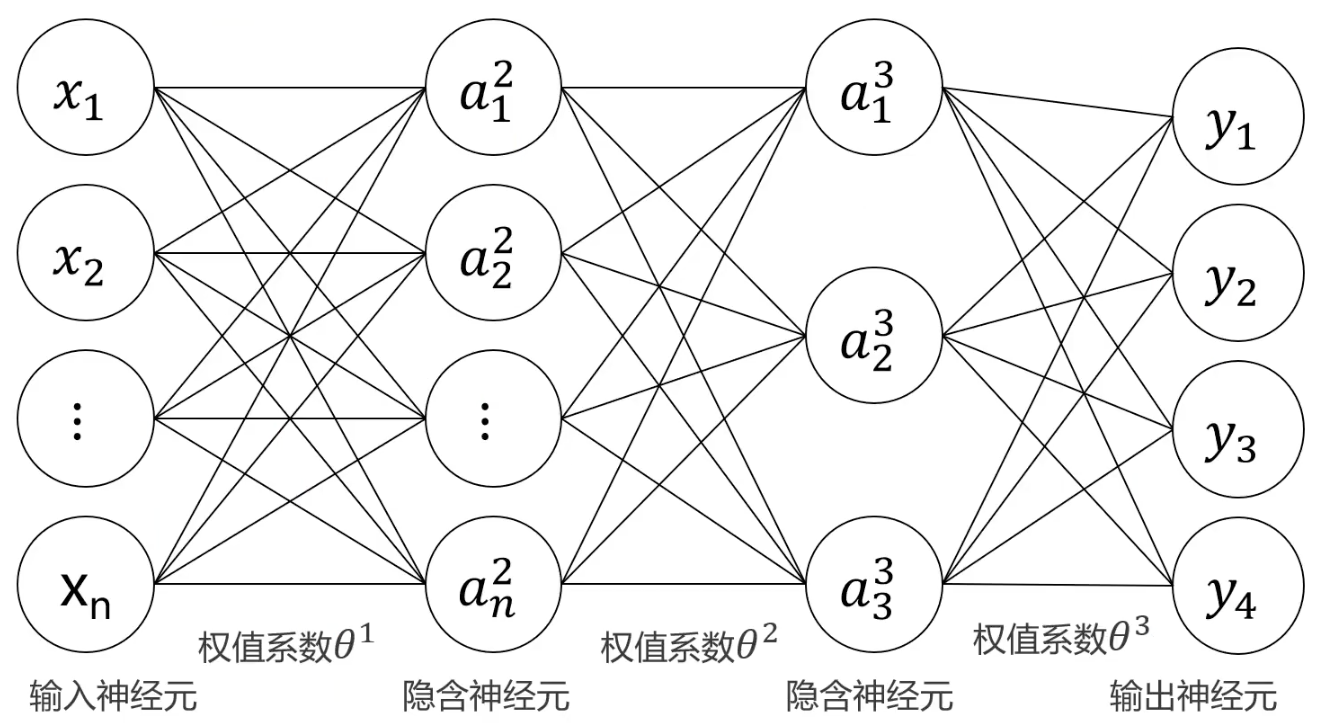
我们可以通过输出若干个神经元来实现多分类。假如有4个类别,就设立4个输出神经元: $y_1$, $y_2$, $y_3$, $y_4$,我们输入数据之后就会得到4个神经元的输出,也就是数据属于每种情况的概率,我们选最大概率的那个作为预测结果即可,如下图:
1.3. 利用Keras实现多层感知器MLP(人工神经网络)
本文承接自上一篇文章 1.2. 多层感知器MLP(人工神经网络)实现非线性分类理论,建议先看上一篇文章。
1.3.1. Keras
Keras 是一个用 Python 编写的用于神经网络开发的应用接口,调用该接口可以实现神经网络、卷积神经网络、循环神经网络等常用深度学习算法的开发。
特点:
- 集成了深度学习中各类成熟的算法,容易安装和使用,样例丰富,教程和文档也非常详细
- 能够以TensorFlow,或者Theano作为后端运行
我把官方网址附在这里。
1.3.2. Keras和TensorFlow的关系
Tensorflow是一个采用数据流图,用于数值计算的开源软件库,可自动计算模型相关的微分导数:非常适合用于神经网络模型的求解。
Keras可看作为tensorflow封装后的一个接口(Keras作为前端,TensorFlow作为后端)。Keras为用户提供了一个易于交互的外壳,方便进行深度学习的快速开发。
1.3.3. 下载并安装Keras和TensorFlow
请在终端输入指令以下载和安装:
pip install keras tensorflow
1.3.4. 准备工作
这里需要使用到我的csv文件,我把它上传到了GitCode,你点击链接即可查看和下载。
它有3栏信息,一栏是x1,一栏是x2,这两栏代表两个输入变量。另一栏是label,这一栏数据要么是0要么是1。
下载好后把它移到你的Python项目文件夹里即可。
1.3.5. 敲代码
Step 1: 读取数据
首先使用pandas库读取数据:
# 读取数据
import pandas as pd
data = pd.read_csv('scatter_data.csv')
使用matplotlib可视化出来:
# 可视化原始数据
# 绘制散点图
import matplotlib.pyplot as plt

scatter = plt.scatter(
    data['x1'],
    data['x2'],
    c = ['blue' if label == 0 else 'red' for label in data['label']],
)

plt.show()
图片输出:
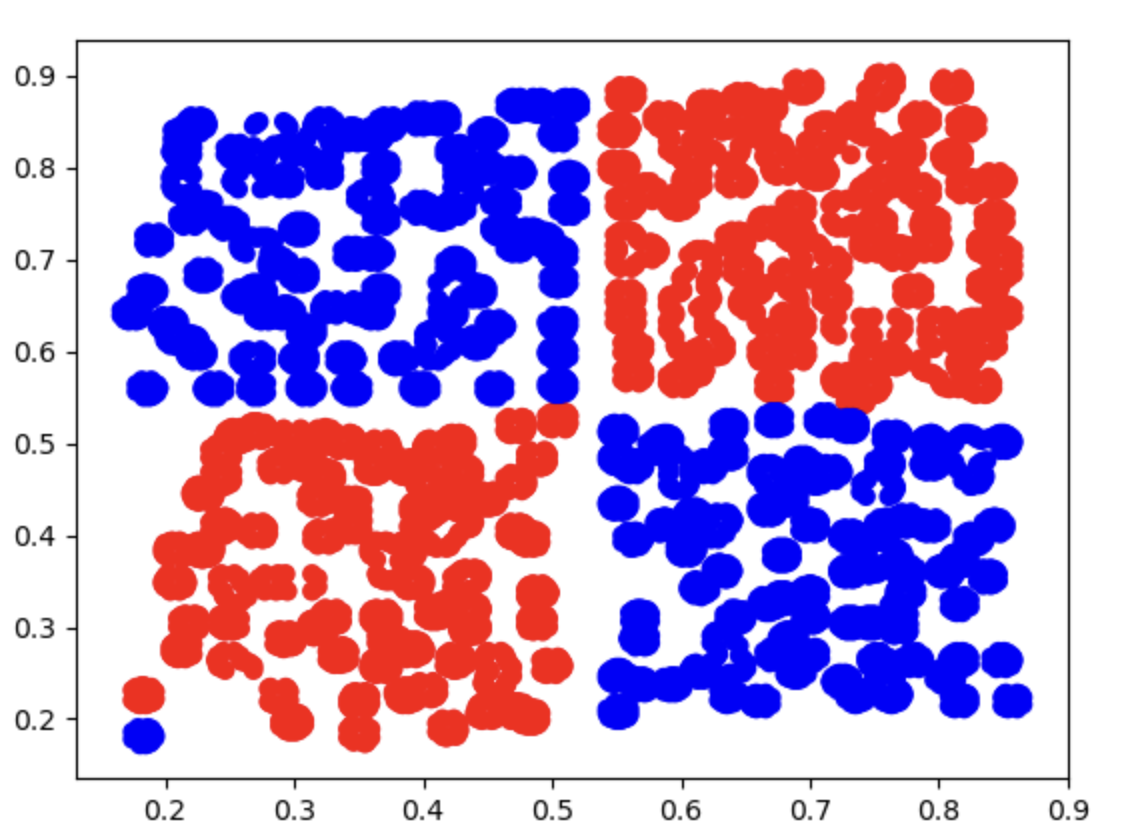
Step 2: 给x和y赋值
x值对应两个输入值x1和x2y值对应标签label
# 给x和y赋值
x = data.drop(['label'], axis=1)
y = data.loc[:,'label']
我们还要把数据分出训练集和测试集,以便后面的模型评估:
# 分离出训练集和测试集
from sklearn.model_selection import train_test_split
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.3, random_state=10)
Step 3: 创建模型
我们需要创建一个一共三层的MLP来解决问题,并且每个神经元使用逻辑函数,其大致结构应该如下流程图:
graph TD;
    %% 输入层
    A[1] -->| 5 | B[a₁²]
    A[1] -->| -20 | C[a₂²]
    X1[x₁] -->| -10 | B[a₁²]
    X1[x₁] -->| 15 | C[a₂²]
    X2[x₂] -->| -10 | B[a₁²]
    X2[x₂] -->| 15 | C[a₂²]

    %% 隐藏层到输出层
    B[a₁²] -->| 15 | Y[y]
    C[a₂²] -->| 15 | Y[y]
    Bias2[1] -->| -10 | Y[y]
# 建立一个Sequential顺序模型
from keras.models import Sequential
model = Sequential()

# 通过add叠加各层网络
from keras.layers import Dense
model.add(Dense(units=20, activation='sigmoid', input_dim=2)) # 第一层(输入层)到第二层(隐藏层)
model.add(Dense(units=1, activation='sigmoid')) # 第二层(隐藏层)到第三层(输出层)

# 查看模型结构
model.summary()

# 通过.compile()配置模型求解过程参数
model.compile(loss='binary_crossentropy', optimizer='adam', metrics=['accuracy'])
-
Sequential是Keras中一种基础的模型类型,用于逐层叠加网络结构,模型中的各层按创建顺序依次连接。 使用这种方式,非常适合构建从输入到输出一条路径的神经网络(经典的前馈神经网络) -
第一个
add添加的是Dense层(隐藏层): 全连接层,每个神经元和上一层的每个神经元相互连接units=20: 表示隐藏层包含20个神经元activation='sigmoid': 使用逻辑函数作为激活函数,它可以将输入值转换到区间(0, 1)范围内,适用于二分类或需要概率输出的场景input_dim=2: 表示输入特征的维度是2(x1和x2),这里设置的是第一层的输入形状。
-
第二个
add添加的是输出层:units=1:表示这一层只有一个神经元,即输出的维度为1activation='sigmoid':在输出层,sigmoid 常用作二分类问题的激活函数,输出介于0和1之间,表示属于某一类别的概率
-
model.summary(): 打印神经网络模型的详细结构信息,包括每一层的名字、输出的形状和参数数目。 这是调试和理解模型的重要方法,用来确认您构建的模型符合预期的设计 -
.compile()用于定义模型的训练配置,包括损失函数、优化器和评估指标:loss='binary_crossentropy': 损失函数,根据模型的任务选择合适的损失函数。binary_crossentropy一般用于二分类问题optimizer='adam': 优化器,这里是Adam(Adaptive Moment Estimation,自适应矩估计)metrics=['accuracy']: 评估指标,这里选择了准确率作为评估标准
输出:
Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ dense (Dense)                   │ (None, 20)             │            60 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_1 (Dense)                 │ (None, 1)              │            21 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
 Total params: 81 (324.00 B)
 Trainable params: 81 (324.00 B)
 Non-trainable params: 0 (0.00 B)
Step 4: 训练模型
我们把数据喂给模型,进行迭代即可:
model.fit(x_train, y_train, epochs=3000)
epochs参数控制迭代次数。
Step 5: 预测数据
我们使用测试集的x值预测y值,与实际的y值对比生成准确率:
# 预测值
y_predict = model.predict(x_test)

# 将概率值转换成离散的类别标签
y_predict_classes = (y_predict > 0.5).astype(int)

# 计算准确率
from sklearn.metrics import accuracy_score

print(accuracy_score(y_test, y_predict_classes))
输出:
0.9977413890457368
如果我们继续迭代准确率会更高,但有可能因此过拟合,得不偿失。
1.4. 多层感知器MLP(人工神经网络)实现手写数字识别(图像多分类)
本文承接自上一篇文章 1.3. 利用Keras实现多层感知器MLP(人工神经网络),建议先看上一篇文章。
1.4.1. MNIST数据集
在这篇文章中我们会使用MNIST数据集建立MLP模型,实现手写数字0~9的识别。
MNIST(Modified National Institute of Standards and Technology)数据集是一个用于训练和测试机器学习模型的手写数字识别数据集。它由 70,000 张灰度图像组成,其中:
- 训练集(Training Set):60,000 张图片
- 测试集(Test Set):10,000 张图片
每张图片都是 28×28 像素的灰度图,表示一个手写数字(0-9 之间)。数据集中的标签(Label)是 0 到 9 之间的整数,表示图像中手写的数字类别。
我们选用它的原因在于:
- 标准化:所有图像的尺寸一致(28×28 像素)
- 简单易用:适合作为深度学习入门数据集
- 广泛应用:用于测试各种机器学习、深度学习模型的性能,如 CNN(卷积神经网络)、SVM(支持向量机)等
1.4.2. 准备工作
本文会使用到keras、tensorflow和matplotlib,如果没有请下载。
在终端输入指令以下载和安装:
pip install keras tensorflow matplotlib
1.4.3. 敲代码
Step 1: 导入MNIST数据集的数据
Keras中包含了MNIST数据集,所以我们就可以直接导入:
from keras.datasets import mnist
(x_train, y_train),(x_test, y_test) = mnist.load_data()
第一次使用数据集程序会先从官网下载资源,需要等一会儿。我们可以看看数据的一些信息:
print(type(x_train), x_train.shape)
<class 'numpy.ndarray'> (60000, 28, 28)
- 其类型是
numpy数组 - 有60000个样本,每一个都是28乘28像素
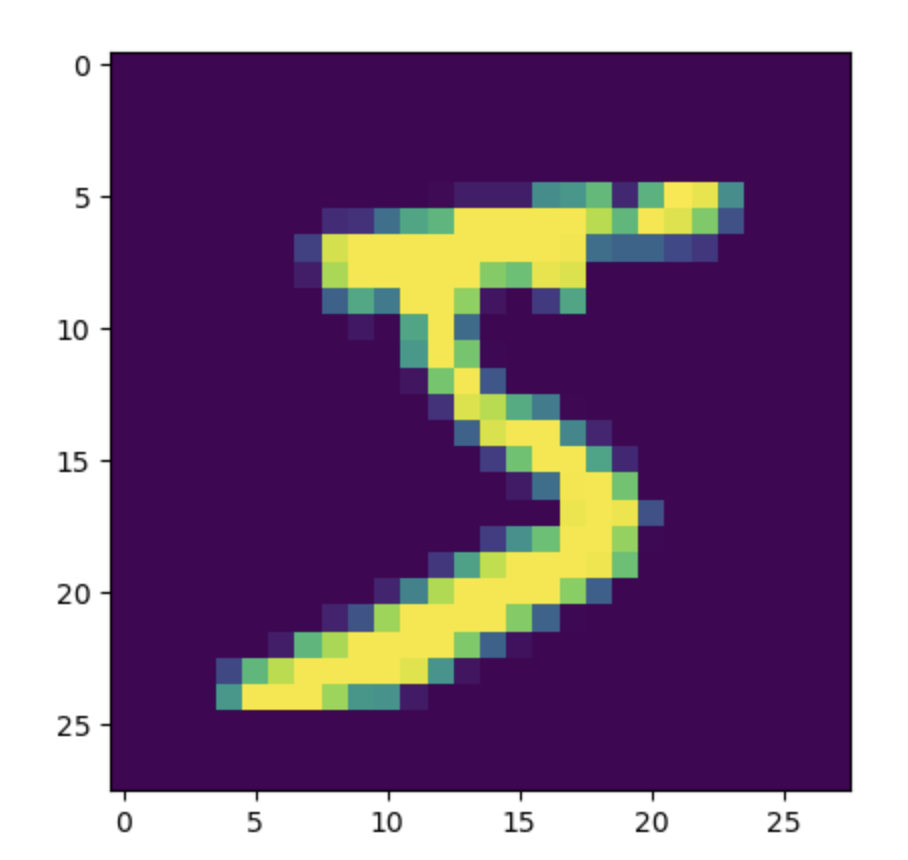
我们可以使用matplotlib来查看里面的数据长什么样:
# 可视化输入数据
from matplotlib import pyplot as plt
plt.imshow(x_train[0])
plt.show()
输出图像:
Step 2: 数组转换
我们需要把每个图片从28行28列的二维数组转为有784个元素的一维数组供MLP接收:
# 转化数据
feature_size = x_train.shape[1] * x_train.shape[2]
x_train = x_train.reshape(x_train.shape[0], feature_size)
x_test = x_test.reshape(x_test.shape[0], feature_size)
- 原始形状是
(样本数量, 高, 宽),表示每张图片的数据,转换后形状为(样本数量, 特征大小),所有像素铺平成一维的特征向量,使每张图片可以作为一个样本供模型处理 feature_size对应特征大小,也就是单张图的像素个数,用x_train.shape[1] * x_train.shape[2]即可得到reshape是 NumPy 包中用于调整数组形状的方法,常应用于调整矩阵或张量的数据维度,而不改变数据本身。这个方法不会修改原数组,而是返回一个新的数组(与原数据共享内存)
我们可以打印出此时数据的结构:
print(x_train.shape)
输出:
(60000, 784)
Step 3: 数据归一化
MNIST数据集中的图像是8bit灰度图,像素点的值区间是0~255,在MLP模型中使用到的非线性激活函数,比如sigmoid、tanh 或 ReLU,它们对数值范围敏感。所以我们需要进行归一化,把数据的范围缩小。
一般来说把像素点的灰度值除以255即可,这样就能让值保持在0到1之间,更适于MLP模型:
# 数据归一化
x_train = x_train.astype('float32')
x_test = x_test.astype('float32')
x_train /= 255
x_test /= 255
astype('float32'):MNIST 数据集的像素值在加载后为整型 (0~255 的整数)astype('float32')将它们转换为浮点型数据,以便进行更精确的数学运算(如归一化和梯度更新)x_train /= 255和x_test /= 255:将像素值除以 255,使其范围从原本的[0, 255]被压缩到[0, 1]
Step 4: 转换标签的格式
模型的输出标签会是one-hot编码:每个类别分配一个位置,将特定类别的位置置为1,其余位置为 0。假设有3个类别:A、B和C,那么:
- 类别
A的编码是[1, 0, 0]; - 类别
B的编码是[0, 1, 0]; - 类别
C的编码是[0, 0, 1]。
原本标签的格式是整数标签:比如图片里是手写的5,那对应的标签值就是5。
这两者的保存格式不一样就会给对比标签评估模型的操作带来麻烦。我们需要把原本的整数标签改为one-hot编码。
假如我们的标签是5,我们需要把“5”以这种方式保存:
[0, 0, 0, 0, 0, 1, 0, 0, 0, 0]
想要表示5就在第6位(第一位是0,所以每个数字的落位都要后移1位)写1,其余为0
keras提供了转化标签格式的函数to_categorical:
# 转换标签的格式
from keras.utils import to_categorical
y_train = to_categorical(y_train)
y_test = to_categorical(y_test)
Step 5: 建立模型
完成上文所说的所有数据预处理工作之后就可以建立模型了!我们的输入有784个(对应像素数量),第二层我们要减半到392个神经元,第三层仍然保持392个神经元;第四层,也就是输出层,得有10个输出神经元,对应0~9:
# 建立模型
from keras.models import Sequential
from keras.layers import Dense

model = Sequential()
model.add(Dense(units=392, activation='sigmoid', input_dim=feature_size))
model.add(Dense(units=392, activation='sigmoid'))
model.add(Dense(units=10, activation='softmax'))
-
units=392:表示该层有 392 个神经元(隐藏节点) -
input_dim=feature_size:输入维度,表示该层接受的数据有多少个特征。对应之前输入层形状(样本数, feature_size),即feature_size = 784(MNIST 数据的每张图片转成特征向量后有 784 个像素点)。从第二层开始并不需要显式声明input_dim,因为它会自动从上一层(第一个隐藏层)的输出中推断输入形状。 -
Softmax激活函数将输出神经元的值(logits)映射为概率分布,适用于多分类问题
使用summary方法来展示一下结构:
model.summary()
输出:
Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ dense (Dense)                   │ (None, 392)            │       307,720 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_1 (Dense)                 │ (None, 392)            │       154,056 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_2 (Dense)                 │ (None, 10)             │         3,930 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
 Total params: 465,706 (1.78 MB)
 Trainable params: 465,706 (1.78 MB)
 Non-trainable params: 0 (0.00 B)
Step 6: 配置模型
在配置时我们就可以选择这个模型是二分类还是多分类、使用什么优化器算法:
# 配置模型
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])
-
compile是 Keras 模型的方法,用于在训练模型之前配置模型的学习过程,它的主要参数有:- 损失函数(
loss):定义模型训练时计算误差的方法。 - 优化器(
optimizer):决定模型的参数(如权重和偏置)如何更新,以最小化损失函数。 - 评估指标(
metrics):决定用于评估模型性能的指标,这些指标不会影响模型训练,只用于衡量效果。
- 损失函数(
-
loss='categorical_crossentropy':categorical_crossentropy(类别交叉熵)是多分类任务中常用的损失函数 -
optimizer='adam':adam(Adaptive Moment Estimation)是一种自适应学习率优化算法,是深度学习中最常用的优化器之一 -
metrics=['accuracy']:指定模型在训练和评估时用准确率来衡量性能
Step 7: 训练模型
我们只需要把训练集数据喂给模型即可:
# 训练模型
model.fit(x_train, y_train, epochs=10)
epochs参数控制迭代次数。
如果和上一篇文章相比,我们这次选的迭代次数并不多(上次定的是3000次迭代,这次只有10),这是因为我们的图像数据非常多(60000个),不需要很多次迭代就能得到很好的效果。但是每一次迭代花费的时间就会比较久。
Step 8: 模型评估
我们使用准确率来评估模型。
由于 Step 4 已将标签转为 one-hot 编码,评估时可以用 argmax 把预测概率和真实标签都还原成类别编号,再比较是否一致:
# 训练集准确率
import numpy as np
y_train_predict = model.predict(x_train)
y_train_pred_classes = np.argmax(y_train_predict, axis=1)
y_train_true_classes = np.argmax(y_train, axis=1)
train_accuracy = np.mean(y_train_pred_classes == y_train_true_classes)
print("训练集准确率:", train_accuracy)

# 测试集准确率
y_test_predict = model.predict(x_test)
y_test_pred_classes = np.argmax(y_test_predict, axis=1)
y_test_true_classes = np.argmax(y_test, axis=1)
test_accuracy = np.mean(y_test_pred_classes == y_test_true_classes)
print("测试集准确率:", test_accuracy)
np.argmax(..., axis=1):对每一行取概率最大的类别下标。例如预测[0.1, 0.8, 0.1, ...]会得到类别1- 将预测类别与真实类别逐样本比较,再用
np.mean统计正确比例,即为准确率
输出:
训练集准确率: 0.9979166666666667
测试集准确率: 0.9808
2.1. 卷积神经网络(CNN)模型理论(基础):卷积运算、池化、ReLU函数
2.1.1. 计算量问题
我们提出MLP问题的初衷就是为了解决逻辑回归计算量过大的问题。
以手写识别(28乘28像素)来说:
- 三次多项式为决策边界的逻辑回归待训练的参数数量为80931145
- MLP模型(784个输入数据,两个隐藏层层各394个隐藏神经元,输出层10个神经元)的待训练参数数量为465706
但是这只是一张非常小的图片,而且是灰度图,如果对日常生活中长宽都在100像素以上的RGB三色图片,比如500乘400,进行二分类,我们会需要78558378个待训练参数。这个计算量还是太高了。
那有没有更节省计算量的方式呢?这就是卷积神经网络发挥作用的地方了。
2.1.2. 图像卷积运算
想一下,计算机在进行目标识别时主要是看什么?轮廓对吧。MLP计算量过大就是因为图中的轮廓过多,计算机算不过来。如果我们能先提取出图片中主要的轮廓(比较关键的信息)再让MLP进行分析就能大幅降低计算量。
提取出主要信息这一步就需要图像卷积运算(convolution)。图像卷积运算是指对图像矩阵与滤波器矩阵进行对应相乘再求和运算,转化得到新的矩阵。它的主要作用就是快速定位图像中某些边缘特征。
数学上,A与B的卷积通常表示为: $$ A \ast B $$ 或: $$ convolution(A, B) $$
我们来举个例子:
我们有一个7乘7二维数组,代表一幅图片: $$ A =
\begin{bmatrix}
X_{11} & X_{12} & X_{13} & X_{14} & X_{15} & X_{16} & X_{17} \
X_{21} & X_{22} & X_{23} & X_{24} & X_{25} & X_{26} & X_{27} \
X_{31} & X_{32} & X_{33} & X_{34} & X_{35} & X_{36} & X_{37} \
X_{41} & X_{42} & X_{43} & X_{44} & X_{45} & X_{46} & X_{47} \
X_{51} & X_{52} & X_{53} & X_{54} & X_{55} & X_{56} & X_{57} \
X_{61} & X_{62} & X_{63} & X_{64} & X_{65} & X_{66} & X_{67} \
X_{71} & X_{72} & X_{73} & X_{74} & X_{75} & X_{76} & X_{77}
\end{bmatrix} $$
我们还有一个3乘3的滤波器: $$ F =
\begin{bmatrix}
W_{11} & W_{12} & W_{13} \
W_{21} & W_{22} & W_{23} \
W_{31} & W_{32} & W_{33}
\end{bmatrix} $$ 我们进行$A \ast B$运算,会长这样(这个图进行了图像填充,但我们这里就当它是7乘7的原始大小,下一篇文章我们会讲图像填充(详见 2.2. 卷积神经网络(CNN)模型理论(进阶):图像填充、LeNet、AlexNet)):
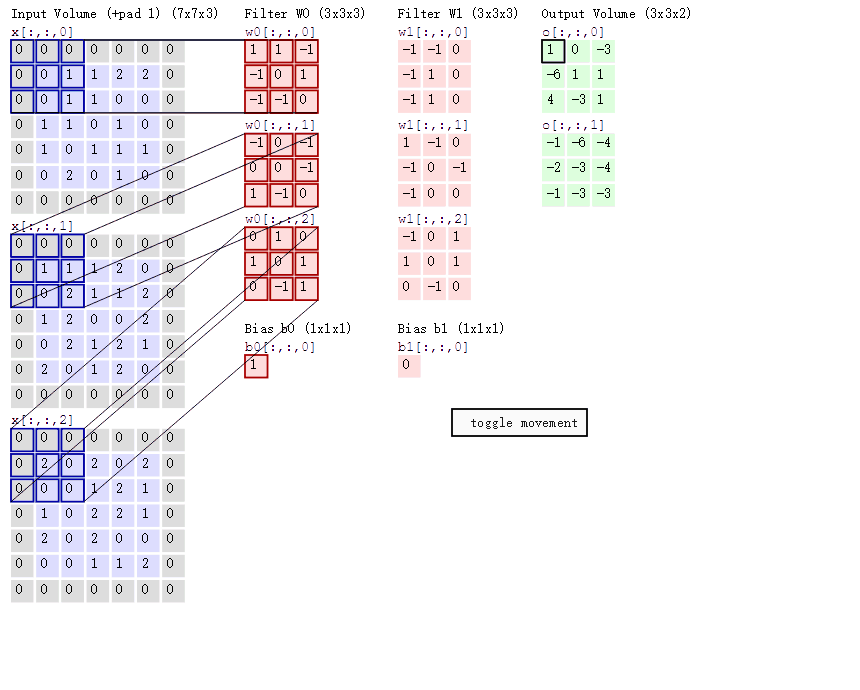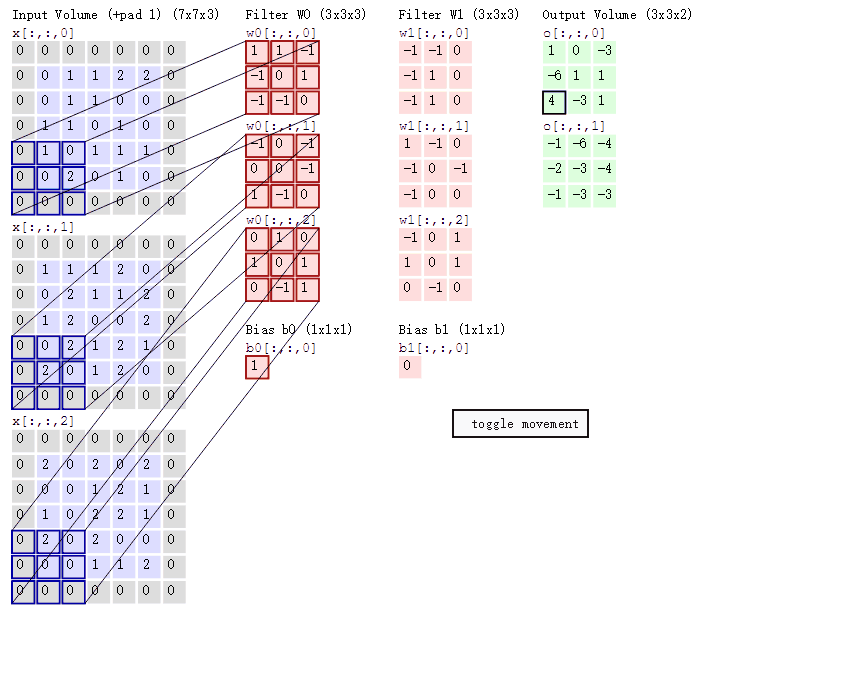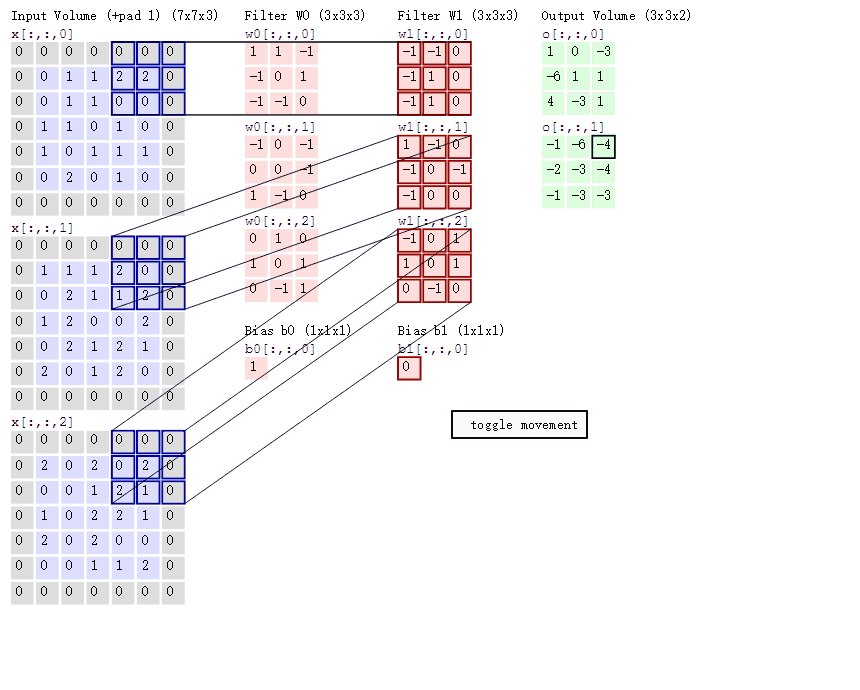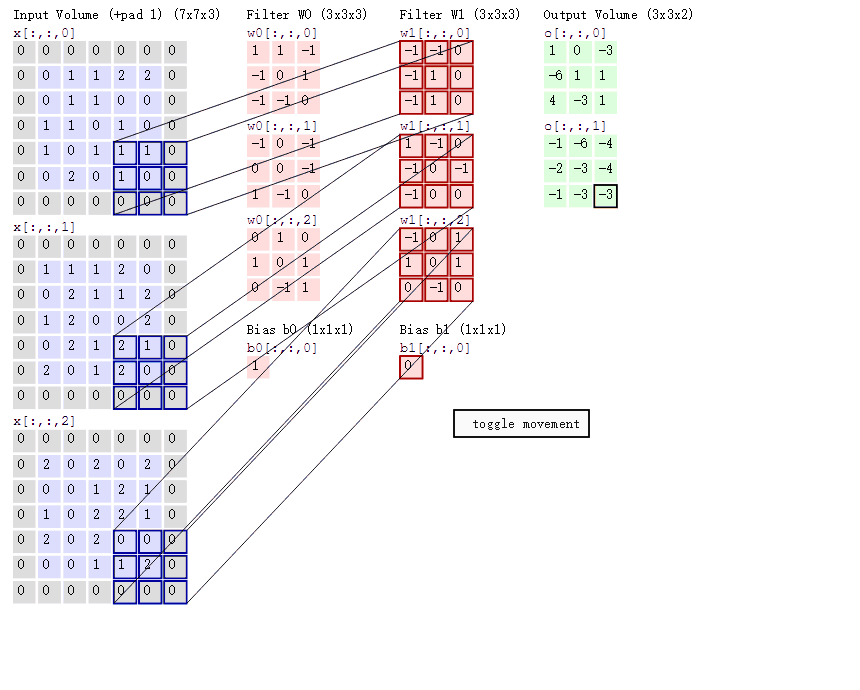
滤波器就像是一个掩膜一样覆盖在图像上,遮盖到图像的哪里就对哪里进行卷积操作,逐个像素地移动。
假如滤波器现在在图像的左上角,覆盖: $$ \begin{bmatrix}
X_{11} & X_{12} & X_{13} \ X_{21} & X_{22} & X_{23} \ X_{31} & X_{32} & X_{33} \
\end{bmatrix} $$ 那么进行的卷积运算(相乘再求和)就是: $$ Y_{11} = X_{11} W_{11} + X_{12} W_{12} + X_{13} W_{13} + X_{21} W_{21} + X_{22} W_{22} + X_{23} W_{23} + X_{31} W_{31} + X_{32} W_{32} + X_{33} W_{33} $$
如果我们对整个矩阵进行卷积计算就会得到一个小一点(从7乘7到5乘5)的矩阵: $$ Y = \begin{bmatrix} Y_{11} & Y_{12} & Y_{13} & Y_{14} & Y_{15} \ Y_{21} & Y_{22} & Y_{23} & Y_{24} & Y_{25} \ Y_{31} & Y_{32} & Y_{33} & Y_{34} & Y_{35} \ Y_{41} & Y_{42} & Y_{43} & Y_{44} & Y_{45} \ Y_{51} & Y_{52} & Y_{53} & Y_{54} & Y_{55} \end{bmatrix} $$
2.1.3. 寻找指定特征
那么如何寻找图中特定的轮廓呢?
寻找竖向轮廓
假设我们有如下的一个图像像素矩阵,我们想要找它的竖向轮廓: $$ A =
\begin{bmatrix}
20 & 20 & 20 & 0 & 0 & 0 \
20 & 20 & 20 & 0 & 0 & 0 \
20 & 20 & 20 & 0 & 0 & 0 \
20 & 20 & 20 & 0 & 0 & 0 \
20 & 20 & 20 & 0 & 0 & 0 \
20 & 20 & 20 & 0 & 0 & 0
\end{bmatrix} $$
我们可以修改过滤器矩阵的值: $$ K =
\begin{bmatrix}
1 & 0 & -1 \
1 & 0 & -1 \
1 & 0 & -1
\end{bmatrix} $$ 这样的出来的卷积结果就是: $$ \begin{bmatrix}
0 & 60 & 60 & 0 \
0 & 60 & 60 & 0 \
0 & 60 & 60 & 0 \
0 & 60 & 60 & 0
\end{bmatrix} $$ 包含竖向轮廓的区域灰度值就非常高,在图像上就会被高亮突出。
寻找横向轮廓
那么寻找横向轮廓呢?
假设我们有如下的一个图像像素矩阵: $$ A =
\begin{bmatrix}
20 & 20 & 20 & 20 & 20 & 20 \
20 & 20 & 20 & 20 & 20 & 20 \
20 & 20 & 20 & 20 & 20 & 20 \
0 & 0 & 0 & 0 & 0 & 0 \
0 & 0 & 0 & 0 & 0 & 0 \
0 & 0 & 0 & 0 & 0 & 0
\end{bmatrix} $$ 直接把过滤器矩阵顺时针转90度就行: $$ K =
\begin{bmatrix}
1 & 1 & 1 \
0 & 0 & 0 \
-1 & -1 & -1
\end{bmatrix} $$ 卷积出的结果是: $$ \begin{bmatrix}
0 & 0 & 0 & 0 \
60 & 60 & 60 & 60 \
60 & 60 & 60 & 60 \
0 & 0 & 0 & 0
\end{bmatrix} $$
2.1.4. 卷积神经网络的核心
发现了吗?使用卷积找特征的核心在于确定过滤器的值。那我们该如何找到合适的过滤器值呢?这时候就需要结合神经网络了。
卷积神经网络的核心就是计算机根据样本图片,自动寻找合适的轮廓过滤器,对新图片进行轮廓匹配。
不仅如此,现实生活中很多图像都是RGB彩色图,我们可能会需要多个过滤器来寻找特征。RGB图像的卷积:对R\G\B三个通道分别求卷积再相加。
2.1.5. 池化层实现维度缩减
池化(Pooling)指的是按照一个固定规则对图像矩阵进行处理,将其转换为更低维度的矩阵。
最常用的规则只有两个:最大法和平均法。
最大法池化(Max-pooling)
最大化指的是在指定大小的区域(被称为池化尺寸)中选取最大的那个值作为代表这一整个区域的代表值。
比如说: $$ \begin{bmatrix}
10 & 1 & 3 & 5 \
2 & 9 & 8 & 1 \
3 & 2 & 2 & 1 \
5 & 7 & 3 & 6
\end{bmatrix} $$ 我们以2乘2为池化尺寸,以$(2, 2)$为窗口滑动步长(英文中称为Stride)。
- $(2, 2)$指的是扫描完一个区域之后横向移动2个单位,换行时纵向移动2个单位
最后的结果就是: $$ \begin{bmatrix}
10 & 8 \
7 & 6
\end{bmatrix} $$
最大法池化的好处在于能够保留核心的信息。
平均法池化(Avg-pooling)
还是一样的数据: $$ \begin{bmatrix}
10 & 1 & 3 & 5 \
2 & 9 & 8 & 1 \
3 & 2 & 2 & 1 \
5 & 7 & 3 & 6
\end{bmatrix} $$ 平均池化法会在池化区域里算所有值的平均值作为这个区域的代表值。
如果我们依然以2乘2为池化尺寸,以$(2, 2)$为窗口滑动步长,这样算出来的结果是: $$ \begin{bmatrix}
5.5 & 4.25 \
4.25 & 3
\end{bmatrix} $$
大多数情况下使用最大法池化最好,因为能够保持特征信息。
2.1.6. 卷积神经网络(Convolutional Neural Network)
这篇文章的标题是卷积神经网络,我们到现在都还没有提及到这个名字,那什么是到底什么是卷积神经网络呢?
卷积神经网络(Convolutional Neural Network,简称CNN)就是把我们上面涉及的一系列操作连接到一起形成的模型:
- 卷积
- 池化
- MLP
我们来举个例走全流程,假如我有如下数据: $$ A =
\begin{bmatrix}
20 & 0 & 0 & 0 & 0 & 0 & 0 \
20 & 0 & 0 & 0 & 0 & 0 & 0 \
20 & 0 & 0 & 0 & 0 & 0 & 0 \
0 & 0 & 0 & 0 & 0 & 0 & 0 \
0 & 0 & 0 & 0 & 0 & 0 & 0 \
0 & 0 & 0 & 0 & 0 & 0 & 0 \
0 & 0 & 0 & 0 & 0 & 0 & 0
\end{bmatrix} $$
然后我想要提取竖向轮廓,就使用竖向轮廓过滤器: $$ K =
\begin{bmatrix}
1 & 0 & -1 \
1 & 0 & -1 \
1 & 0 & -1
\end{bmatrix} $$ 这样子卷积出来的值就是(7×7 输入、3×3 滤波器、无填充时得到 5×5 特征图): $$ \begin{bmatrix}
60 & 0 & 0 & 0 & 0 \
40 & 0 & 0 & 0 & 0 \
20 & 0 & 0 & 0 & 0 \
0 & 0 & 0 & 0 & 0 \
0 & 0 & 0 & 0 & 0
\end{bmatrix} $$
然后我们以2乘2为池化尺寸,以$(2, 2)$为窗口滑动步长进行最大法池化,得出的结果是: $$ \begin{bmatrix}
60 & 0 \
20 & 0
\end{bmatrix} $$ 最后把二维数组展开成一维数组,再根据实际需求建立MLP模型即可。可以看到最底层仍然需要MLP,只是多了数据预处理降维操作。
需要注意的是,在完成卷积处理进行池化之前,我们一般还会使用激活函数,通过激活函数可以:
- 使部分神经元为0,防止过拟合
- 助于模型的求解
我们一般选用ReLU函数作为激活函数。
2.1.7. ReLU(Rectified Linear Unit)函数
ReLU函数本身非常简单: $$ f(x) = max(x, 0) $$
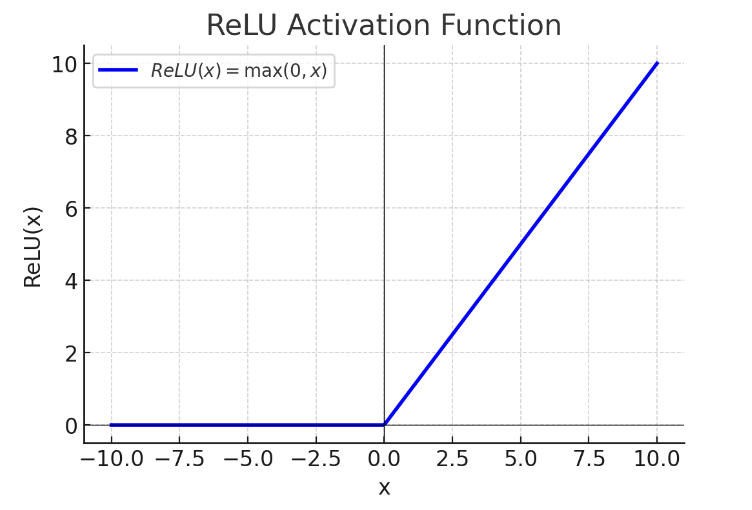
数据小于等于0时就取0,大于0就保持原数据不变。这样的特性可以:
- 让卷积层输出变得更加稀疏(许多值变为 0),减少冗余信息,使得后续池化层只关注有意义的激活
- 抑制噪声,减少负值带来的干扰,使模型更稳定
其实说到这里ReLU函数能做的逻辑函数(Sigmoid)也能做,那为什么不使用Sigmoid呢?这是为了防止梯度消失: • Sigmoid: 在$x \to +\infty$或$x \to -\infty$时,梯度接近$0$,容易出现梯度消失 • ReLU: 只要$x > 0$,梯度为$1$,保持梯度流动
2.1.8. 卷积神经网络的两大特点
- 参数共享(parameter sharing):同一个特征过滤器可用于整张图片
- 稀疏连接(sparsity of connections):生成的特征图片每个节点只与原图片中特定节点连接
2.2. 卷积神经网络(CNN)模型理论(进阶):图像填充、LeNet、AlexNet
本文紧承上一篇文章 2.1. 卷积神经网络(CNN)模型理论(基础):卷积运算、池化、ReLU函数,没看过的建议先看前文。
2.2.1. 图像填充(Padding)
卷积运算会带来两个问题:
- 图像被压缩,造成信息丢失:卷积后的图像小于原图像
- 边缘信息使用少,容易被忽略:中间的像素在卷积时会被反复计算,而边缘的像素只会被计算一次
针对这类问题我们会使用图像填充(Padding):通过在图像各边增加像素,使其在进行卷积运算后维持原图大小。填充的像素量由过滤器尺寸和窗口滑动步长(Stride) 决定,使卷积后的图像与原图像大小一致。
- 添加的像素值为0,这样才不会改变原图已有信息。
比如说我有一个5乘5的图像,过滤器尺寸为3乘3,窗口滑动步长为$(1,1)$,我应该填充多少像素呢?
输出尺寸由以下公式计算: $$ O = \frac{(I - K + 2P)}{S} + 1 $$
其中:
- I是输入尺寸(5×5)
- K是滤波器尺寸(3×3)
- P是每一侧的填充量(上/下或左/右);公式中出现 $2P$,是因为两侧都要填充
- S是步长(1×1)
如果希望输出尺寸仍然为$5 \times 5$,我们设$O = 5$,$K = 3$,解方程: $$ 5 = \frac{(5 - 3 + 2P)}{1} + 1 $$ 得到$P = 1$。也就是说,每一侧填充 1 像素,单个维度上的总填充量为 $2P = 2$。
如果某个维度所需的总填充量为奇数,就不能在两侧均匀分配,因此需要决定在哪一侧多填充1像素。常见做法是让右/下多填充一个像素,因为在某些深度学习框架(如 TensorFlow)中,默认使用的是“下/右多填充”策略。
2.2.2. 经典CNN模型
在上一篇文章(2.1. 卷积神经网络(CNN)模型理论(基础):卷积运算、池化、ReLU函数)中,我们提到了CNN就是把这一系列操作连接到一起形成的模型:
- 卷积
- 池化
- MLP
那么具体的顺序是什么样的呢?有没有需要重复执行的步骤呢?这些我们需要看看前人所写出的CNN模型是什么样的。
LeNet-5
LeNet-5是Yann LeCun等人在 1998 年提出的经典卷积神经网络(CNN)架构,主要用于手写数字识别(如 MNIST 数据集)。
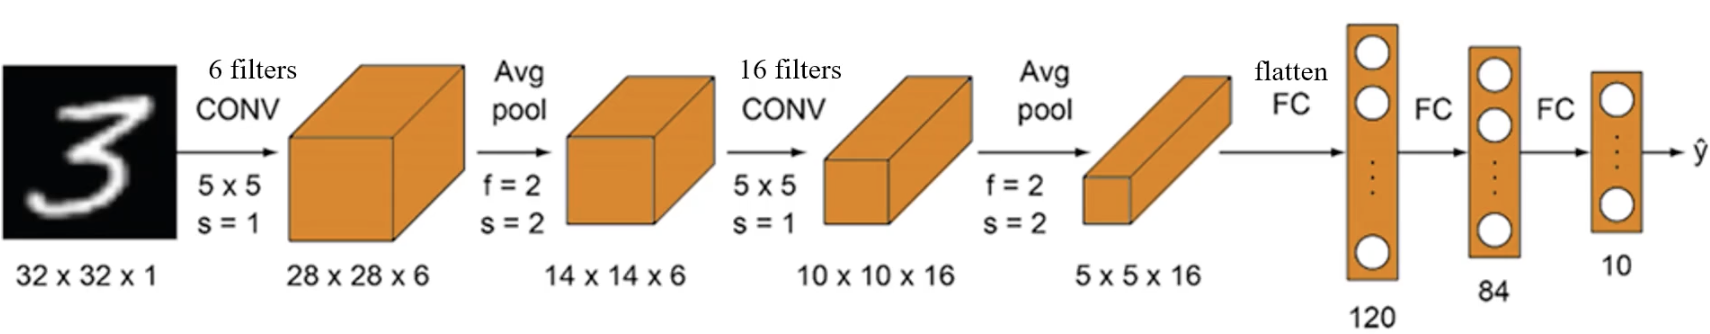
输入层(Input Layer)
- 尺寸:$32 \times 32$ 灰度图像(MNIST 原始大小是 $28 \times 28$,会被填充至 $32 \times 32$)
- 通道数:1(灰度图)
第一层:卷积层 C1(Convolutional Layer)
- 输入尺寸:$32 \times 32 \times 1$
- 滤波器(Kernel):6 个 $5 \times 5$ 卷积核(stride=1,valid padding)
- 计算公式:
$O = \frac{(I - K + 2P)}{S} + 1 = \frac{(32 - 5 + 0)}{1} + 1 = 28$
- 输出尺寸:$28 \times 28 \times 6$(6 个特征图)
- 激活函数:Sigmoid(现代 CNN 可能用 ReLU)
第二层:池化层 S2(Subsampling / Pooling Layer)
-
输入尺寸:$28 \times 28 \times 6$
-
操作:$2 \times 2$ 平均池化(stride=2)
-
计算公式: $O = \frac{(I - K)}{S} + 1 = \frac{(28 - 2)}{2} + 1 = 14$
-
输出尺寸:$14 \times 14 \times 6$(池化后减小尺寸)
-
激活函数:Sigmoid
第三层:卷积层 C3(Convolutional Layer)
-
输入尺寸:$14 \times 14 \times 6$
-
滤波器:16 个 $5 \times 5$ 过滤器
-
计算公式: $O = \frac{(I - K + 2P)}{S} + 1 = \frac{(14 - 5 + 0)}{1} + 1 = 10$
-
输出尺寸:$10 \times 10 \times 16$
-
激活函数:Sigmoid
-
连接方式:不是全连接,部分特征图相连(减少参数)
第四层:池化层 S4(Subsampling / Pooling Layer)
-
输入尺寸:$10 \times 10 \times 16$
-
操作:$2 \times 2$ 平均池化(stride=2)
-
计算公式: $O = \frac{(10 - 2)}{2} + 1 = 5$
-
输出尺寸:$5 \times 5 \times 16$
-
激活函数:Sigmoid
第五层:全连接层 C5(Fully Connected Layer)
- 输入尺寸:$5 \times 5 \times 16 = 400$ 个神经元
- 输出神经元:120(全连接)
- 激活函数:Sigmoid
第六层:全连接层 F6(Fully Connected Layer)
- 输入神经元:120
- 输出神经元:84
- 激活函数:Sigmoid
输出层(Output Layer)
- 输入神经元:84
- 输出神经元:10(对应 0-9 类别)
- 激活函数:Softmax(用于分类任务)
用一张表格来总结:
| 层次 | 说明 | 输入尺寸 | 输出尺寸 | 核大小 | 激活 |
|---|---|---|---|---|---|
| 输入层 | 灰度图像 | $32 \times 32 \times 1$ | $32 \times 32 \times 1$ | - | - |
| C1卷积 | 6 个$5 \times 5$过滤器 | $32 \times 32 \times 1$ | $28 \times 28 \times 6$ | $5 \times 5$ | Sigmoid |
| S2池化 | 平均池化$2 \times 2$ | $28 \times 28 \times 6$ | $14 \times 14 \times 6$ | $2 \times 2$ | Sigmoid |
| C3卷积 | 16 个$5 \times 5$过滤器 | $14 \times 14 \times 6$ | $10 \times 10 \times 16$ | $5 \times 5$ | Sigmoid |
| S4池化 | 平均池化 $2 \times 2$ | $10 \times 10 \times 16$ | $5 \times 5 \times 16$ | $2 \times 2$ | Sigmoid |
| C5全连接 | 400 个输入神经元 | $5 \times 5 \times 16 = 400$ | 120 | - | Sigmoid |
| F6全连接 | 120 个输入神经元 | 120 | 84 | - | Sigmoid |
| 输出层 | Softmax 分类 | 84 | 10 | - | Softmax |
输入图像:32X32灰度图,1个通道(channel)灰度图 训练参数:约60,000个 特点:
- 随着网络越深,图像的高度和宽度在缩小,通道数在增加
- 卷积与池化一组一组成对使用
AlexNet
随着科学的进步,计算机的算力和数学理论知识都在发展,LeNet已经被淘汰了,而它的继任者就是AlexNet。
AlexNet 由 Alex Krizhevsky 等人于 2012 年提出,并在ImageNet竞赛(ILSVRC-2012)中取得巨大成功,被认为是现代深度学习的奠基之作。它相比 LeNet-5更深、更宽,并引入了新的技术,如ReLU 激活函数、重叠池化、Dropout 和数据增强,极大地提高了 CNN 在大规模数据集上的表现。
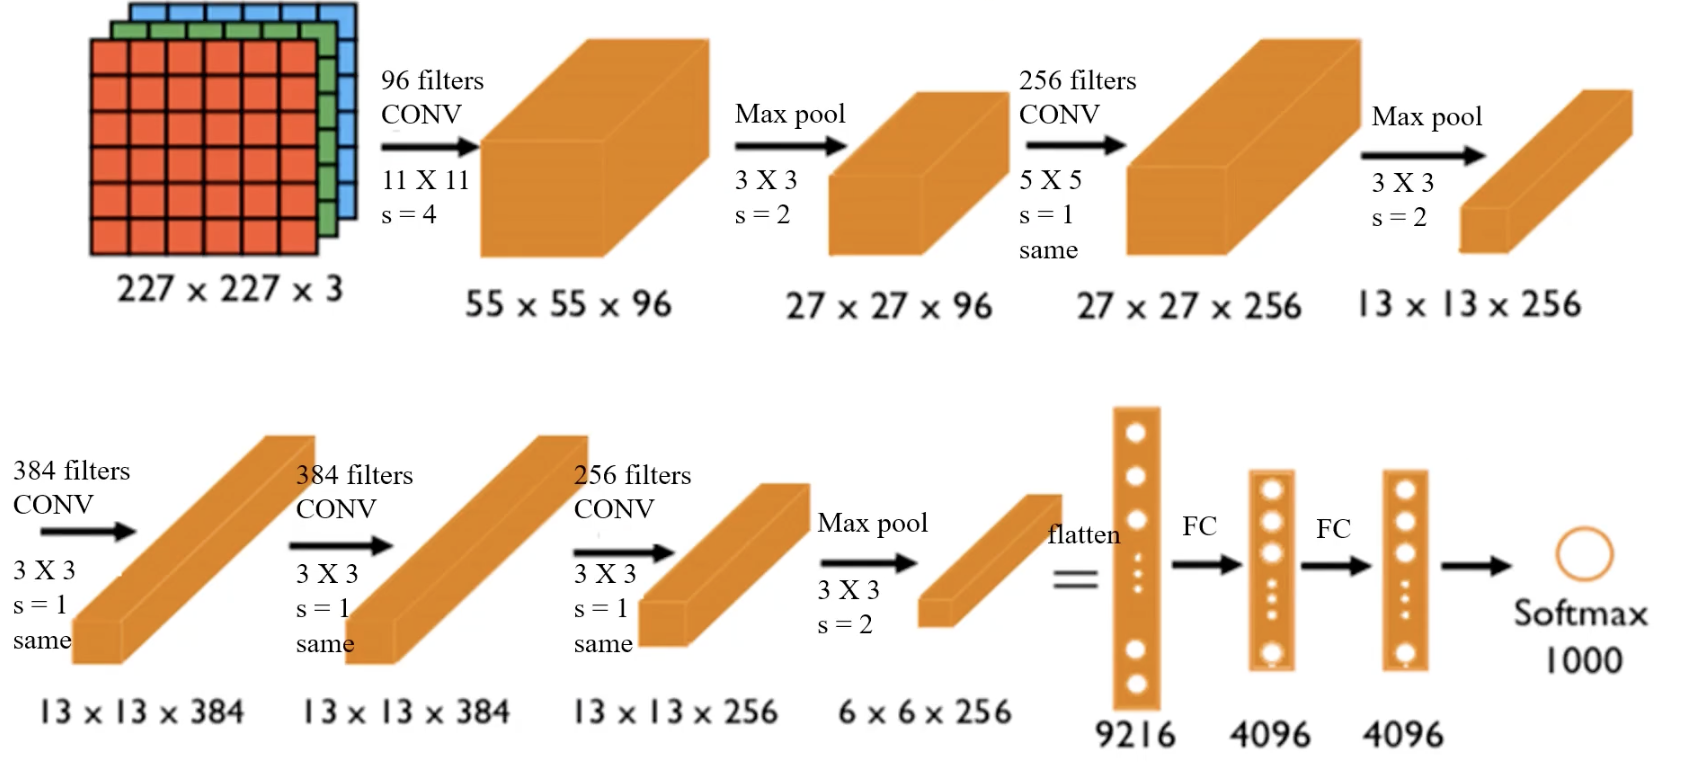
输入层(Input Layer)
- 尺寸:$227 \times 227 \times 3$(RGB 图像)
- 预处理:减去均值归一化
第一层:卷积层Conv1
-
输入尺寸:$227 \times 227 \times 3$
-
滤波器(Kernel):96 个 $11 \times 11$ 过滤器,步长 S = 4
-
填充(Padding):0(valid)
-
计算公式: $O = \frac{(I - K + 2P)}{S} + 1 = \frac{(227 - 11 + 0)}{4} + 1 = 55$
-
输出尺寸:$55 \times 55 \times 96$
-
激活函数:ReLU
-
特性:
- 大卷积核 $11 \times 11$,步长 4,加速特征提取
- ReLU 代替 Sigmoid,加快收敛速度
- Local Response Normalization(LRN):增强对比度
第二层:最大池化层 Pool1
-
输入尺寸:$55 \times 55 \times 96$
-
池化方式:$3 \times 3$ 最大池化,步长 2
-
计算公式: $O = \frac{(55 - 3)}{2} + 1 = 27$
-
输出尺寸:$27 \times 27 \times 96$
第三层:卷积层 Conv2
-
输入尺寸:$27 \times 27 \times 96$
-
滤波器:256 个 $5 \times 5$ 卷积核,步长 1,填充 2
-
计算公式: $O = \frac{(27 - 5 + 2 \times 2)}{1} + 1 = 27$
-
输出尺寸:$27 \times 27 \times 256$
-
激活函数:ReLU
-
LRN 归一化
-
特性:
- 较小卷积核 $5 \times 5$,捕捉更细粒度特征
- 归一化增加泛化能力
第四层:最大池化层 Pool2
-
输入尺寸:$27 \times 27 \times 256$
-
池化方式:$3 \times 3$ 最大池化,步长 2
-
计算公式: $O = \frac{(27 - 3)}{2} + 1 = 13$
-
输出尺寸:$13 \times 13 \times 256$
第五层:卷积层 Conv3
-
输入尺寸:$13 \times 13 \times 256$
-
滤波器:384 个 $3 \times 3$ 过滤器,步长 1,填充 1
-
计算公式: $O = \frac{(13 - 3 + 2 \times 1)}{1} + 1 = 13$
-
输出尺寸:$13 \times 13 \times 384$
-
激活函数:ReLU
-
特性:进一步提取更高级别的特征
第六层:卷积层 Conv4
-
输入尺寸:$13 \times 13 \times 384$
-
滤波器:384 个 $3 \times 3$ 过滤器,步长 1,填充 1
-
计算公式: $O = 13$
-
输出尺寸:$13 \times 13 \times 384$
-
激活函数:ReLU
-
特性:继续提取特征,提升层次信息
第七层:卷积层 Conv5
-
输入尺寸:$13 \times 13 \times 384$
-
滤波器:256 个 $3 \times 3$ 过滤器,步长 1,填充 1
-
计算公式: $O = 13$
-
输出尺寸:$13 \times 13 \times 256$
-
激活函数:ReLU
第八层:最大池化层 Pool3
-
输入尺寸:$13 \times 13 \times 256$
-
池化方式:$3 \times 3$ 最大池化,步长 2
-
计算公式: $O = \frac{(13 - 3)}{2} + 1 = 6$
-
输出尺寸:$6 \times 6 \times 256$
第九层:全连接层 FC6
-
输入:$6 \times 6 \times 256 = 9216$ 个神经元
-
输出:4096 个神经元
-
激活函数:ReLU
-
特性:Dropout(0.5)防止过拟合
第十层:全连接层 FC7
-
输入:4096 个神经元
-
输出:4096 个神经元
-
激活函数:ReLU
-
特性:Dropout(0.5)
第十一层:输出层(FC8 + Softmax)
- 输入:4096 个神经元
- 输出:1000 个类别(ImageNet 数据集)
- 激活函数:Softmax
图表总结:
| 层次 | 说明 | 输入尺寸 | 输出尺寸 | 过滤器 | 步长 | 填充 | 激活 |
|---|---|---|---|---|---|---|---|
| 输入层 | RGB 图像 | $227 \times 227 \times 3$ | $227 \times 227 \times 3$ | - | - | - | - |
| Conv1 | $11 \times 11$ 卷积 | $227 \times 227 \times 3$ | $55 \times 55 \times 96$ | $11 \times 11$ | 4 | 0 | ReLU |
| Pool1 | 最大池化 | $55 \times 55 \times 96$ | $27 \times 27 \times 96$ | $3 \times 3$ | 2 | - | - |
| Conv2 | $5 \times 5$ 卷积 | $27 \times 27 \times 96$ | $27 \times 27 \times 256$ | $5 \times 5$ | 1 | 2 | ReLU |
| Pool2 | 最大池化 | $27 \times 27 \times 256$ | $13 \times 13 \times 256$ | $3 \times 3$ | 2 | - | - |
(后续层类同)
输入图像:$227 \times 227 \times 3$ RGB图,3个通道 训练参数:约60,000,000个(已经预训练好了,可以直接用)
特点:
- 适用于识别较为复杂的彩色图,可识别1000种类别
- 结构比LeNet更为复杂,使用ReLU作为激活函数
VGG-16
VGG-16(Visual Geometry Group 16-layer)由牛津大学 VGG 组在2014年提出,并在ImageNet竞赛中取得了优异成绩。其核心特点是:
- 全部采用 $3 \times 3$ 卷积核,增加深度,同时减少参数量。
- 多次地使用$3 \times 3$小卷积核(一个卷积块中会有2~3次卷积)代替大卷积核(如 $5 \times 5$ 或 $7 \times 7$),提升模型表达能力。
- 使用 ReLU 作为激活函数,加速训练并缓解梯度消失问题。
- 全连接层采用 Dropout 进行正则化,减少过拟合。
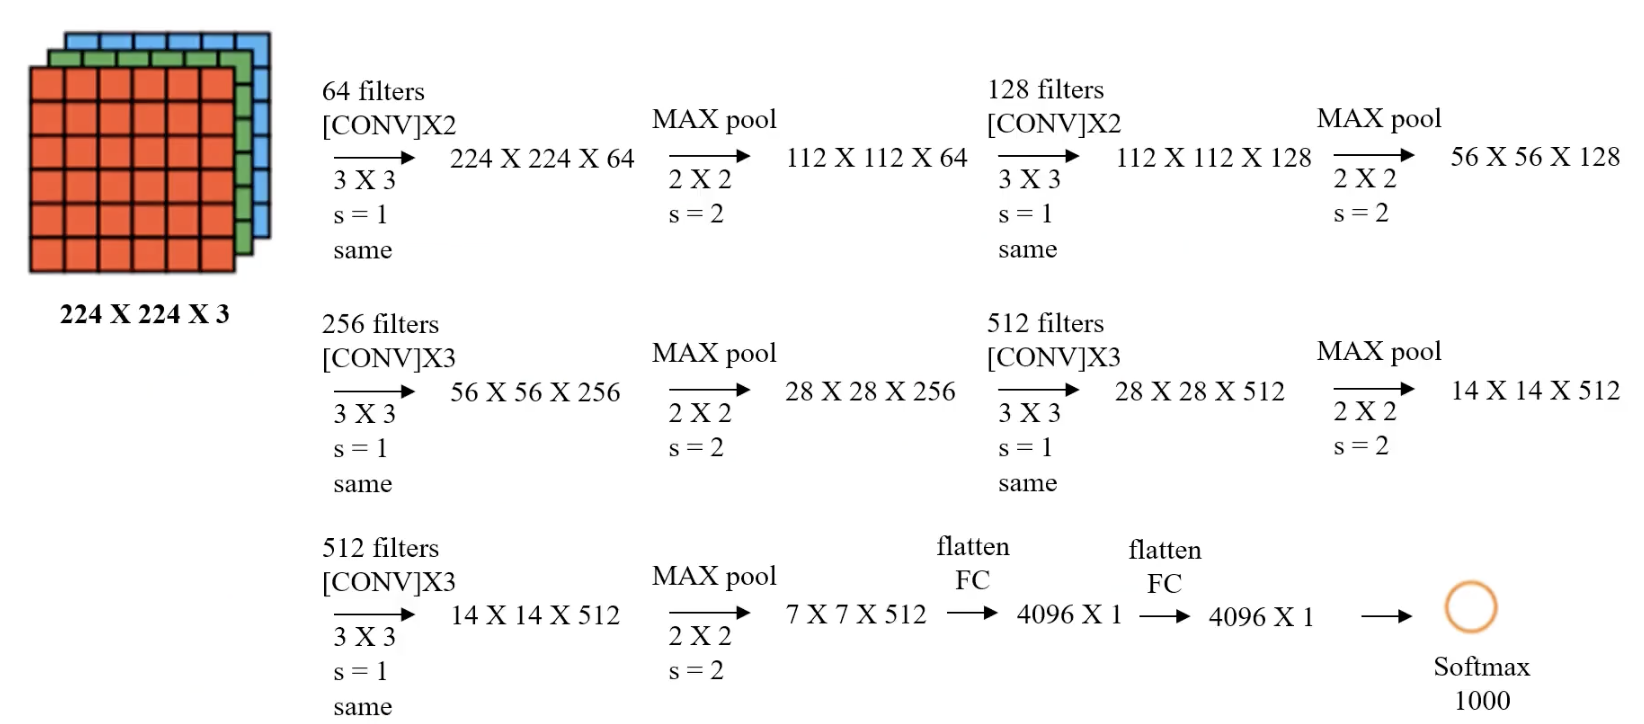
输入层(Input Layer)
- 尺寸:$224 \times 224 \times 3$(RGB 图像)
- 预处理:
- 归一化
- 减去均值(ImageNet 数据集的均值)
卷积块 1(Conv Block 1)
- 输入尺寸:$224 \times 224 \times 3$
- Conv1-1:$3 \times 3$ 卷积,64 个过滤器,步长 1,填充 1
- Conv1-2:$3 \times 3$ 卷积,64 个过滤器,步长 1,填充 1
- 池化层(Max Pooling):$2 \times 2$,步长 2
计算: $\frac{224 - 3 + 2}{1} + 1 = 224$ $\frac{224 - 2}{2} + 1 = 112$
- 输出尺寸:$112 \times 112 \times 64$
卷积块 2(Conv Block 2)
- 输入尺寸:$112 \times 112 \times 64$
- Conv2-1:$3 \times 3$ 卷积,128 个过滤器
- Conv2-2:$3 \times 3$ 卷积,128 个过滤器
- 池化层:$2 \times 2$,步长 2
- 输出尺寸:$56 \times 56 \times 128$
卷积块 3(Conv Block 3)
- 输入尺寸:$56 \times 56 \times 128$
- Conv3-1:$3 \times 3$ 卷积,256 个过滤器
- Conv3-2:$3 \times 3$ 卷积,256 个过滤器
- Conv3-3:$3 \times 3$ 卷积,256 个过滤器
- 池化层:$2 \times 2$,步长 2
- 输出尺寸:$28 \times 28 \times 256$
卷积块 4(Conv Block 4)
- 输入尺寸:$28 \times 28 \times 256$
- Conv4-1:$3 \times 3$ 卷积,512 个过滤器
- Conv4-2:$3 \times 3$ 卷积,512 个过滤器
- Conv4-3:$3 \times 3$ 卷积,512 个过滤器
- 池化层:$2 \times 2$,步长 2
- 输出尺寸:$14 \times 14 \times 512$
卷积块 5(Conv Block 5)
- 输入尺寸:$14 \times 14 \times 512$
- Conv5-1:$3 \times 3$ 卷积,512 个过滤器
- Conv5-2:$3 \times 3$ 卷积,512 个过滤器
- Conv5-3:$3 \times 3$ 卷积,512 个过滤器
- 池化层:$2 \times 2$,步长 2
- 输出尺寸:$7 \times 7 \times 512$
全连接层(Fully Connected Layers)
-
FC1
- 输入尺寸:$7 \times 7 \times 512 = 25088$
- 神经元数:4096
- 激活函数:ReLU
- Dropout:0.5
-
FC2
- 输入尺寸:4096
- 神经元数:4096
- 激活函数:ReLU
- Dropout:0.5
-
输出层(FC3 + Softmax)
- 输入尺寸:4096
- 输出尺寸:1000(ImageNet 分类)
- 激活函数:Softmax
用图表总结:
| 层次 | 说明 | 输入尺寸 | 输出尺寸 | 过滤器 | 步长 | 填充 | 激活 |
|---|---|---|---|---|---|---|---|
| 输入层 | RGB 图像 | $224 \times 224 \times 3$ | $224 \times 224 \times 3$ | - | - | - | - |
| Conv1-1 | $3 \times 3$ 卷积 | $224 \times 224 \times 3$ | $224 \times 224 \times 64$ | 64 | 1 | 1 | ReLU |
| Conv1-2 | $3 \times 3$ 卷积 | $224 \times 224 \times 64$ | $224 \times 224 \times 64$ | 64 | 1 | 1 | ReLU |
| Pool1 | 最大池化 | $224 \times 224 \times 64$ | $112 \times 112 \times 64$ | $2 \times 2$ | 2 | 0 | - |
| Conv2-1 | $3 \times 3$ 卷积 | $112 \times 112 \times 64$ | $112 \times 112 \times 128$ | 128 | 1 | 1 | ReLU |
| Conv2-2 | $3 \times 3$ 卷积 | $112 \times 112 \times 128$ | $112 \times 112 \times 128$ | 128 | 1 | 1 | ReLU |
| Pool2 | 最大池化 | $112 \times 112 \times 128$ | $56 \times 56 \times 128$ | $2 \times 2$ | 2 | 0 | - |
(后续层类同)
输入图像:$224 \times 224 \times 3$ RGB图,3个通道 训练参数:约138,000,000个
特点:
- 所有卷积层 filter 宽和高都是 3,步长为 1,填充为 1(“same”卷积),保持每一次卷积后的空间尺寸不变
- 所有池化层的filter宽和高都是 2,步长都是2
- 相比AlexNet,有更多的filter用于提取轮廓信息,具有更高精准性
使用经典CNN模型面对新场景
我们如何利用这些已经被验证表现非常出色的经典CNN模型来面对新场景呢?
-
使用经典的CNN模型结构对图像预处理,再建立MLP模型(最常用):
- 加载经典的CNN模型,剥除其FC层(全连阶层),对图像进行预处理
- 把预处理完成的数据作为输入,分类结果为输出,建立一个MLP模型
- 模型训练
-
参考经典的CNN结构搭建新模型: 从前文所述两个模型我们可以看出卷积和池化放在一起的效果一般都挺好的,所以在新模型中我们也可以把卷积和池化放在一起,那主要问题就会变为如何微调参数,比如过滤器的尺寸这类的。
我们以前者举个例子:
假如我现在需要在VGG16模型基础上,对猫狗的照片进行二分类识别,我会怎么构建二分类模型呢?
- 删去原本模型中MLP部分
- 保留VGG16前面提取图片特征的部分
- 自己训练MLP模型
2.3. 卷积神经网络(CNN)实战(基础):猫狗照片二分类
本文承接 2.2. 卷积神经网络(CNN)模型理论(进阶):图像填充、LeNet、AlexNet,没看过的建议先看前文。
2.3.1. 准备工作
请在终端输入指令以下载和安装:
pip install keras tensorflow
我们的任务是对猫狗进行二分类,会使用到猫狗的照片,这里我们使用Kaggle数据集,各位可以到 kaggle数据集、mnist数据集、imdb数据集分享 这个帖子中找到下载链接,下载好后要先解压。在train文件夹中,创建cat和dog两个文件夹,把猫的照片放到cat中,把狗的照片放到dog中,最后的路径应该长这样:
.\train
	\train
		\dog
			\dog.0.jpg
			\dog.1.jpg
			\dog.2.jpg
			...
		\cat
			\cat.0.jpg
			\cat.1.jpg
			\cat.2.jpg
			...
把train文件夹直接拖入Python项目文件夹中即可。
2.3.2. 整体架构
以下是我们的卷积神经网络整体模型:
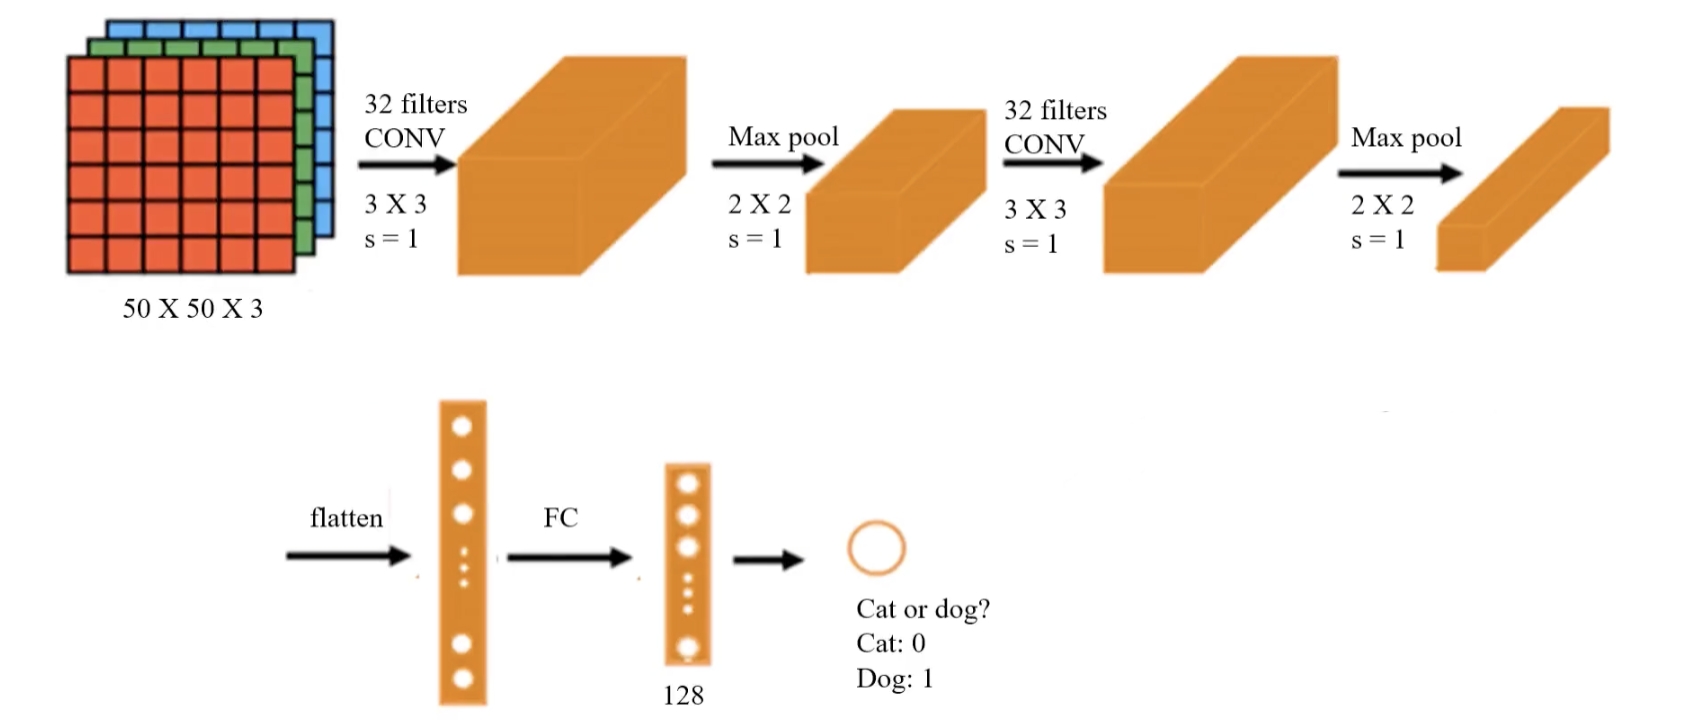
- 输入层:
- 输入尺寸为 50 × 50 × 3,表示输入图像为 50×50 像素,并具有 3 个通道(RGB 彩色图像)。
- 第一层卷积(Conv Layer 1):
- 使用 32 个 3×3 卷积核,步长 (stride) = 1。
- 这一层提取低级特征,如边缘、纹理等。
- 卷积层采用ReLU函数
- 第一层池化(Max Pooling 1):
- 池化核大小 2×2,步长 = 2(Keras 默认:步长等于
pool_size)。 - 通过最大池化减少特征图的尺寸,提高计算效率,并增强特征的鲁棒性。
- 第二层卷积(Conv Layer 2):
- 再次使用 32 个 3×3 卷积核,步长 = 1。
- 继续提取更高级的特征,如轮廓、形状等。
- 卷积层采用ReLU函数
- 第二层池化(Max Pooling 2):
- 池化核大小 2×2,步长 = 2。
- 进一步降低特征图的尺寸,减少计算量。
- Flatten 层:
- 经过两次卷积和池化后,特征图被展平成一维向量,以便输入到全连接层。
- 全连接层(Fully Connected, FC):
- 经过一个 128 维的全连接层,用于学习最终的分类决策。
- 输出层:
- 最终输出是一个 单神经元,表示二分类问题(猫或狗)。
- 输出 0 表示猫,输出 1 表示狗。
2.3.3. 敲代码
Step 1: 加载图片与预处理
# 图片加载与预处理
from keras.preprocessing.image import ImageDataGenerator

train_datagen = ImageDataGenerator(rescale=1./255)
training_set = train_datagen.flow_from_directory('.\\train\\train',
                                                 target_size=(50, 50),
                                                 batch_size=128,
                                                 class_mode='binary')
-
ImageDataGenerator是一个用于图片数据增强和预处理的工具,它能够通过一系列的数据变换(如旋转、平移、缩放等)生成更丰富的训练数据,从而提高深度学习模型的泛化能力。 -
train_datagen是一个ImageDataGenerator的实例:rescale=1./255是对图片像素值进行缩放处理。原始图片的像素值通常在范围[0, 255]之间。通过设置这个参数,将像素值归一化到[0, 1]区间以便于更快收敛和更稳定的训练。ImageDataGenerator的参数不止这些,还可以进行缩放、平移、旋转等…
-
通过调用
flow_from_directory()方法,从指定的目录中加载图片数据并准备训练数据集:target_size参数指定图片在加载时的目标尺寸。这个参数会将所有图片调整为一致的大小(在这里是 50x50 像素)。batch_size参数指定每次从生成器中加载的图片批量大小:在深度学习中,训练数据通常会分成若干批次 (batch),这个参数定义了每一批次中包含的图片数量。在这里,batch_size=128表示生成器每次会生成 128 张图片数据以及对应的标签。较大的batch_size通常意味着更高的训练效率。但是如果你的显存太小,你也可以适当减小(32是一个很不错的配置),但会导致收敛不稳定的问题。class_mode参数设定为'binary',表示这是一个二分类问题,生成的标签会是二值化的(即 0 或 1)。如果设定为'categorical': 用于多分类问题,标签会使用one-hot编码,例如[1, 0, 0]表示属于第一类。如果设定为'sparse': 类似于'categorical',但标签是整数值,而不是 one-hot 编码,比如0、1、2。如果设定为None: 表示不返回标签,通常用于无监督学习或者预测(Inference)阶段。
注意,上面的路径写法是Windows下的。如果你在MacOS/Linux,请使用./train/train。
Step 2: 建立CNN模型
根据上图的架构我们来建立CNN模型:
# 建立模型
from keras.models import Sequential
from keras.layers import Conv2D, MaxPooling2D, Flatten, Dense

model = Sequential()
# 卷积层
model.add(Conv2D(32, (3,3), input_shape=(50,50,3), activation='relu'))
# 池化层
model.add(MaxPooling2D(pool_size=(2,2)))
卷积层 (Conv2D) 的参数说明:
32(filters):- 表示这一层使用了 32 个卷积核(filter)。
- 每个卷积核会提取不同的特征,因此提取的特征图数量与卷积核的数量相同。最终输出为 32 个特征图。
(3, 3):- 指定卷积核的大小为 3x3 像素(通常取小值,如
(3, 3)或(5, 5))。 - 卷积核会在输入图片上滑动,提取局部特征。
- 指定卷积核的大小为 3x3 像素(通常取小值,如
input_shape=(50,50,3):- 表示输入数据的形状:
50x50是图片的分辨率(宽、高)。3是通道数,通常图片有 3 个颜色通道(RGB)。这是 CNN 的输入要求,你在数据预处理时必须确保图片数据符合该形状。
- 表示输入数据的形状:
activation='relu':激活函数使用了 ReLU(Rectified Linear Unit),它将负值变为 0,而正值保持不变。
池化层 (MaxPooling2D) 的参数说明:
pool_size=(2,2):- 指定池化操作的窗口大小为 2x2 像素。
- 具体操作:在每个 2x2 的窗口中,保留最大值(即 Max Pooling),丢弃其他值。
- 池化会将图片的宽和高各缩小一半。在 valid 填充下,第一层卷积输出大小是
48x48,经过池化后就变成24x24。
到目前为止只写到了第一个卷积+池化层,我们继续写第二个卷积+池化层:
# 第二个卷积+池化层
model.add(Conv2D(32, (3,3), activation='relu'))
model.add(MaxPooling2D(pool_size=(2,2)))
- 这里的
Conv2D不需要input_shape参数是因为代码会自己推断出上一层的输出的是什么大小
至此我们对图像的特征提取操作就完成了,接下来我们把特征展开到一维以供MLP模型接收:
# flatten层
model.add(Flatten())
然后我们来写MLP模型的架构(两层全连接,隐藏层有128个神经元,输出层就1个神经元用于二分类):
# 全连接层
model.add(Dense(units=128, activation='relu'))
model.add(Dense(units=1, activation='sigmoid'))
Step 3: 训练模型
接下来的操作和单使用MLP模型时的操作一样,进行训练核心参数配置:
# 配置训练
model.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])

# 查看结构
model.summary()
-
compile是 Keras 模型的方法,用于在训练模型之前配置模型的学习过程,它的主要参数有:- 损失函数(
loss):定义模型训练时计算误差的方法。 - 优化器(
optimizer):决定模型的参数(如权重和偏置)如何更新,以最小化损失函数。 - 评估指标(
metrics):决定用于评估模型性能的指标,这些指标不会影响模型训练,只用于衡量效果。
- 损失函数(
-
loss='binary_crossentropy':binary_crossentropy(二元交叉熵)是二分类任务中常用的损失函数 -
optimizer='adam':adam(Adaptive Moment Estimation)是一种自适应学习率优化算法,是深度学习中最常用的优化器之一 -
metrics=['accuracy']:指定模型在训练和评估时用准确率来衡量性能
输出:
Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ conv2d (Conv2D)                 │ (None, 48, 48, 32)     │           896 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ max_pooling2d (MaxPooling2D)    │ (None, 24, 24, 32)     │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ conv2d_1 (Conv2D)               │ (None, 22, 22, 32)     │         9,248 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ max_pooling2d_1 (MaxPooling2D)  │ (None, 11, 11, 32)     │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ flatten (Flatten)               │ (None, 3872)           │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense (Dense)                   │ (None, 128)            │       495,744 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_1 (Dense)                 │ (None, 1)              │           129 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
 Total params: 506,017 (1.93 MB)
 Trainable params: 506,017 (1.93 MB)
 Non-trainable params: 0 (0.00 B)
接着把数据喂给模型即可:
# 训练模型
model.fit(training_set, epochs=25)
epochs确定模型的迭代次数
Step 4: 评估模型
我们来看看它对训练数据的预测准确率:
# 计算模型预测准确率
accuracy_train = model.evaluate(x=training_set)
print("\nAccuracy on training set: ", accuracy_train[1])
输出:
Accuracy on training set: 0.9990400075912476
可以看到正确率是非常高的。
2.4. 卷积神经网络(CNN)实战(进阶):使用VGG-16进行图像特征提取
本文承接 2.2. 卷积神经网络(CNN)模型理论(进阶):图像填充、LeNet、AlexNet,没看过的建议先看前文。
2.4.1. VGG-16的架构
在本文中我们会使用VGG-16进行图像特征提取,然后构建自己的二分类模型,我们先来回顾一下VGG-16模型的架构:
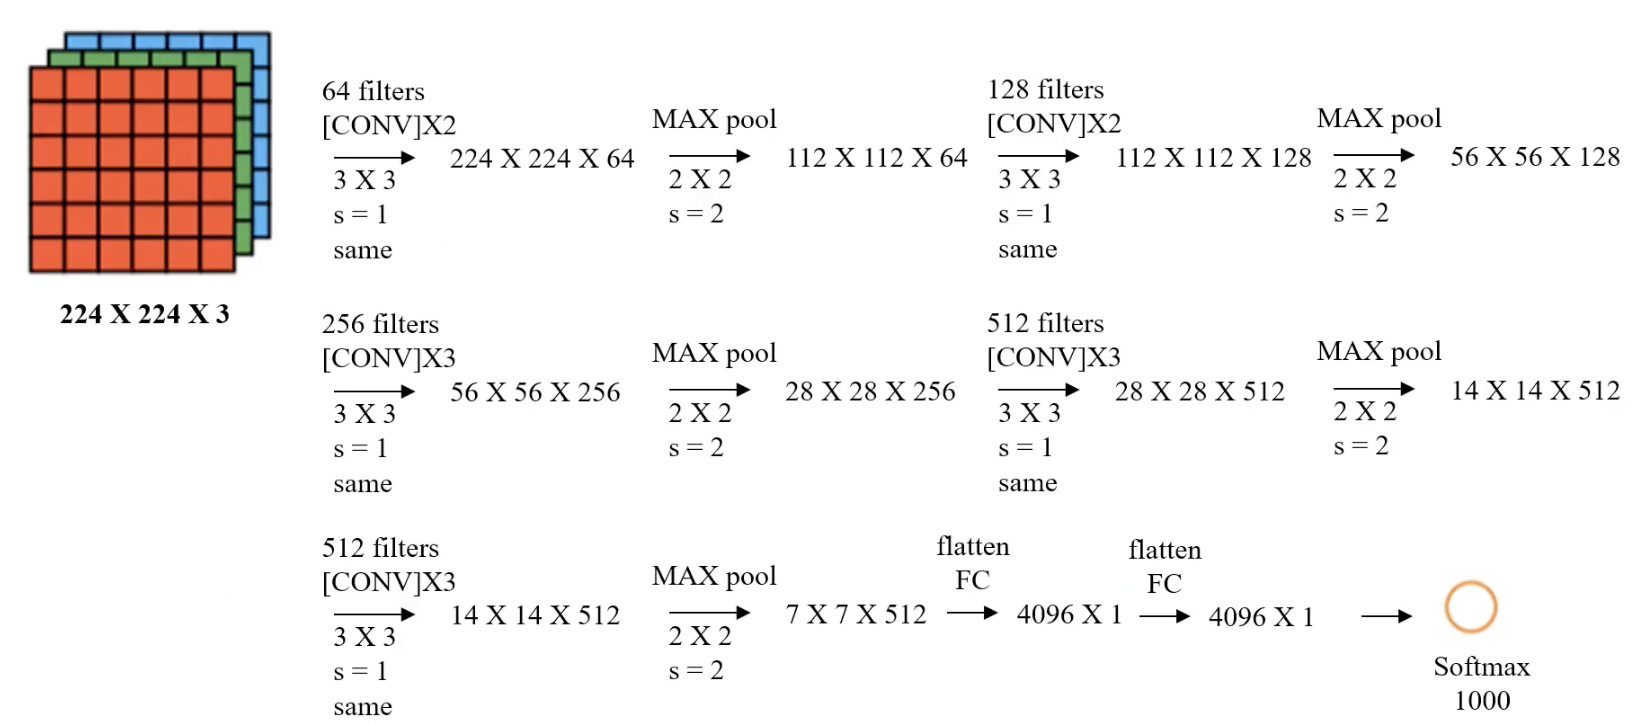
| 层次 | 说明 | 输入尺寸 | 输出尺寸 | 过滤器 | 步长 | 填充 | 激活 |
|---|---|---|---|---|---|---|---|
| 输入层 | RGB 图像 | $224 \times 224 \times 3$ | $224 \times 224 \times 3$ | - | - | - | - |
| Conv1-1 | $3 \times 3$ 卷积 | $224 \times 224 \times 3$ | $224 \times 224 \times 64$ | 64 | 1 | 1 | ReLU |
| Conv1-2 | $3 \times 3$ 卷积 | $224 \times 224 \times 64$ | $224 \times 224 \times 64$ | 64 | 1 | 1 | ReLU |
| Pool1 | 最大池化 | $224 \times 224 \times 64$ | $112 \times 112 \times 64$ | $2 \times 2$ | 2 | 0 | - |
| Conv2-1 | $3 \times 3$ 卷积 | $112 \times 112 \times 64$ | $112 \times 112 \times 128$ | 128 | 1 | 1 | ReLU |
| Conv2-2 | $3 \times 3$ 卷积 | $112 \times 112 \times 128$ | $112 \times 112 \times 128$ | 128 | 1 | 1 | ReLU |
| Pool2 | 最大池化 | $112 \times 112 \times 128$ | $56 \times 56 \times 128$ | $2 \times 2$ | 2 | 0 | - |
(后续层类同)
特征提取后,我们会自己构建MLP模型,有一层隐藏层,10个神经元。
2.4.2. 准备工作
请在终端输入指令以下载和安装:
pip install keras tensorflow scikit-learn
我们的任务是对猫狗进行二分类,会使用到猫狗的照片,这里我们使用Kaggle数据集,各位可以到 kaggle数据集、mnist数据集、imdb数据集分享 这个帖子中找到下载链接,下载好后要先解压。在train文件夹中,创建cat和dog两个文件夹,把猫的照片放到cat中,把狗的照片放到dog中,最后的路径应该长这样:
.\train
	\train
		\dog
			\dog.0.jpg
			\dog.1.jpg
			\dog.2.jpg
			...
		\cat
			\cat.0.jpg
			\cat.1.jpg
			\cat.2.jpg
			...
把train文件夹直接拖入Python项目文件夹中即可。
如果你要在本地实操这个项目,强烈建议在Linux环境下使用带有CUDA加速单元的英伟达GPU,或是AMD GPU手动开启ROCm(仅限Linux)。你当然可以在Windows环境下运行,但是现在的tensorflow不支持Windows平台的GPU加速,所以只能靠纯CPU运算,计算速度会慢很多。我用i9-13900kf要10+分钟,用M1 Max要30分钟。
AMD GPU开启ROCm需要安装适配ROCm的TensorFlow版本(仅支持Linux),可以通过pip直接安装:
pip install tensorflow-rocm
运行以下代码检查TensorFlow是否能检测到AMD GPU:
import tensorflow as tf
print("Num GPUs Available:", len(tf.config.list_physical_devices('GPU')))
2.4.3. 节省内存版代码
Step 1: 初始化VGG-16
# 初始化 VGG 模型(去掉全连接层 MLP)
from tensorflow.keras.applications.vgg16 import VGG16
model = VGG16(weights='imagenet', include_top=False)
weights='imagenet'表示加载的是基于 ImageNet 数据集预训练的权重include_top=False:- 表示不加载 VGG-16 的顶层全连接层(即分类部分),只保留卷积部分
- 这样处理的目的是将 VGG-16 作为一个特征提取器,提取高层次的卷积特征
Step 2: 加载图片
# 定义函数:加载与预处理单张图片
from tensorflow.keras.applications.vgg16 import preprocess_input
import numpy as np
from tensorflow.keras.preprocessing.image import img_to_array, load_img
def load_image_and_preprocess(image_path, model):
    """
    加载图片并进行预处理以适配 VGG 模型
    :param image_path: 图片路径
    :param model: VGG 模型实例
    :return: 预处理后的特征向量
    """
    img = load_img(image_path, target_size=(224, 224))  # 调整图片大小
    img = img_to_array(img)  # 转换为数组
    x = np.expand_dims(img, axis=0)  # 扩展维度以匹配模型输入格式
    x = preprocess_input(x)  # 应用预处理(均值中心化等处理)
    x_vgg = model.predict(x)  # 提取特征
    return np.reshape(x_vgg, (7 * 7 * 512))  # 展平特征

# 定义函数:处理单个文件夹的所有图片
import os
def process_folder(folder, model):
    """
    处理指定文件夹下的所有图片,提取特征向量
    :param folder: 图片文件夹路径
    :param model: VGG 模型实例
    :return: 提取的特征向量数组
    """
    # 获取所有 .jpg 文件路径
    img_paths = [
        os.path.join(folder, file)
        for file in os.listdir(folder)
        if file.endswith('.jpg')
    ]

    # 初始化特征数组(提取完特征之后的形状为 7*7*512)
    features = np.zeros((len(img_paths), 7 * 7 * 512))

    # 遍历所有文件路径,依次加载并提取特征
    for idx, path in enumerate(img_paths):
        features[idx] = load_image_and_preprocess(path, model)
        print(f"Preprocessed: {path}")

    return features, len(img_paths)

# 处理猫图片文件夹
cat_folder = "train/train/cat"
cat_features, cat_count = process_folder(cat_folder, model)  # 猫的特征和数量

# 处理狗图片文件夹
dog_folder = "train/train/dog"
dog_features, dog_count = process_folder(dog_folder, model)  # 狗的特征和数量
定义单张图片的加载与预处理函数 (load_image_and_preprocess):
- 加载指定路径的图片,调整为 VGG16 需要的输入尺寸 224x224。
- 将图片从 PIL 格式转换为 NumPy 数组,并扩展维度以匹配模型的输入格式(4D 张量)。
- 使用
preprocess_input对图片数据进行标准化(VGG16 需要特定格式的输入,如中心化操作)。 - 调用
model.predict使用 VGG16 模型提取特征,得到卷积层输出的特征图,大小为 (7, 7, 512)。 - 展平特征图为一维向量(7×7×512),为后续处理做准备。
定义文件夹中所有图片的处理函数 (process_folder):
- 遍历指定文件夹,筛选出所有以
.jpg结尾的图片文件路径。 - 初始化一个空的特征矩阵 (
features),其大小为 (图片数量, 7×7×512)。 - 对每张图片调用
load_image_and_preprocess,依次提取特征并存储到特征矩阵中。 - 返回提取的特征矩阵以及图片数量。
提取猫和狗图片的特征:
- 指定猫和狗图片存储的文件夹路径(
cat_folder和dog_folder)。 - 分别调用
process_folder对这两个文件夹进行处理,提取每张图片的特征向量,返回特征矩阵(cat_features和dog_features)以及对应的图片数量(cat_count和dog_count)。
Step 3: 生成对应标签
我们需要为训练数据和测试数据提供对应的标签:
# 生成对应的标签(猫为 0,狗为 1)
cat_labels = np.zeros((cat_count, 1))
dog_labels = np.ones((dog_count, 1))

# 合并猫和狗的特征与标签
X = np.concatenate((cat_features, dog_features), axis=0)
y = np.concatenate((cat_labels, dog_labels), axis=0)

# 打印结果信息
print(f"Feature shape: {X.shape}, Label shape: {y.shape}")
输出:
Feature shape: (25000, 25088), Label shape: (25000, 1)
Step 4: 数据分离
我们需要把数据分为训练集和测试集,训练集用于训练模型,测试集用于测试模型的准确率:
# 数据分离
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X,
                                                    y,
                                                    test_size=0.2,
                                                    random_state=50)
X: 输入特征矩阵。这里的X是通过 VGG-16 提取并展平后的图片特征,形状为(None, 7 * 7 * 512),用作训练和测试的特征集y: 标签值,即图片所属的类别。这里沿用前文生成的标签,猫为 0,狗为 1test_size=0.2: 表示测试集占整个数据集的比例。在此设置为 20%(即80%用作训练集,20%用作测试集)random_state=50: 随机种子,用于确保数据分割的随机性一致。相同的随机种子保证每次运行程序时,分割出的训练集和测试集相同
Step 5: 建立MLP模型
接下来我们建立自己的MLP模型,有一层隐藏层,10个神经元,输出层有1个神经元表示二分类:
# MLP模型
from keras.models import Sequential
from keras.layers import Dense
model = Sequential()
model.add(Dense(units=10, activation='relu', input_dim=7 * 7 * 512))
model.add(Dense(units=1, activation='sigmoid'))
Step 6: 配置模型
# 配置模型
model.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])
-
compile是 Keras 模型的方法,用于在训练模型之前配置模型的学习过程,它的主要参数有:- 损失函数(
loss):定义模型训练时计算误差的方法。 - 优化器(
optimizer):决定模型的参数(如权重和偏置)如何更新,以最小化损失函数。 - 评估指标(
metrics):决定用于评估模型性能的指标,这些指标不会影响模型训练,只用于衡量效果。
- 损失函数(
-
loss='binary_crossentropy':binary_crossentropy(二元交叉熵)是二分类任务中常用的损失函数 -
optimizer='adam':adam(Adaptive Moment Estimation)是一种自适应学习率优化算法,是深度学习中最常用的优化器之一 -
metrics=['accuracy']:指定模型在训练和评估时用准确率来衡量性能
Step 7: 训练模型
把训练集数据喂给模型即可:
# 训练模型
model.fit(X_train, y_train, epochs=50)
Step 8: 评估模型
我们要分别测试训练集和测试集准确率:
# 训练集准确率
train_accuracy = model.evaluate(X_train, y_train)[1]
print('Train Accuracy: ', train_accuracy)

# 测试集准确率
test_accuracy = model.evaluate(X_test, y_test)[1]
print('Test Accuracy: ', test_accuracy)
输出:
Train Accuracy:  0.9991000294685364
Test Accuracy:  0.9833999872207642
效果非常好!
2.4.4. 效率更高版代码
上文中我们将照片一个个处理,这样写的好处在于不占内存,但是效率较低。我们也可以一次性把所有照片加载进内存里一次性处理完,这样写效率更高。
实测,如果采用一次性把所有照片加载进内存的办法将会占用20GB内存,加上IDE(我用的是PyCharm Professional)一共要占23GB内存,也就是说32GB内存才能勉强跑,48GB才能保证不会爆内存。
如果你的电脑内存够大,你可以尝试以下这段代码:
import os
import numpy as np
from tensorflow.keras.preprocessing.image import load_img, img_to_array
from tensorflow.keras.applications.vgg16 import VGG16, preprocess_input

# 初始化 VGG 模型
model = VGG16(weights='imagenet', include_top=False)


def load_and_preprocess_images(folder):
    """
    批量加载并预处理指定文件夹中的所有图片
    :param folder: 图片文件夹路径
    :return: 预处理后的图像批量数据和图像数量
    """
    # 检查路径是否存在
    if not os.path.exists(folder):
        raise FileNotFoundError(f"文件夹不存在:{folder}")

    # 获取所有 .jpg 文件路径
    img_paths = [
        os.path.join(folder, file)
        for file in os.listdir(folder)
        if file.endswith('.jpg')
    ]

    if not img_paths:
        raise ValueError(f"文件夹中未找到图片文件:{folder}")

    # 批量加载所有图片并调整大小为 (224, 224)
    images = np.array([
        img_to_array(load_img(img_path, target_size=(224, 224)))
        for img_path in img_paths
    ])

    # 应用预处理(如均值中心化)
    images = preprocess_input(images)

    print(f"Loaded {len(images)} images from {folder}")
    return images, len(img_paths)


def process_folder_in_batch(folder, model):
    """
    批量处理指定文件夹中的所有图片,提取特征向量
    :param folder: 图片文件夹路径
    :param model: VGG 模型实例
    :return: 提取的特征向量数组和图片数量
    """
    # 加载并预处理所有图片
    images, img_count = load_and_preprocess_images(folder)

    # 批量提取特征向量
    features = model.predict(images)
    features = features.reshape(img_count, -1)  # 展平成 (N, 7*7*512) 的特征矩阵

    print(f"Extracted features for {img_count} images from {folder}")
    return features, img_count

# 路径
BASE_DIR = os.path.abspath("train/train")
cat_folder = os.path.join(BASE_DIR, "cat")
dog_folder = os.path.join(BASE_DIR, "dog")

# 处理猫图片文件夹
try:
    cat_features, cat_count = process_folder_in_batch(cat_folder, model)
except Exception as e:
    print(f"处理猫图片文件夹时发生错误: {e}")

# 处理狗图片文件夹
try:
    dog_features, dog_count = process_folder_in_batch(dog_folder, model)
except Exception as e:
    print(f"处理狗图片文件夹时发生错误: {e}")

# 检查是否成功提取特征
if 'cat_features' in locals() and 'dog_features' in locals():
    # 生成对应的标签(猫为 0,狗为 1)
    cat_labels = np.zeros((cat_count, 1))
    dog_labels = np.ones((dog_count, 1))

    # 合并特征和标签
    X = np.concatenate((cat_features, dog_features), axis=0)
    y = np.concatenate((cat_labels, dog_labels), axis=0)

    print(f"Feature shape: {X.shape}, Label shape: {y.shape}")

    # 数据分离
    from sklearn.model_selection import train_test_split

    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=50)
else:
    print("特征提取失败,无法继续后续处理。")

# 建立MLP模型
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense
model = Sequential()
model.add(Dense(units=10, activation='relu', input_dim = 7 * 7 * 512))
model.add(Dense(units=1, activation='sigmoid'))

# 配置模型
model.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])

# 训练模型
model.fit(X_train, y_train, epochs=50)

# 训练集准确率
train_accuracy = model.evaluate(X_train, y_train)[1]
print('Train Accuracy: ', train_accuracy)

# 测试集准确率
test_accuracy = model.evaluate(X_test, y_test)[1]
print('Test Accuracy: ', test_accuracy)
3.1. 序列模型(Sequence Model)
3.1.1. 一些案例
我们来看看序列模型的实际应用案例:
- 根据标题自动撰写文章
- 自动寻找语句中的人名
- …
它们的共同核心点在于基于文本内容及其前后信息进行预测。
我们再来看一个例子:
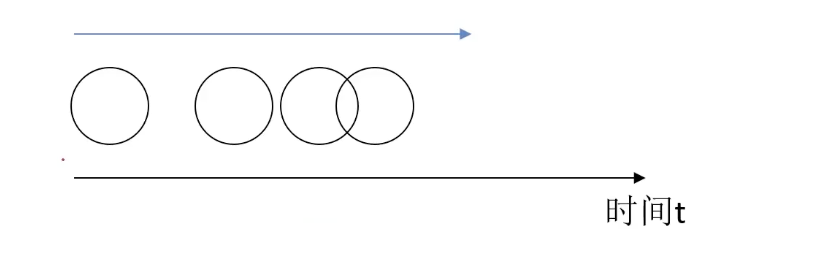
有一个球在沿着一个方向运动,但是速度不固定,我希望计算机能预测在某一时刻小球所处的位置。如果我们有这种算法,那么就可以通过视觉监控预判出人的行为。
这个问题的核心在于基于目标不同时刻状态进行预测。
最后一个例子:
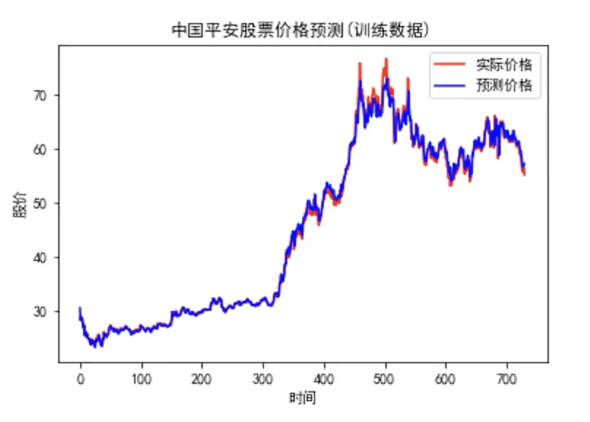
通过历史股价,预测次日股票价格。虽然不可能很精确的预测,但是只要趋势正确就能帮助投资者进行投资。
这个问题的核心在于基于数据历史信息进行预测。
这三个例子都有一个共同点:根据一些有前后关系的序列数据进行预估。
针对这一类问题有序列模型来解决。
3.1.2. 什么是序列模型(Sequence Model)
序列模型(Sequence Models) 是一类专门处理时间序列数据或有序数据的机器学习模型。它们能够捕捉输入数据的时序依赖关系,广泛应用于自然语言处理(NLP)、语音识别、时间序列预测等领域。
常见的序列模型包括:
- RNN(循环神经网络):能够处理变长输入,但存在梯度消失问题。
- LSTM(长短时记忆网络) & GRU(门控循环单元):改进 RNN,能够更好地捕捉长距离依赖关系。
- Transformer:基于自注意力机制(Self-Attention),在 NLP 任务中超越了 RNN/LSTM,成为当前主流架构(如 BERT、GPT)。
其主要特点是:
- 输入(输出)元素之间是具有顺序关系。不同的顺序,得到的结果应该是不同的,比如“不吃饭” 和“吃饭不”这两个短语的意思是不同的
- 输入输出不定长。比如文章生成、聊天机器人
其主要应用方面包括:
- 语音识别
- 语言翻译
- 股价预测
- 行为预测
一个冷知识:Transformer架构最初是为自然语言处理(NLP)任务设计的,尤其是用于机器翻译(Machine Translation)。它首次出现在 2017 年谷歌的论文 “Attention Is All You Need” 中,彻底改变了 NLP 领域。
下一篇文章 3.2. 循环神经网络(RNN)理论(基础) 中我们就会学到前Transformer时代最常用的序列模型——RNN循环神经网络。
3.2. 循环神经网络(RNN)理论(基础)
3.2.1. 什么是循环神经网络(RNN)
循环神经网络(Recurrent Neural Network,简称RNN)是一种用于处理序列数据(如时间序列、文本、语音等)的神经网络。与普通前馈神经网络不同,RNN 具有 “记忆” 能力,能够保留过去的信息并影响当前的输出,非常适用于处理时序数据和自然语言相关任务。
为了理解RNN,我们需要先回顾一下多层感知器MLP模型,以下是一个简略模型:
graph TD;
    X((x)) --> |输入| A[计算单元] --> |输出| Y((y))
x作为输入,交由计算单元中的各层若干个神经元计算输出结果y。而RNN就是把前一次计算的数据作为新一次计算的参数继续计算:
graph TD;
    X1((x^1)) --> A1[计算单元]
    A1 --> Y1((y^1))
    A1 -->|a^1| A2[计算单元]
    X2((x^2)) --> A2
    A2 --> Y2((y^2))
- $x^1$ 和 $x^2$ 是两个时间步的输入。
- 计算单元处理每个时间步的数据,输出 $y^1$ 和 $y^2$。
- 隐藏状态 $a^1$ 在时间步间传递,即前一个时间步的信息流向下一个时间步。隐藏状态是通过 前一个时间步的隐藏状态和当前输入 计算得出的。
3.2.2. RNN数学模型
基础架构
我们来看RNN模型的基础架构:
graph TD;
    A0((a^0)) --> A1[计算单元]
    X1((x^1)) --> A1
    A1 --> Y1((y^1))
    A1 --> Y2((a^1))
$a^0$: 初始隐藏状态
- 这是 RNN 在第一个时间步的隐藏状态的初始值。
- 通常设为零向量(全零),或者可以随机初始化:$a^0 = \mathbf{0} \quad \text{(default)}$
- 作用:提供初始记忆,使 RNN 具有时间序列特性。
$x^1$ : 第一时间步的输入
- RNN 处理的序列输入,第一个时间步的数据
- 可能是:
- 文本任务:句子的第一个单词(例如 “Hello”)
- 时间序列:股票数据的第一个时间点
- 语音识别:语音片段的第一帧
- 这个输入会和隐藏状态 $a^0$ 一起用于计算新的隐藏状态 $a^1$。
计算单元
- RNN 的核心单元,它使用 前一个隐藏状态 $a^0$ 和当前输入 $x^1$ 计算出:
- 新的隐藏状态 $a^1$(记忆传递)
- 当前时间步的输出 $y^1$(预测)
- 计算公式: $$ a^1 = f(W_h a^0 + W_x x^1 + b) $$ $$ y^1 = g(W_y a^1 + c) $$
- $W_h$, $W_x$, $W_y$ 是权重矩阵
- $b$, $c$ 是偏置项
- $f$(常用tanh)是隐藏状态的激活函数
- $g$(如softmax)是输出的映射
本文采用上面这种常见写法:先更新隐藏状态 $a^1$,再由 $a^1$ 计算输出 $y^1$。有些资料会写成由 $a^0$ 与 $x^1$ 一步映射到 $y^1$ 的等价变体;只要权重矩阵定义一致,含义相同。
$y^1$: 第一个时间步的输出
- 这是 计算单元的主要输出,表示当前时间步的预测结果
- 对于不同任务:
- 语言模型(如 GPT):$y^1$ 可能是 预测下一个单词的概率分布
- 机器翻译:$y^1$ 可能是 目标语言的第一个单词
- 语音识别:$y^1$ 可能是 音素(phoneme) 或 单词
- 计算公式:
$$
y^1 = g(W_y a^1 + c)
$$
- 其中 g 可能是 softmax(分类任务),或者是线性激活(回归任务)
$a^1$:更新后的隐藏状态
- 下一时间步的记忆信息,用于传递历史信息到 $t=2$
- 计算公式:
$$
a^1 = f(W_h a^0 + W_x x^1 + b)
$$
- 这个值会传递到下一个时间步 $t=2$,用于计算 $a^2$ 和 $y^2$
以此类推
最关键的两个公式就是计算两个输出的公式: $$ a^1 = f(W_h a^0 + W_x x^1 + b) $$ $$ y^1 = g(W_y a^1 + c) $$
- $W_h$, $W_x$, $W_y$ 是权重矩阵
- $b$, $c$ 是偏置项
- $f$(常用tanh)是隐藏状态的激活函数
- $g$(如softmax)是输出的映射
我们要做的就是重复这个过程,不断循环: $$ a^i = f(W_h a^{i-1} + W_x x^{i} + b) $$ $$ y^i = g(W_y a^i + c) $$
3.2.3. 计算机与RNN
那么我们要计算机在RNN模型算什么呢?仔细看上面的两行公式,不知道的参数有权重矩阵$W_h$, $W_x$和$W_y$。
计算这几个参数的方法跟MLP的求解方法一样:通过训练数据和标签来反推梯度,求到权重矩阵$W_h$, $W_x$和$W_y$,使损失函数最小。
3.2.4. 例子
我们用一个例子来加深对RNN的理解:
自动寻找语句中的人名:GTC is hosted by Jensen Huang.
我们先来确定我们的输入——每一个单词(标点也算)对应一个输入数据:
| 输入 | 单词 |
|---|---|
| $x_1$ | “GTC” |
| $x_2$ | “is” |
| $x_3$ | “hosted” |
| $x_4$ | “by” |
| $x_5$ | “Jensen” |
| $x_6$ | “Huang” |
| $x_7$ | “.” |
那标签该怎么写呢?每一个输入对应一个输出,既然我们要找人名,那么是人名的输入就是1,不是则为0:
| 输入 | 单词 | 输出 |
|---|---|---|
| $x_1$ | “GTC” | 0 |
| $x_2$ | “is” | 0 |
| $x_3$ | “hosted” | 0 |
| $x_4$ | “by” | 0 |
| $x_5$ | “Jensen” | 1 |
| $x_6$ | “Huang” | 1 |
| $x_7$ | “.” | 0 |
但是计算机也不懂单词啊,它看到的单词只是编码,所以我们得把单词转为计算机能看懂的形式——数字,也就是建立一个字典,把输入词汇转为数值矩阵,把单词输入转为字典里的数值。
那我们该怎么写这个字典呢?最简单粗暴的办法就是创建一个涵盖了所有单词的字典(首字母大写小写的两种格式要分为两个字段): $$ \left{ \begin{array}{ll} \textit{a} & : 1 \ \textit{am} & : 2 \ \vdots & \vdots \ \textit{by} & : x \ \vdots & \vdots \ \textit{is} & : y \ \textit{hosted} & : z \ \vdots & \vdots \end{array} \right} $$
我们会把单词对应的one-hot编码作为输入,比如am这个单词就会表达成:
| 索引 | 值 |
|---|---|
| 0 | 0 |
| 1 | 1 |
| 2 | 0 |
| 3 | 0 |
| 4 | 0 |
| 5 | 0 |
| … | 0 |
那如何构建模型呢?
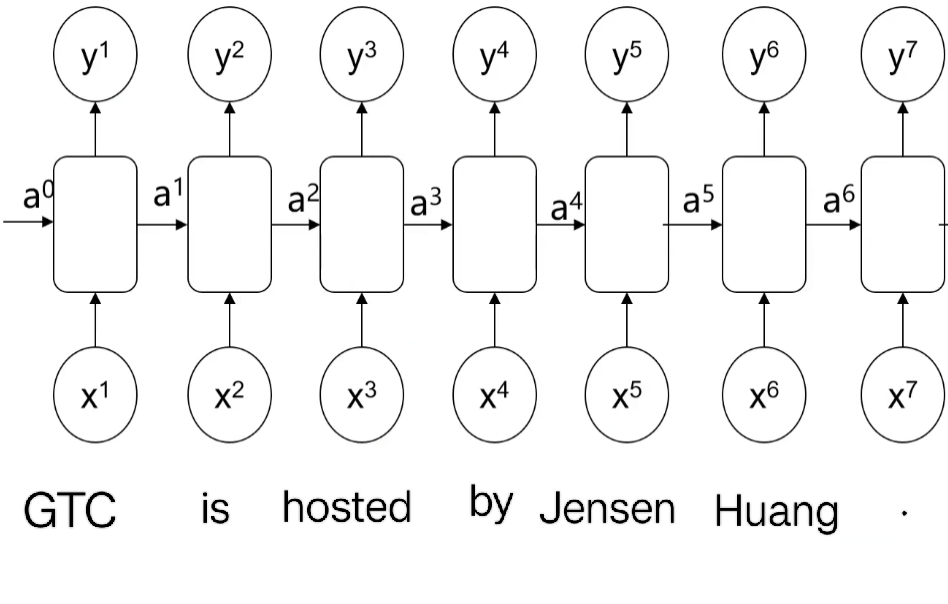
7个输入对应7个时间步(同一个 RNN 单元及其权重在各时间步复用)。把one-hot编码好的数据和对应标签给模型,让模型反推权重即可。
计算机在反推权重时会需要保证损失函数最小,单个神经元的损失函数计算公式如下: $$ \textit{loss}(i) = -y^i \log(y_{\textit{predict}}^i) - (1 - y^i) \log(1 - y_{\textit{predict}}^i) $$ 我们把所有神经元的损失函数加一起,让计算机在每次迭代中都尽可能使它最小即可: $$ \operatorname{minimize}( \sum_{i} \left[ -y^i \log(y_{\textit{predict}}^i) - (1 - y^i) \log(1 - y_{\textit{predict}}^i) \right]) $$
如果你不想建立一个包含所有英文单词的字典,也可以建立一个针对每个字母的字典: $$ \left{ \begin{array}{ll} \textit{a} & : 1 \ \textit{b} & : 2 \ \vdots & \vdots \ \textit{z} & : 26 \ \textit{A} & : 27 \ \vdots & \vdots \ \textit{1} & : 53 \ \vdots & \vdots \end{array} \right} $$ 这么写字典更小,但是对模型要求更高。
3.3. 循环神经网络(RNN)理论(进阶)
本文承接自上一篇文章 3.2. 循环神经网络(RNN)理论(基础),没看过的建议先看上文。
3.3.1. 基础的RNN结构
图示
我们先来看最基础的RNN结构:

在MLP的基础上把前面序列的部分信息作处理之后给下一个序列。
有的时候你也会看到这样的符号:

这是对应基础的RNN结构,可以用来表示RNN模型,相比于MLP多了一个表示自循环的箭头。
输入&输出
- 输入: $x^1, x^2, x^3, \dots, x^i$
- 输出: $y^1, y^2, y^3, \dots, y^i$
特点在于输入输出的序列是一样的,输入有$i$个输出就有$i$个。这就是多输入对应多输出、维度相同的RNN结构。
主要应用
特定信息识别,比如说判断句子中的哪些单词是人名。
3.3.2. 多输入单输出的RNN架构
图示
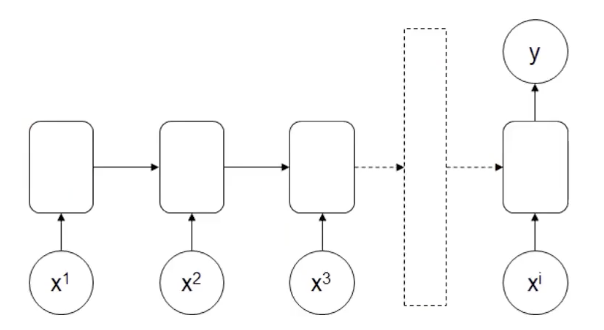
输入&输出
- 输入: $x^1, x^2, x^3, \dots, x^i$
- 输出: $y^1$
主要应用
情感识别:假如我有“I feel happy and positive.“这句话,计算机需要判定这句话表达的是正面情绪还是负面情绪。
3.3.3. 单输入多输出的RNN架构
图示
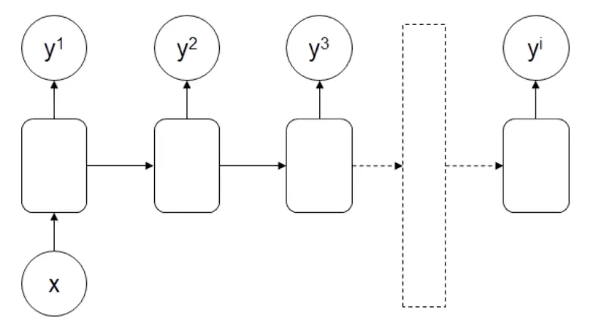
输入&输出
- 输入: $x^1$
- 输出: $y^1, y^2, y^3, \dots, y^i$
它一般作为序列数据生成器。
主要应用
- 文章生成:给个标题生成一段话。
- 音乐生成:选定曲风/情感之类的参数来输出音乐。
3.3.4. 多输入多输出的RNN架构
图示
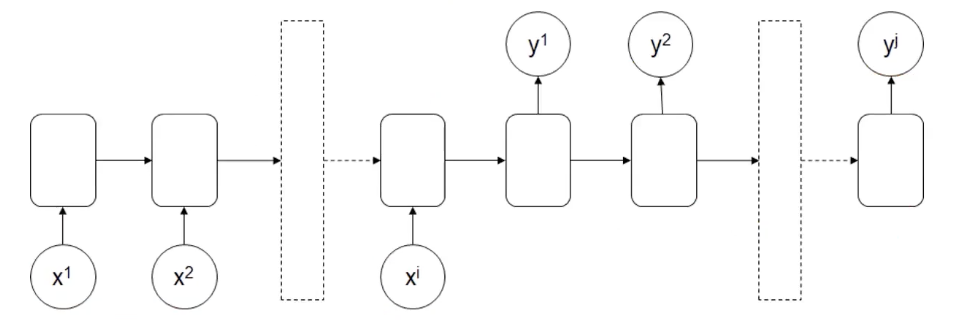
它与基础RNN架构有什么不同吗?不同之处在于输入数据的数量与输出数据可以不保持一致。
输入&输出
- 输入: $x^1, x^2, x^3, \dots, x^i$
- 输出: $y^1, y^2, y^3, \dots, y^j$
主要应用
其主要应用是语言翻译(虽然现在Transformer已经基本取代了RNN),比如说我有下面这句话: “What is artificial intelligence?”(4个单词,不算标点)
计算机把它翻译为中文: “什么是人工智能?”(7个汉字,不算标点)
这里的输入输出单词数不一致。
3.3.5. 普通RNN结构缺陷
普通RNN都存在结构缺陷。前部序列信息在传递到后部的同时,信息权重下降,导致重要信息丢失。
我们来看一个简单的例子(使用过去式填空):
- “The student, who got A+ in the exam, ___ excellent.”
- “The students, who got A+ in the exam, ___ excellent.”
第一个题(关键字:“student”)很明显是填was,第二个题(关键字:“students”)很明显是填were。
但是循环神经网络会在每一次传递中损失信息,最后“student”和“students”的差别就不会被体现。
针对这个问题,我们需要提高前部特定信息的决策权重。
3.3.6. 长短期记忆网络(LSTM)简介
图示
特点
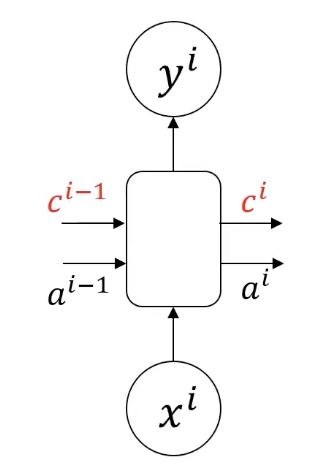
增加了记忆细胞$c^i$,可以传递前部远处部位信息。比如说上文的“student”和“students”的单复数差别就能被记忆细胞记住。
简化理解:相比$a^i$,记忆细胞$c^i$重点记录前部序列重要信息,且在传递过程中信息丢失少。
3.3.7. 深入理解LSTM

1. 输入与输出
-
输入: 该 LSTM 单元的输入包括:
-
当前时刻的输入 $x^i$
-
上一时刻的隐藏状态 $a^{i-1}$
-
上一时刻的细胞状态 $c^{i-1}$(红色标注)
-
输出:
- 当前时刻的隐藏状态 $a^i$
- 当前时刻的细胞状态 $c^i$(红色标注)
- 经过激活函数后的输出 $y^i$
2. 关键计算单元 LSTM 的关键组件是 遗忘门、输入门、输出门,以及一个新的细胞状态计算方式:
(1) 遗忘门(Forget Gate)
- 作用:决定哪些信息应该从过去的细胞状态 $c^{i-1}$ 中遗忘。
- 计算方式:
$$
f^i = \sigma(W_f [a^{i-1}, x^i] + b_f)
$$
- 其中:$\sigma$ 是 Sigmoid 激活函数
- $W_f$ 是权重矩阵,$b_f$ 是偏置项
- 计算出的$f^i$介于0和1之间,表示遗忘的比例
(2) 输入门(Input Gate)
-
作用:决定哪些新的信息应该被加入到细胞状态中。
-
计算方式: $$ g^i = \tanh(W_g [a^{i-1}, x^i] + b_g) $$
- 其中 $g^i$ 代表新信息(候选细胞状态),使用 tanh 进行归一化。
-
同时,另一个门控机制决定了信息加入的比例: $$ i^i = \sigma(W_i [a^{i-1}, x^i] + b_i) $$
- $i^i$ 也是 Sigmoid 计算出的值,表示该信息对新细胞状态的影响程度。
细胞状态更新: $$ c^i = f^i \cdot c^{i-1} + i^i \cdot g^i $$
(3) 输出门(Output Gate)
- 作用:决定当前隐藏状态(即 a^i)的值。
- 计算方式:
$$
o^i = \sigma(W_o [a^{i-1}, x^i] + b_o)
$$
- 其中 $o^i$ 控制了输出的程度。
计算最终的隐藏状态: $$ a^i = o^i \cdot \tanh(c^i) $$
3. 关键连线说明
- 红色的 $c^i$ 和 $c^{i-1}$ 表示 LSTM 细胞状态的传递
- $a^i$ 和 $a^{i-1}$ 是隐藏状态的传递,供下一时刻使用
- 输入 $x^i$ 通过多个门控制其信息流
- 激活函数(如 tanh)在细胞状态和输出门中起到了归一化作用
3.3.8. 深层循环网络(DRNN)
解决更复杂的序列任务,可以把单层RNN叠起来或者在输出前和普通MLP结构结合使用:
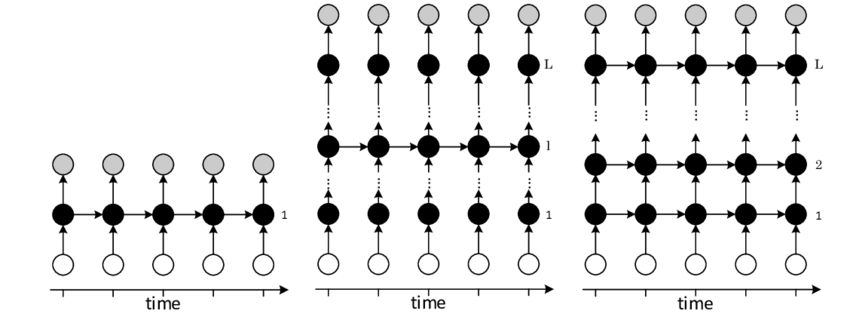
1. 左图:单层RNN
- 这是最基本的RNN结构,输入依赖于时间步(time step),并且隐藏层通过时间传播信息
- 黑色节点表示隐藏状态,箭头表示信息流动的方向
- 由于仅有单层隐藏层,该结构在建模复杂序列时存在局限性
2. 中图:多层RNN
- 这一结构在时间维度上保持RNN特性,同时在深度方向上叠加了多个隐藏层
- 低层的隐藏状态不仅连接到下一个时间步,还作为输入传递到上层隐藏状态,使模型可以在不同层次学习不同级别的表示(低层学习局部模式,高层学习长期依赖)
- 这使得模型更具表达能力,能够提取更复杂的特征
3. 右图:全连接的深度RNN
- 该结构进一步增强了网络的建模能力,每一层的隐藏状态都与下一层进行连接,并且在时间步之间进行传播
- 这种结构能够更好地捕捉长期依赖关系,同时利用深度结构提升特征学习能力
DRNN的关键特性
- 深度结构:相比单层RNN,DRNN具有多个隐藏层,使得模型在不同层级上学习不同的特征表示,提升表达能力
- 更强的特征学习能力:堆叠多层有助于网络学习层次化的时序特征。沿时间和深度方向仍可能出现梯度消失,实践中常配合 LSTM/GRU 单元或残差连接使用
- 信息流的层次化传播:信息在不同时间步和不同层之间进行传播,提高模型的预测能力 我们会在之后的实战环节进行更深入的了解
3.4. 循环神经网络(RNN)实战:预测股价
本文承接自上一篇文章 3.2. 循环神经网络(RNN)理论(基础),没看过的建议先看上文。
3.4.1. 准备工作
请在终端输入指令以下载和安装:
pip install keras tensorflow pandas
这里需要使用到我的csv文件,我把它上传到了GitCode,你点击链接即可查看和下载。
它有2栏信息,一栏是Time,代表时间点,有1到700一共700个时间点;一栏是Value,代表股价。
把下载好后的数据放到你的Python项目下即可。
3.4.2. 模型细节
在正式敲代码之前,我们先来确定模型的一些细节:
- 单层RNN,输出有5个神经元,再基于这5个神经元的值来确定1个最终的输出
- 每次使用前八个数据预测第九个数据
3.4.3. 敲代码
Step 1: 读取数据
使用pandas库来读取数据,顺便给变量赋值:
# 读取数据
import pandas as pd
data = pd.read_csv('simulated_stock_data.csv')

prices = data.loc[:, 'Value']
times = data.loc[:, 'Time']
再使用matplotlib画出原始数据:
# 可视化原始数据
import matplotlib.pyplot as plt
plt.plot(times, prices)
plt.show()
图片输出:
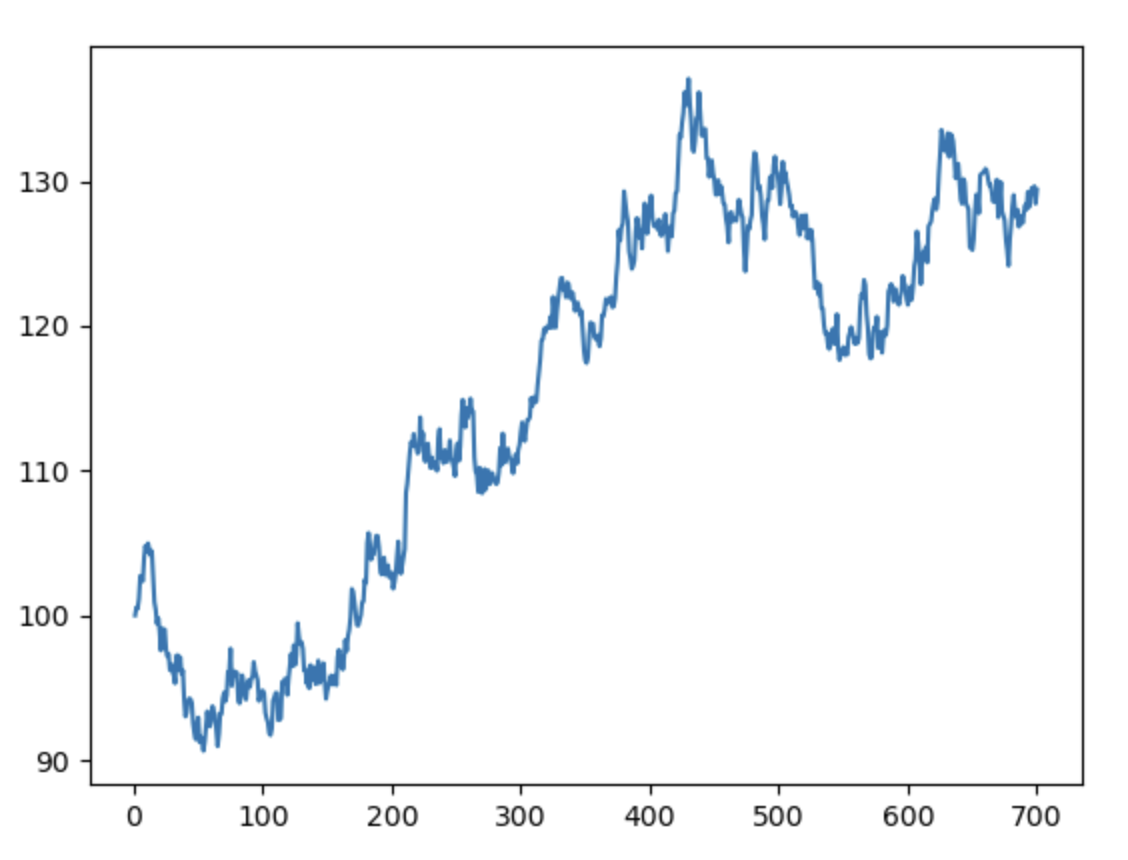
Step 2: 归一化处理
由上图可知,我们的数据最小在90左右,最大在130左右,数据的差距太大了,很容易出现像“碗边陡峭,底部平坦”的情况。为了避免这种情况,我们用最大值做归一化(把每个价格除以最大价格),使数值落在 $(0, 1]$ 区间内,这样在进行梯度下降时能让等高线更“圆滑”。
# 数据归一化
price_norm = prices / max(prices)
Step 3: 提取X和y
上文讲到,每次使用前八个数据预测第九个数据,所以我们得先提取出序列数据,每八个数据形成一个小组,把这些组合在一起形成二维数组:
# 提取X和y
import numpy as np
def extract_xy(data, time_step):
    X, y = [], []
    for i in range(len(data) - time_step):
        X.append([a for a in data[i: i + time_step]])
        y.append(data[i + time_step])
    X = np.array(X)
    X = np.reshape(X, (X.shape[0], X.shape[1], 1))
    return X, y

time_step = 8
X, y = extract_xy(price_norm, time_step)
-
time_step表示用几个连续的数据作为一组输入,用来预测其后一个数据。这里的time_step = 8,所以每次输入是 8 个值。 -
循环从
0到len(data) - time_step(确保不会超出数组范围)。每次循环里:data[i: i + time_step]提取从第i个位置开始的连续time_step(即 8 个)数据,作为一组输入序列,存入Xdata[i + time_step]提取第i + time_step位置的数据,作为目标值,存入y- 例如: 如果输入数据
data = [1, 2, 3, 4, 5, 6, 7, 8, 9]且time_step = 3,运行这个循环后:X = [[1, 2, 3], [2, 3, 4], [3, 4, 5], [4, 5, 6], [5, 6, 7], [6, 7, 8]]、y = [4, 5, 6, 7, 8, 9]
-
最后我们要使用numpy来调整
X的形状:- 对于
X,调整形状为(样本, time_step, 1),每个样本表示一个包含time_step个数据的小组,并且增加一个额外维度(用于深度学习模型的输入,表示特征数量,这里是 1) - 对于
y,保持为一维序列,长度为样本数(每个输入窗口对应一个目标值)。对单个回归输出,Keras 可以直接接受这种格式
- 对于
Step 4: 建立并配置模型
接下来我们就可以建立RNN模型了,记得按照上文的要求来(单层RNN,输出有5个神经元,再基于这5个神经元的值来确定1个最终的输出):
# 建立模型
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, SimpleRNN

model = Sequential()
model.add(SimpleRNN(units=5, input_shape=(time_step, 1), activation='relu'))
model.add(Dense(units=1, activation='linear'))
model.compile(loss='mean_squared_error', optimizer='adam')
model.summary()
-
SimpleRNN 层:
units=5: 定义 RNN 的输出维度为 5,即该层 RNN 的隐状态(hidden state)的大小input_shape=(time_step, 1):time_step=8(在前面的代码中定义):表示输入的数据有 8 个时间步1:表示每个时间步的数据维度为 1(因为归一化后的输入对应的是价格值的标量,只有一列)
activation='relu': 使用 ReLU 激活函数,鼓励非线性建模
-
Dense 层:
units=1: 定义输出维度为 1,用于预测单个价格值activation='linear': 使用线性激活函数,使输出直接为一个数值(线性回归的形式)
-
编译模型:
loss='mean_squared_error': 使用均方误差作为损失函数,适合回归问题optimizer='adam': Adam 优化器,结合了动量和自适应学习率调节的优化算法
-
打印模型架构:
model.summary()打印模型的结构概要,包括每一层的名称、输出维度和参数数量等
输出:
Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ simple_rnn (SimpleRNN)          │ (None, 5)              │            35 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense (Dense)                   │ (None, 1)              │             6 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
 Total params: 41 (164.00 B)
 Trainable params: 41 (164.00 B)
 Non-trainable params: 0 (0.00 B)
Step 5: 训练模型
把数据喂给模型即可:
# 训练模型
model.fit(X, y, epochs=200, batch_size=32)
Step 6: 训练集预测结果
最后我们看看模型预测出的结果,把它叠加在原始数据上看看差距大不大:
# 训练集预测
y_train_predict = model.predict(X) * max(prices)
y_train = [i*max(prices) for i in y]

import matplotlib.pyplot as plt
plt.plot(y_train, label='real_price')
plt.plot(y_train_predict, label='predict_price')
plt.legend()
plt.show()
* max(prices):- 将预测值反归一化,恢复到原始价格的范围
max(prices)是归一化时使用的最大值,现在用于将预测结果映射回实际的价格范围
输出图片:
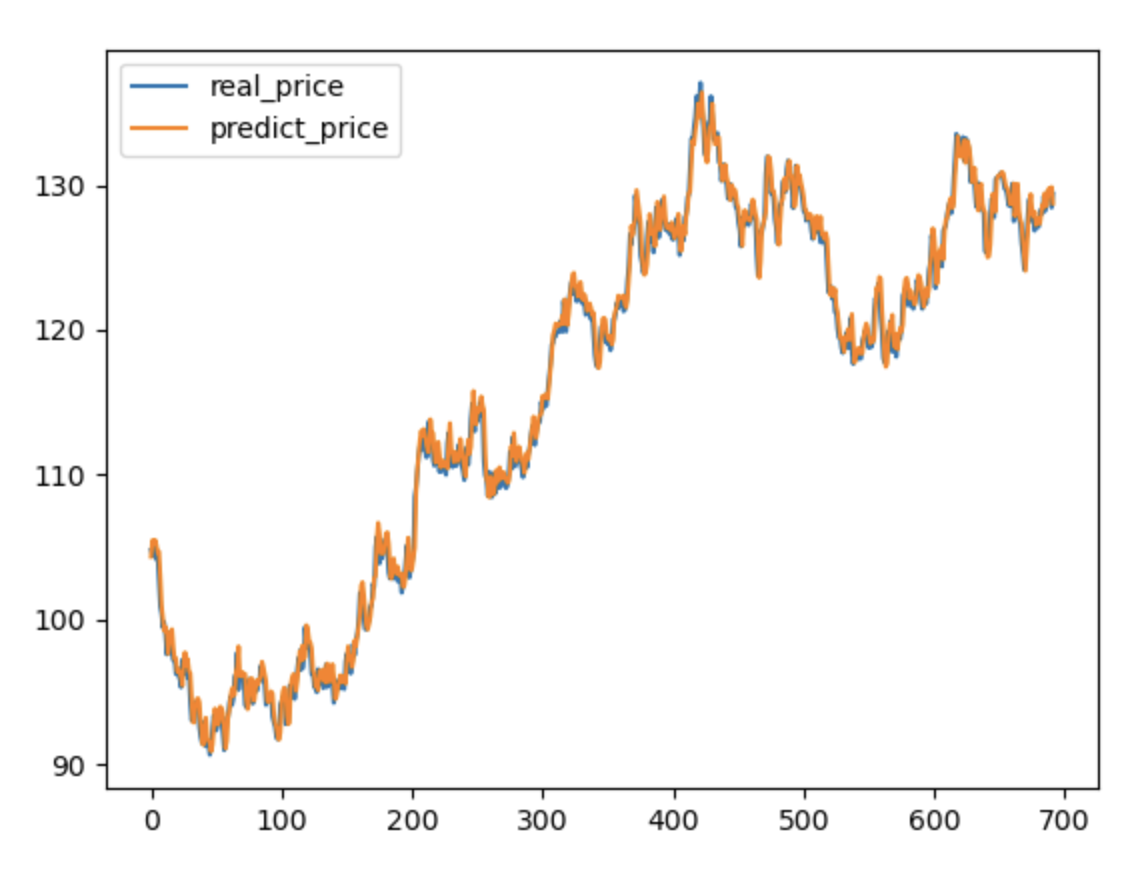
可以看出效果挺好的,差距不大。
3.5. 循环神经网络(RNN)实战:LSTM自动生成文本
本文承接自上一篇文章 3.3. 循环神经网络(RNN)理论(进阶),没看过的建议先看上文。
3.5.1. 准备工作
请在终端输入指令以下载和安装:
pip install keras tensorflow scikit-learn
这里需要使用到我的txt文件,我把它上传到了GitCode,你点击链接即可查看和下载。我们使用Mary Shelley的Frankenstein(中文名《弗兰肯斯坦》《科学怪人》)作为训练数据。
把下载好后的数据放到你的Python项目下即可。
3.5.2. 模型架构
在这篇文章中我们会使用长短期记忆网络(LSTM)模型来进行文本生成。我们要把文本内容转化之后的字典喂给模型,然后让它基于前20个字符预测第21个字符,计算准确率。
每个输入样本是长度为 20 的时间步(字符)序列;LSTM 层有 20 个单元,输出层神经元数取决于文本中不同字符的个数。
3.5.3. 敲代码
Step 1: 加载数据
首先我们把数据加载进来,顺便去掉换行符:
# 加载数据
data = open('Frankenstein_by_Mary_Shelley.txt').read()

# 移除换行符
data = data.replace('\n', ' ').replace('\r', '')
Step 2: 建立字典
文本中每一个字符我们都需要在字典中建立一个字段来对应,首先我们需要去掉重复的字符,然后再建立字典:
# 字符去重
letters = list(set(data))

# 打印检查
print(len(letters))

# 建立字典
char_to_int = {b:a for a, b in enumerate(letters)}
-
通过
set(data)将文本数据中的所有字符去重,保留每种字符的唯一值(如字母、数字、标点符号等)。list(set(data))就是将这些唯一的字符变成一个列表,存储在变量letters中。 -
字典
char_to_int的键是相应的字符,值是从序号 0 开始的整数,这样可以通过字符转为数据再转为one-hot格式。
输出:
74
这74个不同的字符(大小写字母、数字、标点等)就组成了所有的文本内容。
Step 3: 输入处理
我们接下来需要对字符串进行批量处理,在这里我们先建立一个data_processing方法,之后我们可以通过调用它来提取模型能够接收到的X和y数据:
# 字符批量处理
import numpy as np
from tensorflow.keras.utils import to_categorical

#实现输入字符文章的批量处理,输入整个字符、滑动窗口大小、转化字典
def data_processing(data, slide, num_letters, char_to_int):
    # 滑动窗门提取数据
    def extract_data(data, slide):
        x = []
        y = []
        for i in range(len(data) - slide):
            x.append([a for a in data[i:i + slide]])
            y.append(data[i + slide])
        return x, y

    # 字符到数字的批量处理
    def char_to_int_data(x, y, char_to_int):
        x_to_int = []
        y_to_int = []
        for i in range(len(x)):
            x_to_int.append([char_to_int[char] for char in x[i]])
            y_to_int.append([char_to_int[char] for char in y[i]])
        return x_to_int, y_to_int

    char_data = extract_data(data, slide)
    int_data = char_to_int_data(char_data[0], char_data[1], char_to_int)
    Input = int_data[0]
    Output = list(np.array(int_data[1]).flatten())
    Input_Reshaped = np.array(Input).reshape(len(Input), slide)
    new_ = np.zeros((Input_Reshaped.shape[0], Input_Reshaped.shape[1], num_letters))
    for i in range(Input_Reshaped.shape[0]):
        for j in range(Input_Reshaped.shape[1]):
            new_[i, j, :] = to_categorical(Input_Reshaped[i, j], num_letters)
    return new_, Output
extract_data 函数:
- 作用:通过滑动窗口,从输入字符序列中提取样本。
x:窗口中的字符列表(长度为窗口大小)。y:窗口后紧跟的目标字符(预测值)。
- 逻辑:
x通过[a for a in data[i:i + slide]]获取当前窗口范围内的字符。y取窗口后第一个字符data[i + slide]。- 如:
slide=3,输入数据data="abcdefg",结果:x = [['a', 'b', 'c'], ['b', 'c', 'd'], ['c', 'd', 'e'], ['d', 'e', 'f']]y = ['d', 'e', 'f', 'g']
char_to_int_data 函数:
- 作用:将字符序列
x和目标字符y转换成整数序列。- 使用
char_to_int字典获取每个字符在字典中的整数索引。 - 如:输入
x = [['a', 'b', 'c'], ['b', 'c', 'd']],y = ['d', 'e'],字典{'a': 0, 'b': 1, 'c': 2, 'd': 3, 'e': 4},结果:x_to_int = [[0, 1, 2], [1, 2, 3]]y_to_int = [[3], [4]](之后在Output中会被展平为[3, 4])。
- 使用
转换为模型输入:
- 通过
extract_data和char_to_int_data提取并完成字符到整数的转换; - 原始的整数输入
Input的形状为[样本数, 窗口大小]; Output是目标字符序列,以一维数组形式存储。
one-hot编码处理:
- 作用:将整数输入
Input_Reshaped转换为独热编码的 3D 输入new_。Input_Reshaped[i, j]是窗口的第i个样本中第j个字符的整数值。to_categorical(Input_Reshaped[i, j], num_letters)构建字符的独热编码,维度为[num_letters]。- 每个样本的编码结果存储在
new_,其形状为[样本数, 窗口大小, num_letters]。
最终输出:
new_:one-hot编码的输入数组,形状[样本数, 窗口大小, 字符表大小],适用于LSTM这类深度学习模型。Output:目标序列的整数数组,一维形式,长度为样本数。
Step4: 获取模型的输入
我们接下来使用data_processing方法提取模型能够接收到的X和y数据,同时也确认一下时间步长(time step)为20(模型基于前20个字符预测):
#时间步长
time_step = 20

# 获取模型的输入数据
X, y = data_processing(data, time_step, len(letters), char_to_int)

# 检查数据结构
print(X.shape)
print(len(y))
输出:
(421397, 20, 74)
421397
-
(421397, 20, 74):421397:表示滑动窗口提取到的样本数量,即构造出的有多少个[输入序列 -> 目标字符]样本。这取决于输入文本长度len(data)和滑动窗口大小time_step的关系。20:表示每个样本的时间步数 (滑动窗口大小time_step),也就是每个输入序列包含 20 个字符。这个值由代码中的参数time_step = 20决定。74:表示字符总种类数,即one-hot编码的维度。这个值来源于字符表的大小len(letters),表示输入数据中有 74 个独一无二的字符(包括字母、标点符号、空格等)。
-
y是样本对应的目标字符的整数列表。每个样本有一个目标字符,因此y的长度与样本数量相同,也就是421397。
Step5: 数据分离
把数据分为训练集和测试集:
# 数据分离
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.1, random_state=10)

# 把y_train改为one-hot编码
y_train_category = to_categorical(y_train, num_classes=len(letters))
- 将
y_train转换为one-hot 编码的主要原因是为了能交给LSTM模型来训练
Step 6: 建立模型
模型接收长度为 20 的时间步序列;LSTM 有 20 个单元,输出层神经元数取决于文本中不同字符的个数,也就是字典的长度:
# 建立模型
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, LSTM

model = Sequential()

model.add(LSTM(units=20, input_shape=(time_step, len(letters)), activation='relu'))
model.add(Dense(len(letters), activation='softmax'))
Step 7: 配置模型
# 配置模型
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])
Step 8: 训练模型
把训练集数据喂给模型即可:
# 训练模型
model.fit(X_train, y_train_category, epochs=20, batch_size=1000)
batch_size=1000:
- 每次训练(梯度更新)所使用的样本数量。
- 数据会被分割为多个批次,每批包含
1000个样本。- 举例:如果训练样本总数为 50,000,每个批次是 1,000,则一个 epoch 内需要 50 次更新。
- 当然如果你内存多可以不用设置这个参数,一次性把所有数据写入内存(要占恐怖的15GB左右,还没有算IDE)
Step 9: 评估模型
我们通过准确率来评估模型:
# 训练集准确率
_, train_accuracy = model.evaluate(X_train, y_train_category)
print(f"Train Accuracy: {train_accuracy}")

# 测试集准确率
y_test_category = to_categorical(y_test, num_classes=len(letters))
_, test_accuracy = model.evaluate(X_test, y_test_category)
print(f"Test Accuracy: {test_accuracy}")
输出:
Train Accuracy: 0.4766451120376587
Test Accuracy: 0.4727812111377716
别看这个准确率还没到50%,但是要知道计算机需要从74个不同字符中猜出一个答案能到这个正确率已经非常不错了。盲猜的正确率只有1/74,也就是1.35%,而模型运算出的结果正确率比它高30多倍。