2.2. 卷积神经网络(CNN)模型理论(进阶):图像填充、LeNet、AlexNet
本文紧承上一篇文章 2.1. 卷积神经网络(CNN)模型理论(基础):卷积运算、池化、ReLU函数,没看过的建议先看前文。
2.2.1. 图像填充(Padding)
卷积运算会带来两个问题:
- 图像被压缩,造成信息丢失:卷积后的图像小于原图像
- 边缘信息使用少,容易被忽略:中间的像素在卷积时会被反复计算,而边缘的像素只会被计算一次
针对这类问题我们会使用图像填充(Padding):通过在图像各边增加像素,使其在进行卷积运算后维持原图大小。填充的像素量由过滤器尺寸和窗口滑动步长(Stride) 决定,使卷积后的图像与原图像大小一致。
- 添加的像素值为0,这样才不会改变原图已有信息。
比如说我有一个5乘5的图像,过滤器尺寸为3乘3,窗口滑动步长为$(1,1)$,我应该填充多少像素呢?
输出尺寸由以下公式计算: $$ O = \frac{(I - K + 2P)}{S} + 1 $$
其中:
- I是输入尺寸(5×5)
- K是滤波器尺寸(3×3)
- P是每一侧的填充量(上/下或左/右);公式中出现 $2P$,是因为两侧都要填充
- S是步长(1×1)
如果希望输出尺寸仍然为$5 \times 5$,我们设$O = 5$,$K = 3$,解方程: $$ 5 = \frac{(5 - 3 + 2P)}{1} + 1 $$ 得到$P = 1$。也就是说,每一侧填充 1 像素,单个维度上的总填充量为 $2P = 2$。
如果某个维度所需的总填充量为奇数,就不能在两侧均匀分配,因此需要决定在哪一侧多填充1像素。常见做法是让右/下多填充一个像素,因为在某些深度学习框架(如 TensorFlow)中,默认使用的是“下/右多填充”策略。
2.2.2. 经典CNN模型
在上一篇文章(2.1. 卷积神经网络(CNN)模型理论(基础):卷积运算、池化、ReLU函数)中,我们提到了CNN就是把这一系列操作连接到一起形成的模型:
- 卷积
- 池化
- MLP
那么具体的顺序是什么样的呢?有没有需要重复执行的步骤呢?这些我们需要看看前人所写出的CNN模型是什么样的。
LeNet-5
LeNet-5是Yann LeCun等人在 1998 年提出的经典卷积神经网络(CNN)架构,主要用于手写数字识别(如 MNIST 数据集)。
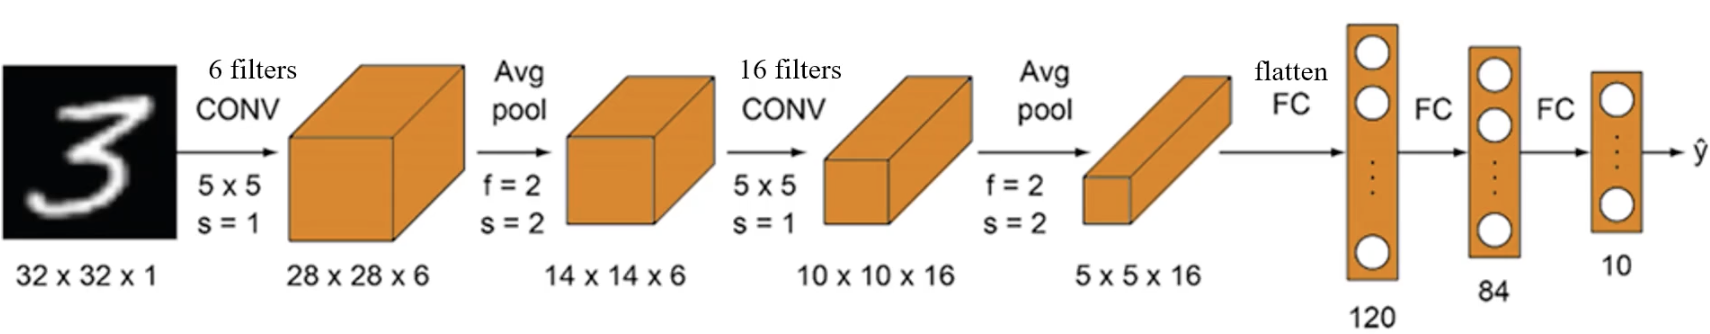
输入层(Input Layer)
- 尺寸:$32 \times 32$ 灰度图像(MNIST 原始大小是 $28 \times 28$,会被填充至 $32 \times 32$)
- 通道数:1(灰度图)
第一层:卷积层 C1(Convolutional Layer)
- 输入尺寸:$32 \times 32 \times 1$
- 滤波器(Kernel):6 个 $5 \times 5$ 卷积核(stride=1,valid padding)
- 计算公式:
$O = \frac{(I - K + 2P)}{S} + 1 = \frac{(32 - 5 + 0)}{1} + 1 = 28$
- 输出尺寸:$28 \times 28 \times 6$(6 个特征图)
- 激活函数:Sigmoid(现代 CNN 可能用 ReLU)
第二层:池化层 S2(Subsampling / Pooling Layer)
-
输入尺寸:$28 \times 28 \times 6$
-
操作:$2 \times 2$ 平均池化(stride=2)
-
计算公式: $O = \frac{(I - K)}{S} + 1 = \frac{(28 - 2)}{2} + 1 = 14$
-
输出尺寸:$14 \times 14 \times 6$(池化后减小尺寸)
-
激活函数:Sigmoid
第三层:卷积层 C3(Convolutional Layer)
-
输入尺寸:$14 \times 14 \times 6$
-
滤波器:16 个 $5 \times 5$ 过滤器
-
计算公式: $O = \frac{(I - K + 2P)}{S} + 1 = \frac{(14 - 5 + 0)}{1} + 1 = 10$
-
输出尺寸:$10 \times 10 \times 16$
-
激活函数:Sigmoid
-
连接方式:不是全连接,部分特征图相连(减少参数)
第四层:池化层 S4(Subsampling / Pooling Layer)
-
输入尺寸:$10 \times 10 \times 16$
-
操作:$2 \times 2$ 平均池化(stride=2)
-
计算公式: $O = \frac{(10 - 2)}{2} + 1 = 5$
-
输出尺寸:$5 \times 5 \times 16$
-
激活函数:Sigmoid
第五层:全连接层 C5(Fully Connected Layer)
- 输入尺寸:$5 \times 5 \times 16 = 400$ 个神经元
- 输出神经元:120(全连接)
- 激活函数:Sigmoid
第六层:全连接层 F6(Fully Connected Layer)
- 输入神经元:120
- 输出神经元:84
- 激活函数:Sigmoid
输出层(Output Layer)
- 输入神经元:84
- 输出神经元:10(对应 0-9 类别)
- 激活函数:Softmax(用于分类任务)
用一张表格来总结:
| 层次 | 说明 | 输入尺寸 | 输出尺寸 | 核大小 | 激活 |
|---|---|---|---|---|---|
| 输入层 | 灰度图像 | $32 \times 32 \times 1$ | $32 \times 32 \times 1$ | - | - |
| C1卷积 | 6 个$5 \times 5$过滤器 | $32 \times 32 \times 1$ | $28 \times 28 \times 6$ | $5 \times 5$ | Sigmoid |
| S2池化 | 平均池化$2 \times 2$ | $28 \times 28 \times 6$ | $14 \times 14 \times 6$ | $2 \times 2$ | Sigmoid |
| C3卷积 | 16 个$5 \times 5$过滤器 | $14 \times 14 \times 6$ | $10 \times 10 \times 16$ | $5 \times 5$ | Sigmoid |
| S4池化 | 平均池化 $2 \times 2$ | $10 \times 10 \times 16$ | $5 \times 5 \times 16$ | $2 \times 2$ | Sigmoid |
| C5全连接 | 400 个输入神经元 | $5 \times 5 \times 16 = 400$ | 120 | - | Sigmoid |
| F6全连接 | 120 个输入神经元 | 120 | 84 | - | Sigmoid |
| 输出层 | Softmax 分类 | 84 | 10 | - | Softmax |
输入图像:32X32灰度图,1个通道(channel)灰度图 训练参数:约60,000个 特点:
- 随着网络越深,图像的高度和宽度在缩小,通道数在增加
- 卷积与池化一组一组成对使用
AlexNet
随着科学的进步,计算机的算力和数学理论知识都在发展,LeNet已经被淘汰了,而它的继任者就是AlexNet。
AlexNet 由 Alex Krizhevsky 等人于 2012 年提出,并在ImageNet竞赛(ILSVRC-2012)中取得巨大成功,被认为是现代深度学习的奠基之作。它相比 LeNet-5更深、更宽,并引入了新的技术,如ReLU 激活函数、重叠池化、Dropout 和数据增强,极大地提高了 CNN 在大规模数据集上的表现。
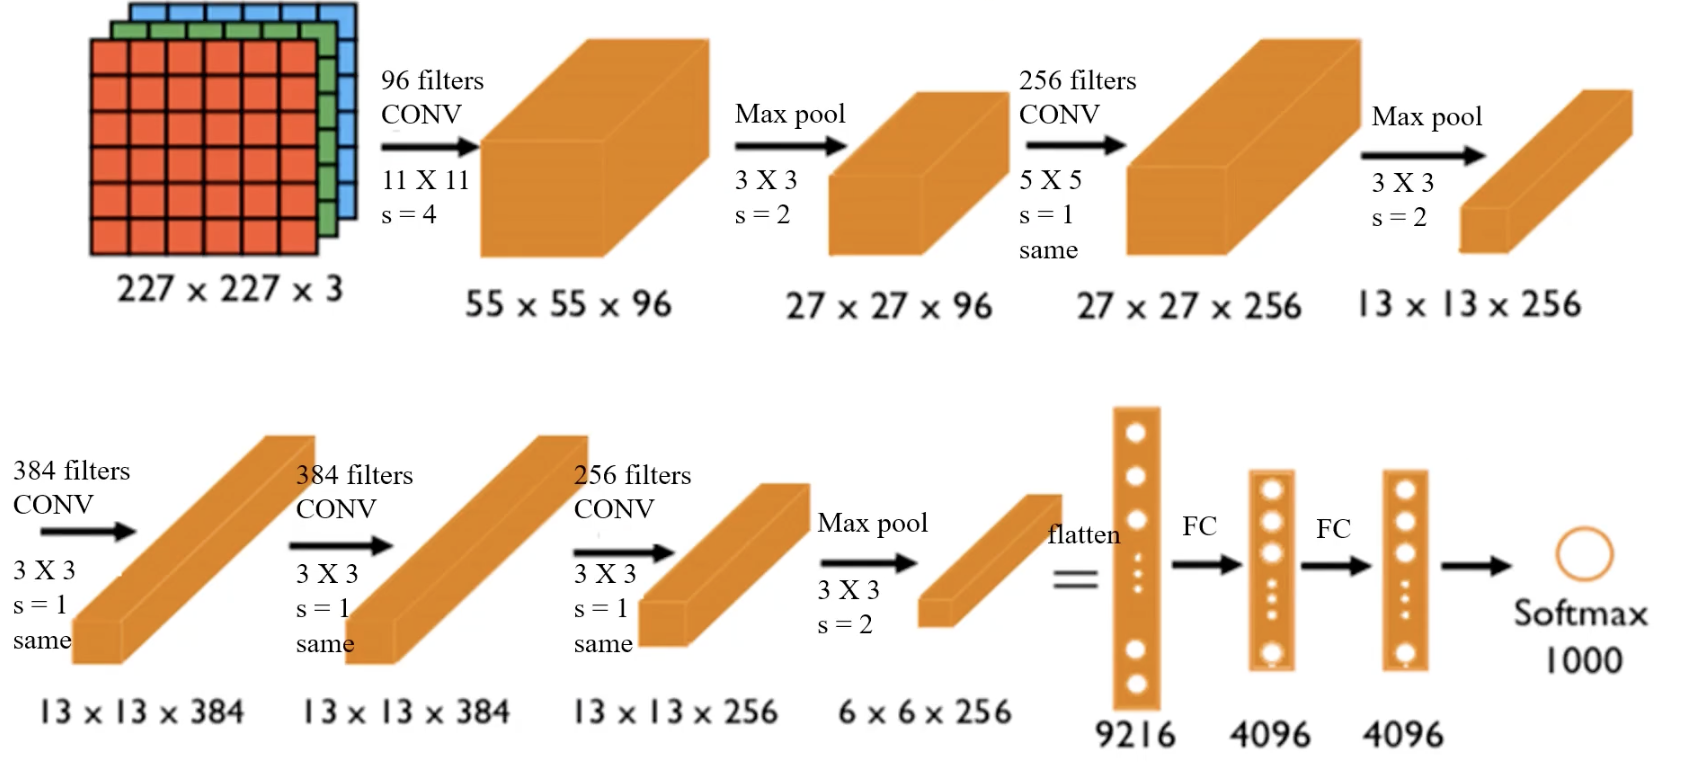
输入层(Input Layer)
- 尺寸:$227 \times 227 \times 3$(RGB 图像)
- 预处理:减去均值归一化
第一层:卷积层Conv1
-
输入尺寸:$227 \times 227 \times 3$
-
滤波器(Kernel):96 个 $11 \times 11$ 过滤器,步长 S = 4
-
填充(Padding):0(valid)
-
计算公式: $O = \frac{(I - K + 2P)}{S} + 1 = \frac{(227 - 11 + 0)}{4} + 1 = 55$
-
输出尺寸:$55 \times 55 \times 96$
-
激活函数:ReLU
-
特性:
- 大卷积核 $11 \times 11$,步长 4,加速特征提取
- ReLU 代替 Sigmoid,加快收敛速度
- Local Response Normalization(LRN):增强对比度
第二层:最大池化层 Pool1
-
输入尺寸:$55 \times 55 \times 96$
-
池化方式:$3 \times 3$ 最大池化,步长 2
-
计算公式: $O = \frac{(55 - 3)}{2} + 1 = 27$
-
输出尺寸:$27 \times 27 \times 96$
第三层:卷积层 Conv2
-
输入尺寸:$27 \times 27 \times 96$
-
滤波器:256 个 $5 \times 5$ 卷积核,步长 1,填充 2
-
计算公式: $O = \frac{(27 - 5 + 2 \times 2)}{1} + 1 = 27$
-
输出尺寸:$27 \times 27 \times 256$
-
激活函数:ReLU
-
LRN 归一化
-
特性:
- 较小卷积核 $5 \times 5$,捕捉更细粒度特征
- 归一化增加泛化能力
第四层:最大池化层 Pool2
-
输入尺寸:$27 \times 27 \times 256$
-
池化方式:$3 \times 3$ 最大池化,步长 2
-
计算公式: $O = \frac{(27 - 3)}{2} + 1 = 13$
-
输出尺寸:$13 \times 13 \times 256$
第五层:卷积层 Conv3
-
输入尺寸:$13 \times 13 \times 256$
-
滤波器:384 个 $3 \times 3$ 过滤器,步长 1,填充 1
-
计算公式: $O = \frac{(13 - 3 + 2 \times 1)}{1} + 1 = 13$
-
输出尺寸:$13 \times 13 \times 384$
-
激活函数:ReLU
-
特性:进一步提取更高级别的特征
第六层:卷积层 Conv4
-
输入尺寸:$13 \times 13 \times 384$
-
滤波器:384 个 $3 \times 3$ 过滤器,步长 1,填充 1
-
计算公式: $O = 13$
-
输出尺寸:$13 \times 13 \times 384$
-
激活函数:ReLU
-
特性:继续提取特征,提升层次信息
第七层:卷积层 Conv5
-
输入尺寸:$13 \times 13 \times 384$
-
滤波器:256 个 $3 \times 3$ 过滤器,步长 1,填充 1
-
计算公式: $O = 13$
-
输出尺寸:$13 \times 13 \times 256$
-
激活函数:ReLU
第八层:最大池化层 Pool3
-
输入尺寸:$13 \times 13 \times 256$
-
池化方式:$3 \times 3$ 最大池化,步长 2
-
计算公式: $O = \frac{(13 - 3)}{2} + 1 = 6$
-
输出尺寸:$6 \times 6 \times 256$
第九层:全连接层 FC6
-
输入:$6 \times 6 \times 256 = 9216$ 个神经元
-
输出:4096 个神经元
-
激活函数:ReLU
-
特性:Dropout(0.5)防止过拟合
第十层:全连接层 FC7
-
输入:4096 个神经元
-
输出:4096 个神经元
-
激活函数:ReLU
-
特性:Dropout(0.5)
第十一层:输出层(FC8 + Softmax)
- 输入:4096 个神经元
- 输出:1000 个类别(ImageNet 数据集)
- 激活函数:Softmax
图表总结:
| 层次 | 说明 | 输入尺寸 | 输出尺寸 | 过滤器 | 步长 | 填充 | 激活 |
|---|---|---|---|---|---|---|---|
| 输入层 | RGB 图像 | $227 \times 227 \times 3$ | $227 \times 227 \times 3$ | - | - | - | - |
| Conv1 | $11 \times 11$ 卷积 | $227 \times 227 \times 3$ | $55 \times 55 \times 96$ | $11 \times 11$ | 4 | 0 | ReLU |
| Pool1 | 最大池化 | $55 \times 55 \times 96$ | $27 \times 27 \times 96$ | $3 \times 3$ | 2 | - | - |
| Conv2 | $5 \times 5$ 卷积 | $27 \times 27 \times 96$ | $27 \times 27 \times 256$ | $5 \times 5$ | 1 | 2 | ReLU |
| Pool2 | 最大池化 | $27 \times 27 \times 256$ | $13 \times 13 \times 256$ | $3 \times 3$ | 2 | - | - |
(后续层类同)
输入图像:$227 \times 227 \times 3$ RGB图,3个通道 训练参数:约60,000,000个(已经预训练好了,可以直接用)
特点:
- 适用于识别较为复杂的彩色图,可识别1000种类别
- 结构比LeNet更为复杂,使用ReLU作为激活函数
VGG-16
VGG-16(Visual Geometry Group 16-layer)由牛津大学 VGG 组在2014年提出,并在ImageNet竞赛中取得了优异成绩。其核心特点是:
- 全部采用 $3 \times 3$ 卷积核,增加深度,同时减少参数量。
- 多次地使用$3 \times 3$小卷积核(一个卷积块中会有2~3次卷积)代替大卷积核(如 $5 \times 5$ 或 $7 \times 7$),提升模型表达能力。
- 使用 ReLU 作为激活函数,加速训练并缓解梯度消失问题。
- 全连接层采用 Dropout 进行正则化,减少过拟合。
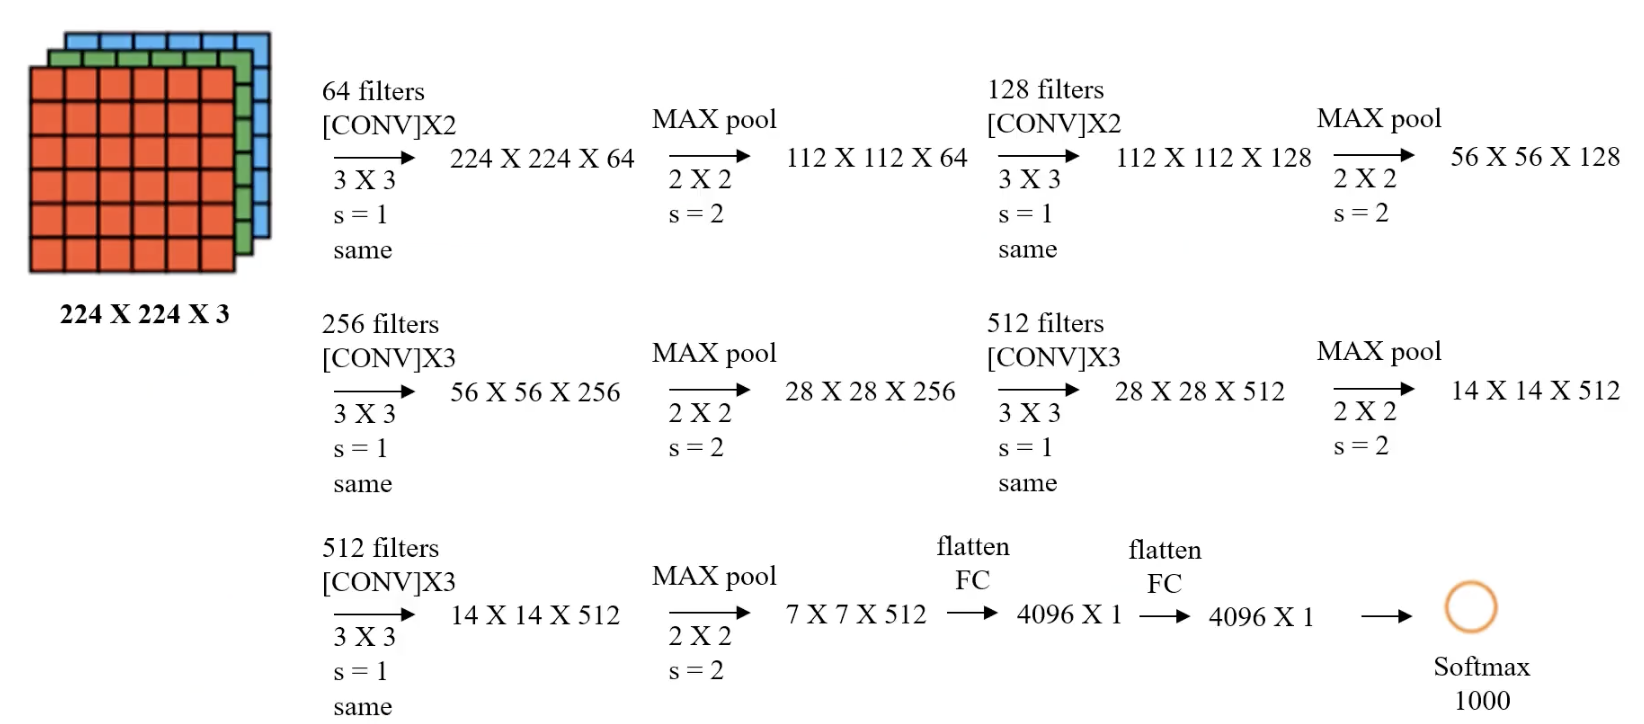
输入层(Input Layer)
- 尺寸:$224 \times 224 \times 3$(RGB 图像)
- 预处理:
- 归一化
- 减去均值(ImageNet 数据集的均值)
卷积块 1(Conv Block 1)
- 输入尺寸:$224 \times 224 \times 3$
- Conv1-1:$3 \times 3$ 卷积,64 个过滤器,步长 1,填充 1
- Conv1-2:$3 \times 3$ 卷积,64 个过滤器,步长 1,填充 1
- 池化层(Max Pooling):$2 \times 2$,步长 2
计算: $\frac{224 - 3 + 2}{1} + 1 = 224$ $\frac{224 - 2}{2} + 1 = 112$
- 输出尺寸:$112 \times 112 \times 64$
卷积块 2(Conv Block 2)
- 输入尺寸:$112 \times 112 \times 64$
- Conv2-1:$3 \times 3$ 卷积,128 个过滤器
- Conv2-2:$3 \times 3$ 卷积,128 个过滤器
- 池化层:$2 \times 2$,步长 2
- 输出尺寸:$56 \times 56 \times 128$
卷积块 3(Conv Block 3)
- 输入尺寸:$56 \times 56 \times 128$
- Conv3-1:$3 \times 3$ 卷积,256 个过滤器
- Conv3-2:$3 \times 3$ 卷积,256 个过滤器
- Conv3-3:$3 \times 3$ 卷积,256 个过滤器
- 池化层:$2 \times 2$,步长 2
- 输出尺寸:$28 \times 28 \times 256$
卷积块 4(Conv Block 4)
- 输入尺寸:$28 \times 28 \times 256$
- Conv4-1:$3 \times 3$ 卷积,512 个过滤器
- Conv4-2:$3 \times 3$ 卷积,512 个过滤器
- Conv4-3:$3 \times 3$ 卷积,512 个过滤器
- 池化层:$2 \times 2$,步长 2
- 输出尺寸:$14 \times 14 \times 512$
卷积块 5(Conv Block 5)
- 输入尺寸:$14 \times 14 \times 512$
- Conv5-1:$3 \times 3$ 卷积,512 个过滤器
- Conv5-2:$3 \times 3$ 卷积,512 个过滤器
- Conv5-3:$3 \times 3$ 卷积,512 个过滤器
- 池化层:$2 \times 2$,步长 2
- 输出尺寸:$7 \times 7 \times 512$
全连接层(Fully Connected Layers)
-
FC1
- 输入尺寸:$7 \times 7 \times 512 = 25088$
- 神经元数:4096
- 激活函数:ReLU
- Dropout:0.5
-
FC2
- 输入尺寸:4096
- 神经元数:4096
- 激活函数:ReLU
- Dropout:0.5
-
输出层(FC3 + Softmax)
- 输入尺寸:4096
- 输出尺寸:1000(ImageNet 分类)
- 激活函数:Softmax
用图表总结:
| 层次 | 说明 | 输入尺寸 | 输出尺寸 | 过滤器 | 步长 | 填充 | 激活 |
|---|---|---|---|---|---|---|---|
| 输入层 | RGB 图像 | $224 \times 224 \times 3$ | $224 \times 224 \times 3$ | - | - | - | - |
| Conv1-1 | $3 \times 3$ 卷积 | $224 \times 224 \times 3$ | $224 \times 224 \times 64$ | 64 | 1 | 1 | ReLU |
| Conv1-2 | $3 \times 3$ 卷积 | $224 \times 224 \times 64$ | $224 \times 224 \times 64$ | 64 | 1 | 1 | ReLU |
| Pool1 | 最大池化 | $224 \times 224 \times 64$ | $112 \times 112 \times 64$ | $2 \times 2$ | 2 | 0 | - |
| Conv2-1 | $3 \times 3$ 卷积 | $112 \times 112 \times 64$ | $112 \times 112 \times 128$ | 128 | 1 | 1 | ReLU |
| Conv2-2 | $3 \times 3$ 卷积 | $112 \times 112 \times 128$ | $112 \times 112 \times 128$ | 128 | 1 | 1 | ReLU |
| Pool2 | 最大池化 | $112 \times 112 \times 128$ | $56 \times 56 \times 128$ | $2 \times 2$ | 2 | 0 | - |
(后续层类同)
输入图像:$224 \times 224 \times 3$ RGB图,3个通道 训练参数:约138,000,000个
特点:
- 所有卷积层 filter 宽和高都是 3,步长为 1,填充为 1(“same”卷积),保持每一次卷积后的空间尺寸不变
- 所有池化层的filter宽和高都是 2,步长都是2
- 相比AlexNet,有更多的filter用于提取轮廓信息,具有更高精准性
使用经典CNN模型面对新场景
我们如何利用这些已经被验证表现非常出色的经典CNN模型来面对新场景呢?
-
使用经典的CNN模型结构对图像预处理,再建立MLP模型(最常用):
- 加载经典的CNN模型,剥除其FC层(全连阶层),对图像进行预处理
- 把预处理完成的数据作为输入,分类结果为输出,建立一个MLP模型
- 模型训练
-
参考经典的CNN结构搭建新模型: 从前文所述两个模型我们可以看出卷积和池化放在一起的效果一般都挺好的,所以在新模型中我们也可以把卷积和池化放在一起,那主要问题就会变为如何微调参数,比如过滤器的尺寸这类的。
我们以前者举个例子:
假如我现在需要在VGG16模型基础上,对猫狗的照片进行二分类识别,我会怎么构建二分类模型呢?
- 删去原本模型中MLP部分
- 保留VGG16前面提取图片特征的部分
- 自己训练MLP模型