8.4 String类型 Pt.2:字节、标量值、字形簇以及字符串的各类操作
8.4.0. 本章内容
第八章主要讲的是 Rust 中常见的集合。Rust 提供了很多集合类型的数据结构,这些集合可以包含很多值。但是第八章所讲的集合与数组和元组有所不同。
第八章中的集合是存储在堆内存上而非栈内存上的,这也意味着这些集合的数据大小无需在编译时就确定,在运行时它们可以动态地变大或变小。
本章主要会讲三种集合:Vector、String(本文) 和 HashMap。
8.4.1. 不能使用索引来访问 String
Rust 中的 String 不同于其他语言:不能用索引访问。如下例:
fn main() {
    let s = String::from("6657 up up");
    let a = s[0];
}
输出:
error[E0277]: the type `str` cannot be indexed by `{integer}`
 --> src/main.rs:3:15
  |
3 |     let a = s[0];
  |               ^ string indices are ranges of `usize`
  |
  = help: the trait `SliceIndex<str>` is not implemented for `{integer}`
  = note: you can use `.chars().nth()` or `.bytes().nth()`
          for more information, see chapter 8 in The Book: <https://doc.rust-lang.org/book/ch08-02-strings.html#indexing-into-strings>
  = note: required for `String` to implement `Index<{integer}>`
报错说明:String 类型无法使用整数来进行索引。继续往下看可以看到,String 没有实现 Index<{integer}> 这个 trait。
8.4.2. String 类型的内部表示
String 是对 Vec<u8> 的包装,其中 u8 表示字节。我们可以通过 String 上的 len() 方法来返回字符串的长度。如下例:
fn main() {
    let len = String::from("Niko").len();
    println!("{}", len);
}
输出:
4
这个字符串采用的是 UTF-8 编码,len 的值为 4,也就是这个字符串占了 4 个字节。所以在这个例子里,每个字母占用了一个字节。
但情况并不总是这样。比如说我们把字符串换成其他语言(这里是西里尔字母写的俄语):
fn main() {
    let hello = String::from("Здравствуйте");
    println!("{}", hello.len());
}
如果你数一下这个字符串,会发现有 12 个字母,但是输出却是:
24
也就是说在这个语言里面一个字母会占用两个字节(中文是一个汉字占三个字节)。这里所说的“字母”,用专业术语表示就是 Unicode 标量值,而这里的每个西里尔字母都对应两个字节。
通过这个例子你可以发现:对 String 做数字索引,并不总能对应到一个完整的 Unicode 标量值,因为有的标量值会占不止一个字节,而数字索引一次只能读到一个字节。
再举个例子:西里尔字母 З 对应两个字节,这两个字节的值分别是 208 和 151。假如数字索引是允许的,那么取 Здравствуйте 的索引 0 就会得到 208,而单独的 208 是没有意义的,因为它缺少组成一个 Unicode 标量值所需的第二个字节。所以为了避免这种无法立即发现的 bug,Rust 禁止了对 String 使用数字索引,从而在开发早期就杜绝可能的误解。
8.4.3. 字节、标量值、字形簇
Rust 中有三种看待字符串的方式:字节、标量值和字形簇。其中字形簇最接近我们通常所说的“字母”。
1. 字节
看个例子:
fn main() {
    let s = String::from("नमस्ते");  // 天城文书写的印地语
    for b in s.bytes() {
        print!("{} ", b);
    }
}
这段天城文字符串看起来好像有 4 个字母。我们使用 .bytes() 方法来获得它所对应的字节。输出如下:
224 164 168 224 164 174 224 164 184 224 165 141 224 164 164 224 165 135
这 18 个字节就是计算机存储该字符串的样子。
2. 标量值
我们再来以 Unicode 标量值的形式来看待它:
fn main() {
    let s = String::from("नमस्ते");
    for b in s.chars() {
        print!("{} ", b);
    }
}
使用 .chars() 方法能够获得这段字符串所对应的标量值。 输出如下:
न म स ् त े
它有 6 个标量值,其中有些是组合标记,而不是独立的字母。它们只有和前面的字符组合在一起才有意义。
这也解释了为什么这段天城文字符串占 18 个字节:6 个标量值每个占 3 个字节,6 × 3 = 18 个字节。
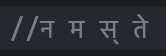
3. 字形簇
因为从 String 里获得字形簇很复杂,所以 Rust 标准库没有提供这个功能,这里也就不做演示;但你可以从 crates.io 找第三方 crate 来实现这个功能。
总之,如果这串字符串以字形簇的形式打印出来,会是这样:
8.4.4. 为什么 String 不能被索引
- 数字索引取出来的值可能并不完整,无法组成一个完整的 Unicode 标量值,从而导致无法第一时间察觉的错误。
- 索引操作理应消耗常量时间,也就是
O(1),而String无法保证这一点:要找到第 n 个字符,必须从字符串开头向后扫描,因为每个字符占用的字节数可变。
8.4.5. 切割 String
可以使用 [],在里面填上范围来创建字符串切片。关于字符串切片的详细内容,见 4.5. 切片(Slice)。如下例:
fn main() {
    let hello = String::from("Здравствуйте");
    let s = &hello[0..4];
    println!("{}", s);
}
刚才也说了,一个西里尔字母占两个字节。这里的字符串切片切的是字符串的前 4 个字节,也就是前两个字母。输出是:
Зд
那如果字符串切片切的是前三个字节呢?也就意味着切片的内容会是第一个字母加上半个第二个字母。这种情况会怎么样呢?看下面的例子:
fn main() {
    let hello = String::from("Здравствуйте");
    let s = &hello[0..3];
    println!("{}", s);
}
输出:
thread 'main' panicked at src/main.rs:3:19:
end byte index 3 is not a char boundary; it is inside 'д' (bytes 2..4 of string)
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
程序触发了 panic!,错误信息是:结束字节索引 3 不是一个 char 边界。也就是说,切割时必须沿着 char 的边界来切割;对于西里尔字母来说,就是按两个字节为单位切割。
8.4.6. 遍历 String
- 对于标量值,使用
.chars()方法。如下例:
fn main() {
    let s = String::from("नमस्ते");
    for b in s.chars() {
        print!("{} ", b);
    }
}- 对于字节,使用
.bytes()方法。如下例:
fn main() {
    let s = String::from("नमस्ते");
    for b in s.bytes() {
        print!("{} ", b);
    }
}- 对于字形簇,标准库未提供方法,但可以使用第三方 crate。